Alder Lake SoC深度解析:Intel的大小核未来梦

昨晚Intel举办了今年的架构日活动,和往年一样,Intel在架构日活动上会公布很多自家未来芯片设计方面的细节,比如说即将发布的CPU/GPU架构,新的内核设计和一些新的技术,今年的Intel架构日活动上他们带来了下一代处理器,也就是Alder Lake的详细内容。

Alder Lake简介

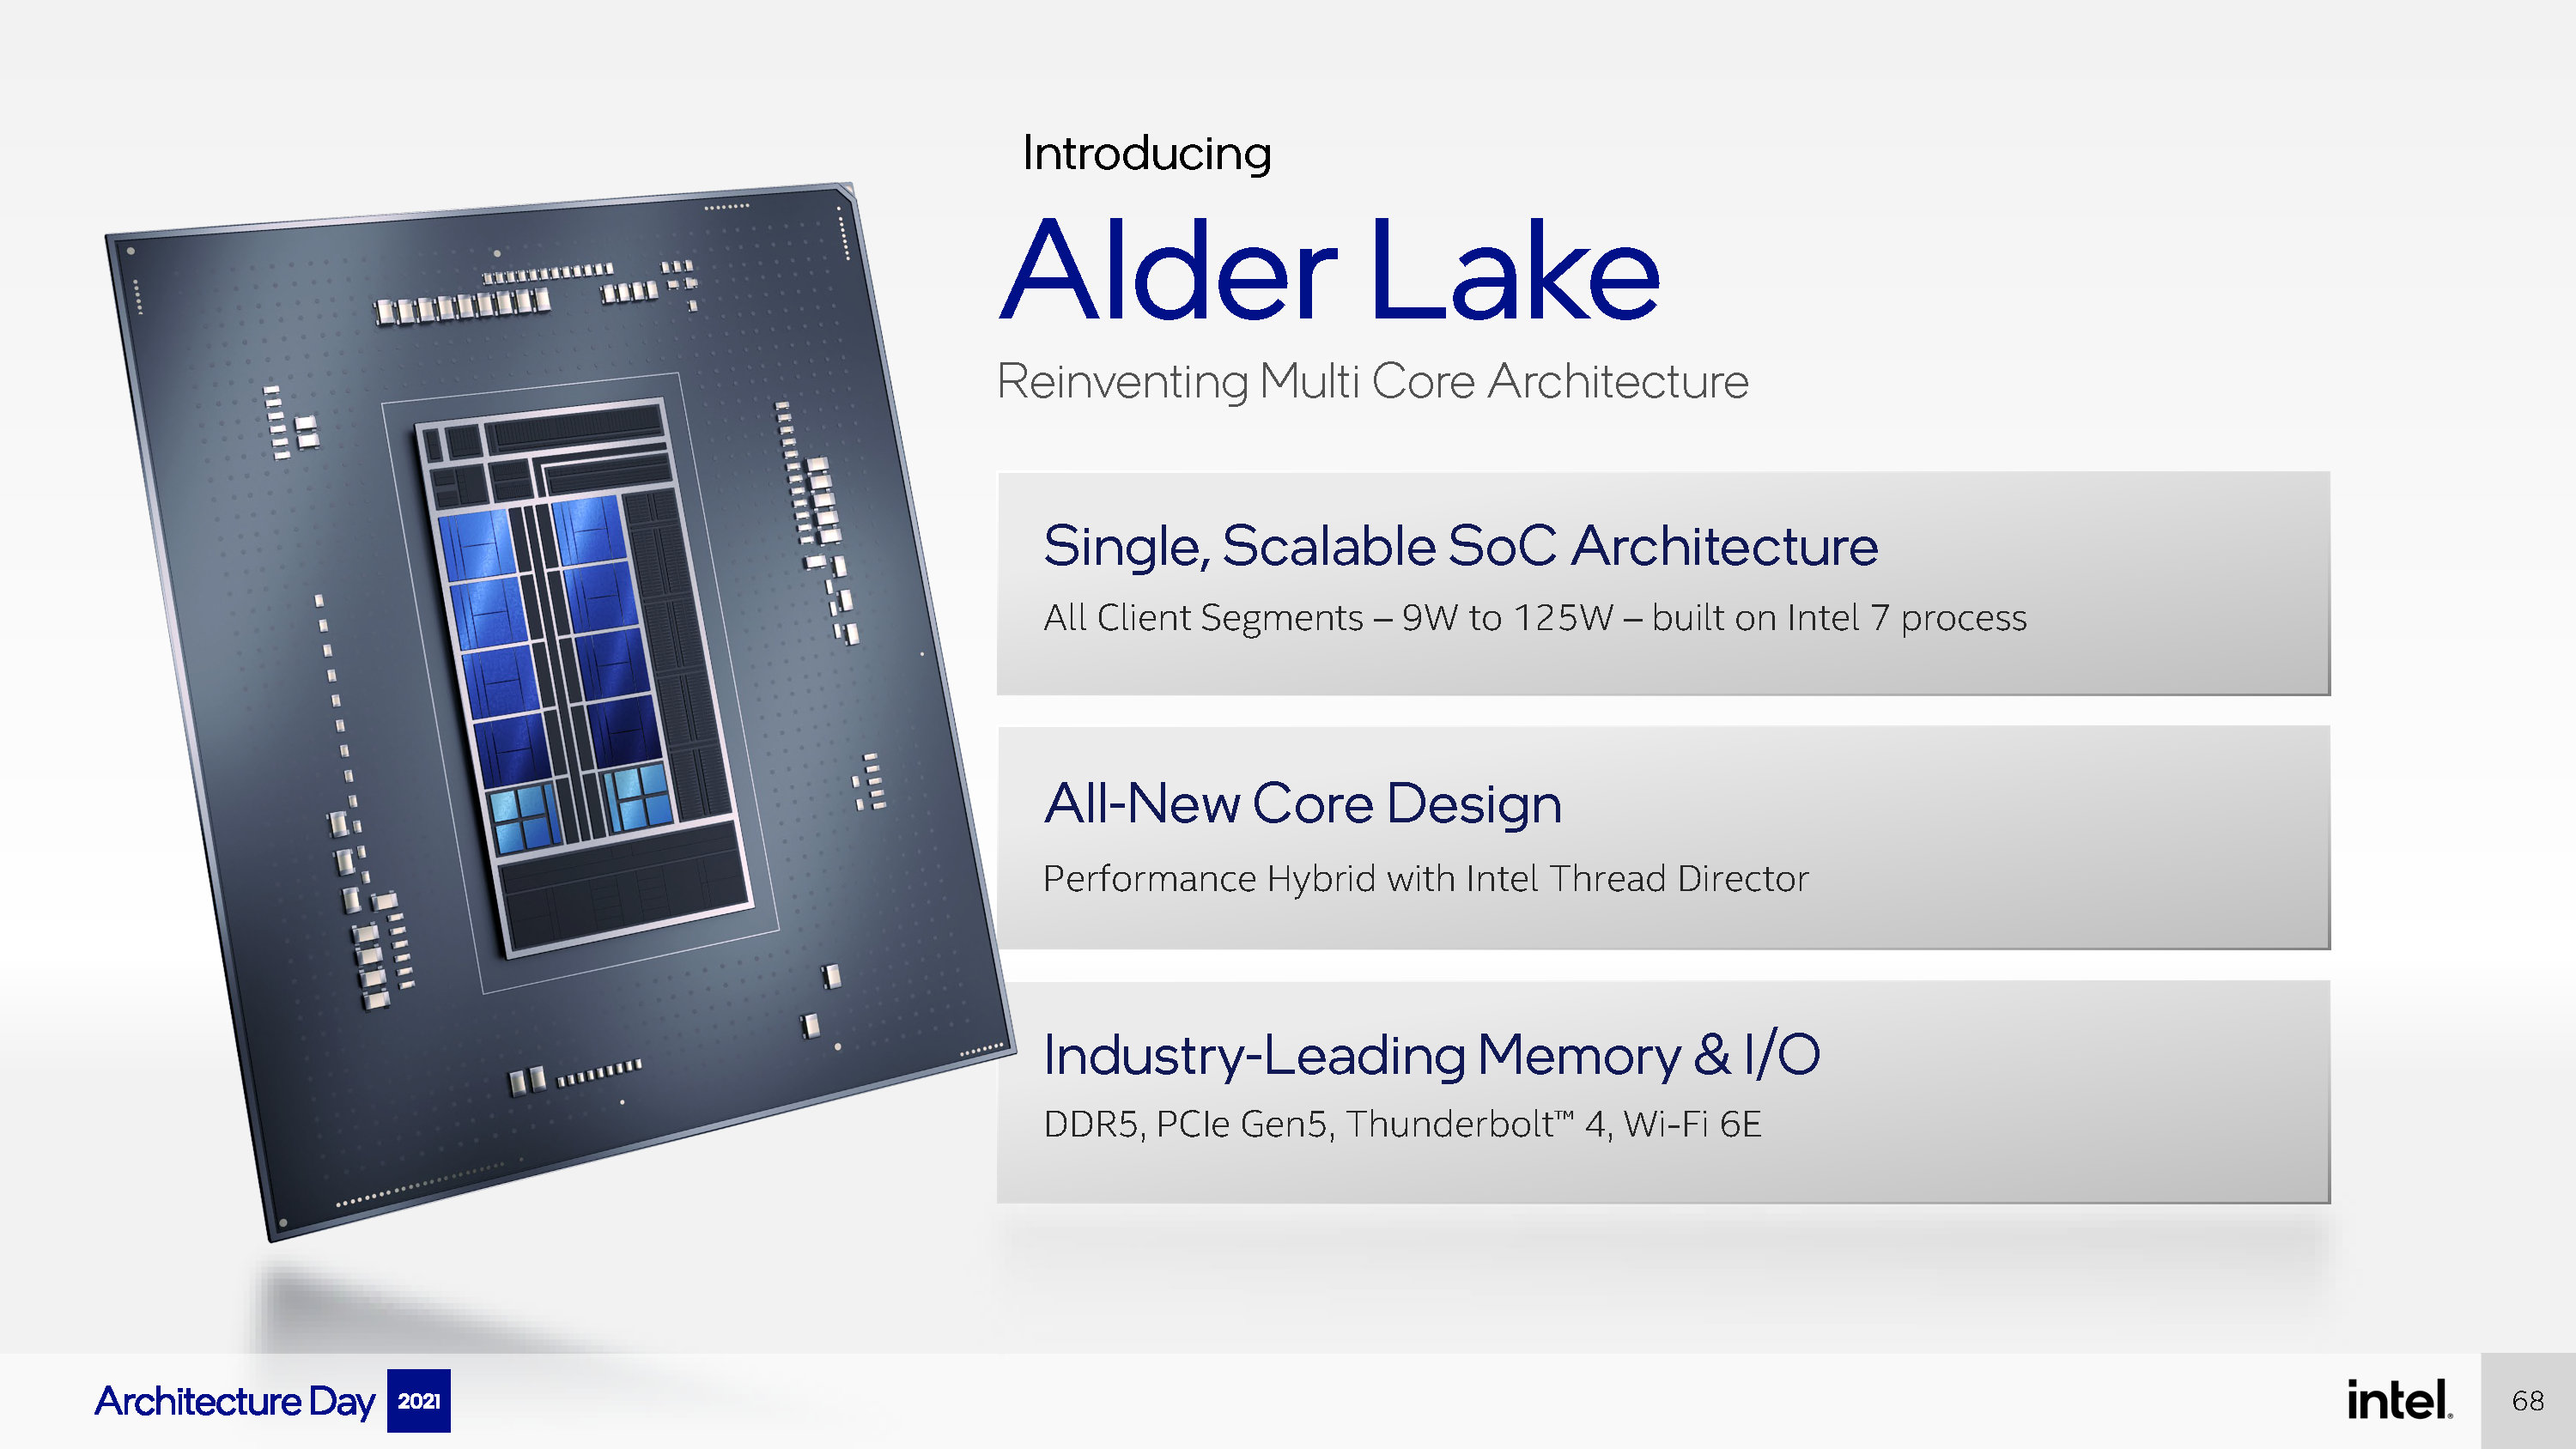
Alder Lake是Intel耗时多年打造的一款全新架构,它是未来将要发布的第12代酷睿处理器的核心。

/>

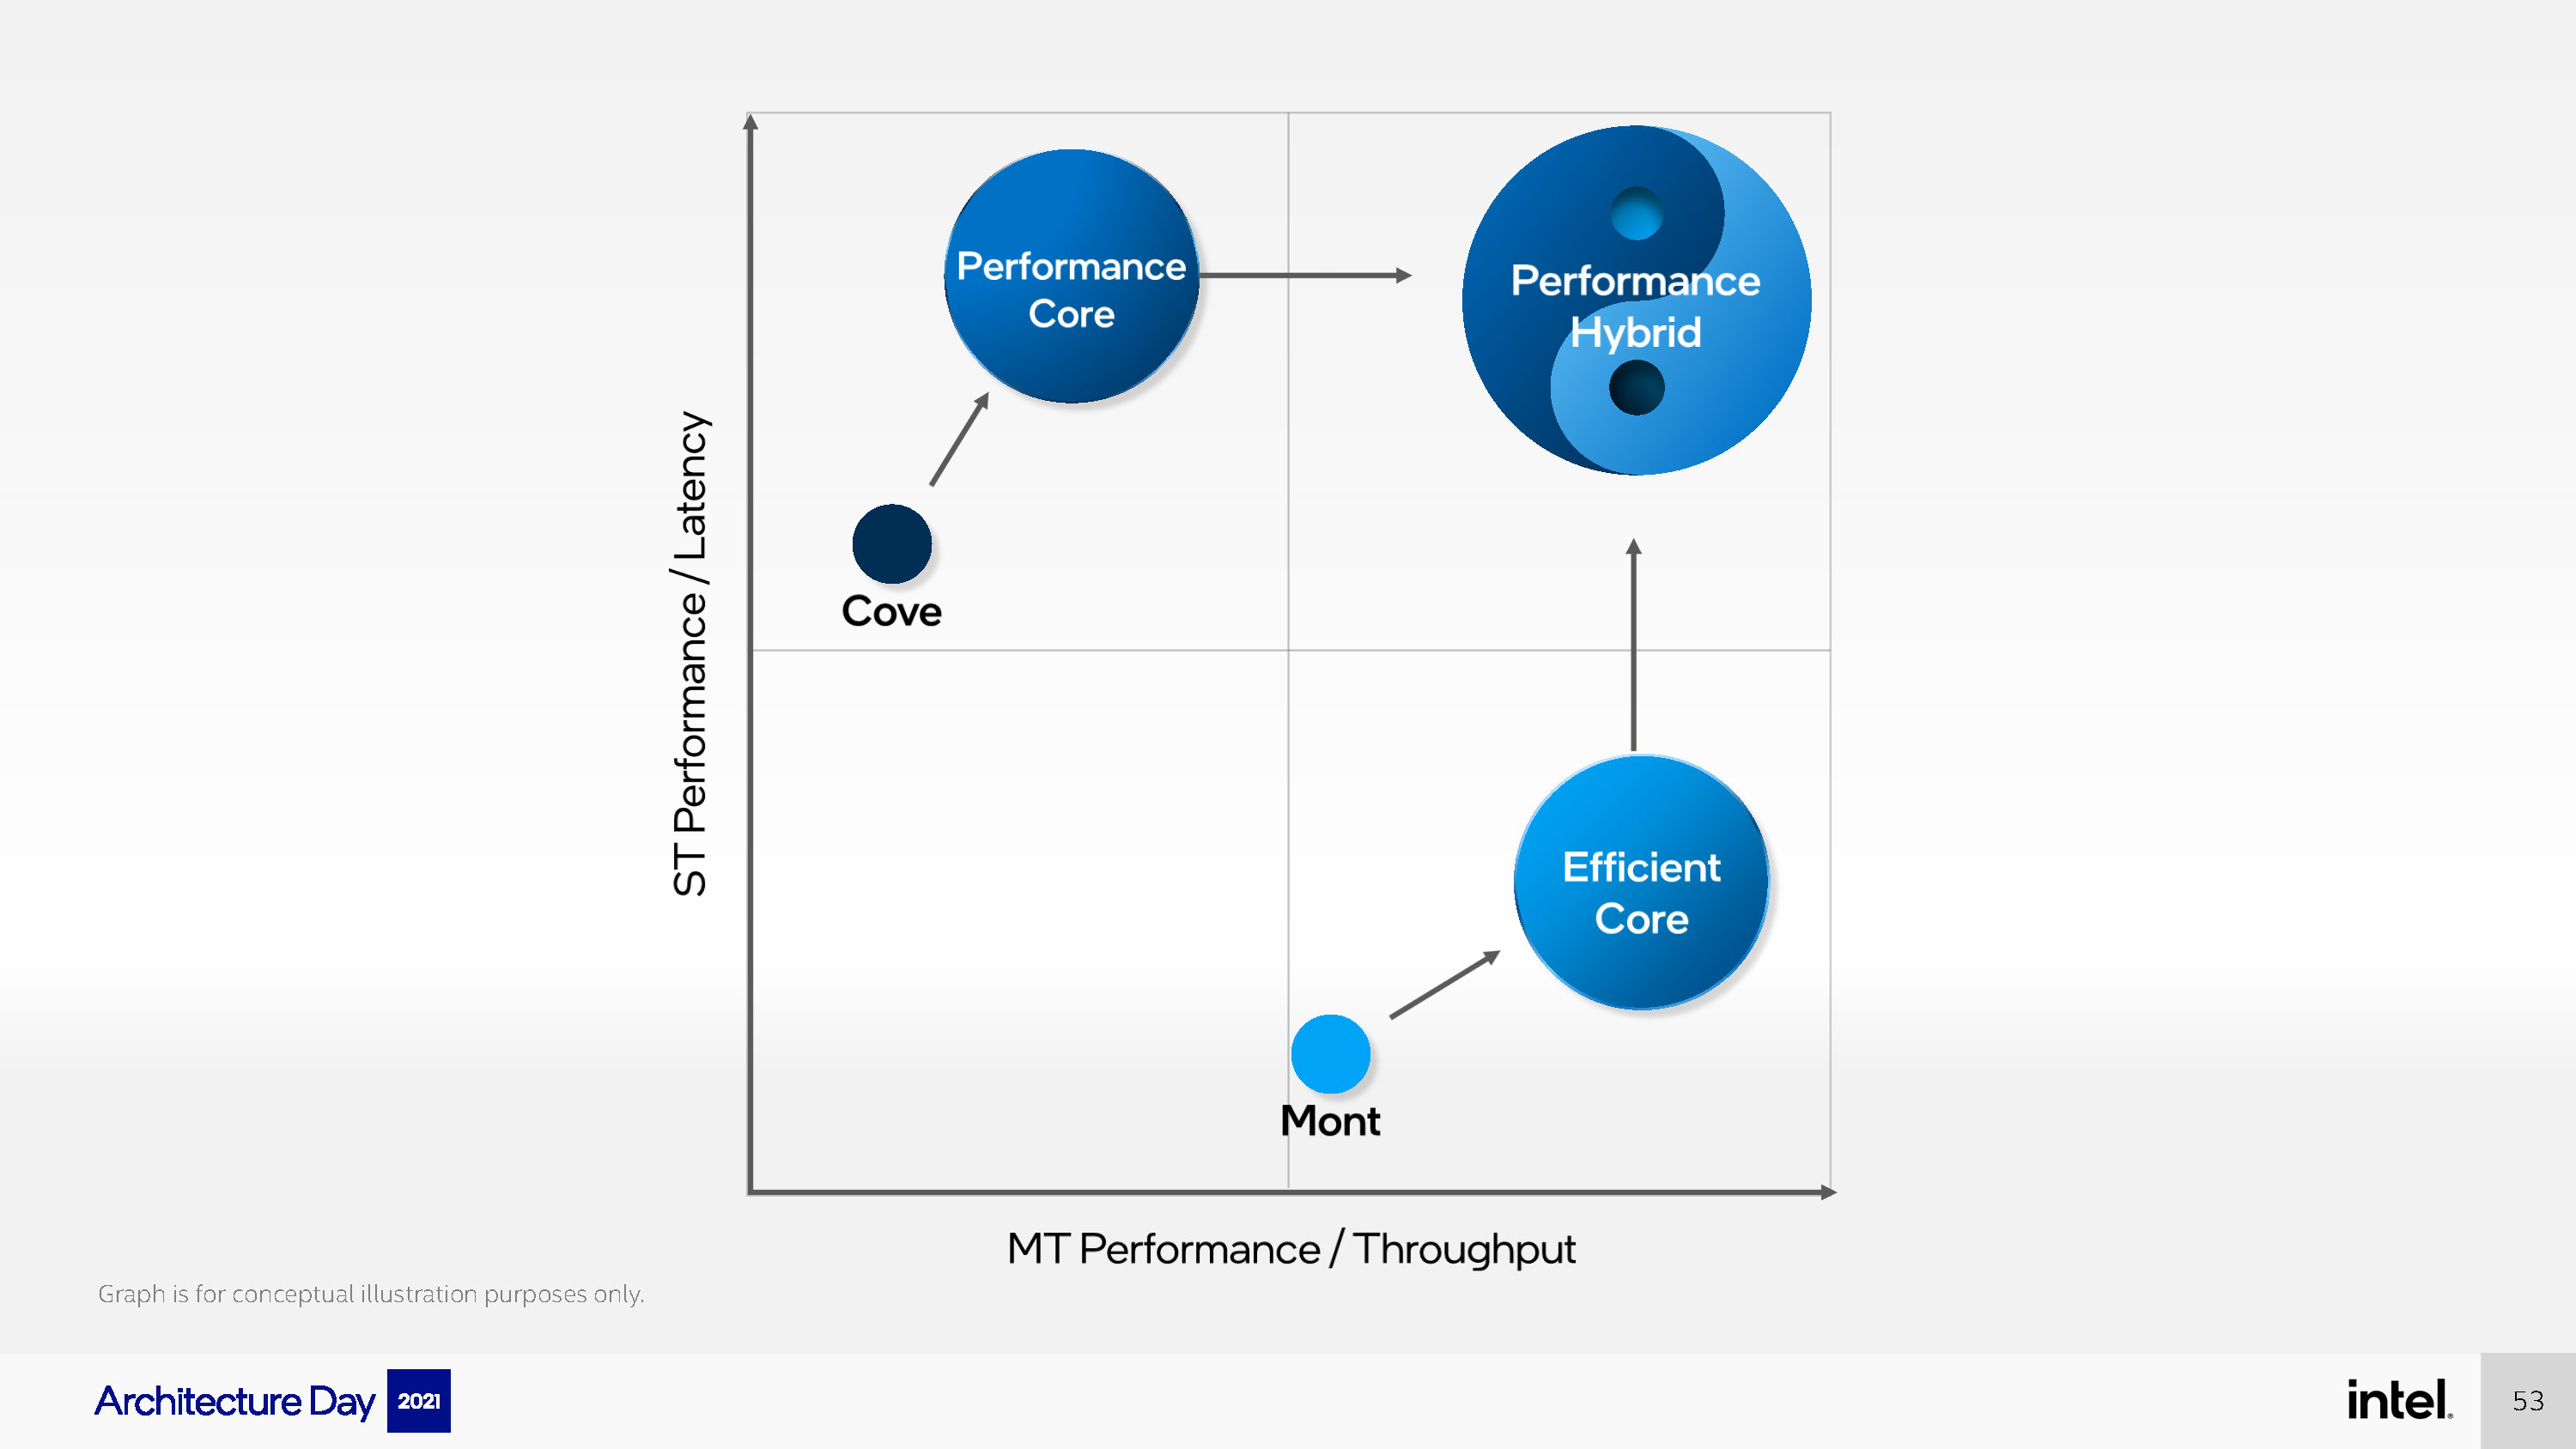
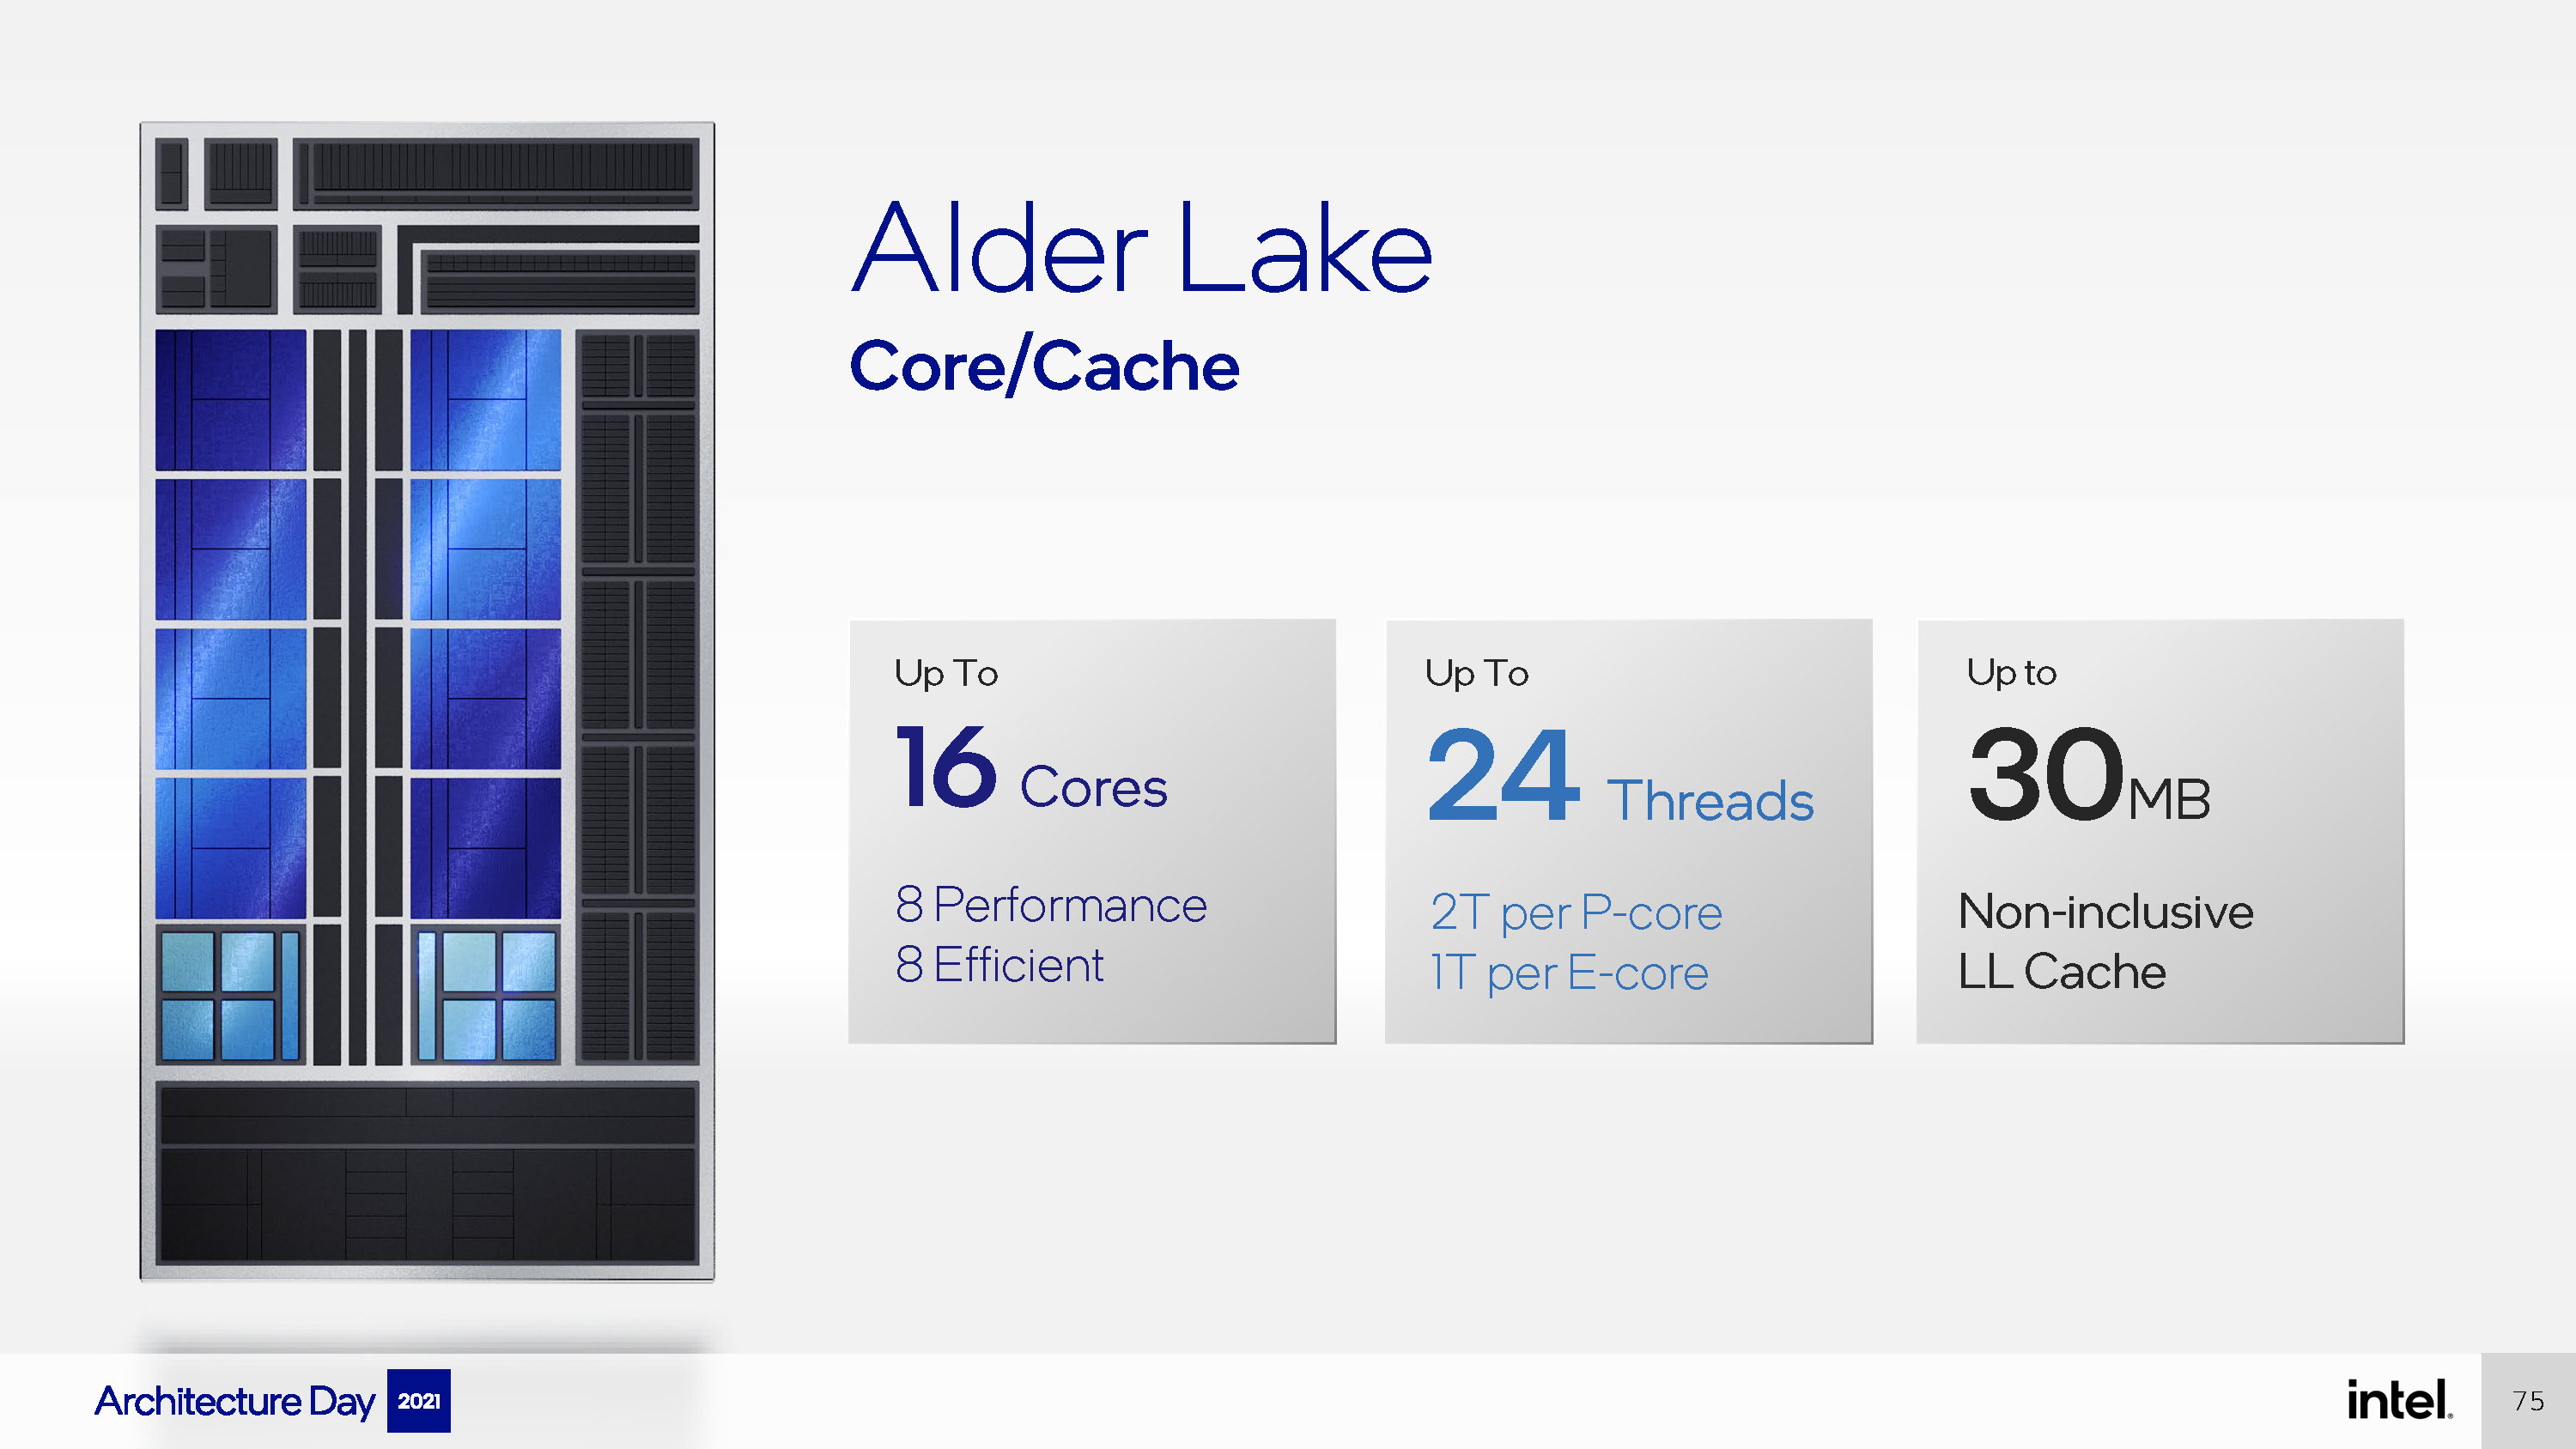
和以往的Intel处理器架构一样,Alder Lake包含了CPU、GPU、内存控制器、IO、显示输出和AI加速器等部件。它也是Intel首个采用大小核设计的高性能处理器,改动主要有以下几点:

  • CPU部分采用大小核混合计算架构,最高由8大核8小核组成16核24线程
  • CPU大核升级到Golden Cove架构,IPC提升约19%
  • CPU小核升级到Gracemont架构,性能接近Skylake,能效比很高
  • 采用Intel 7工艺制程,频率相较于10nm SuperFin工艺会有进一步提升
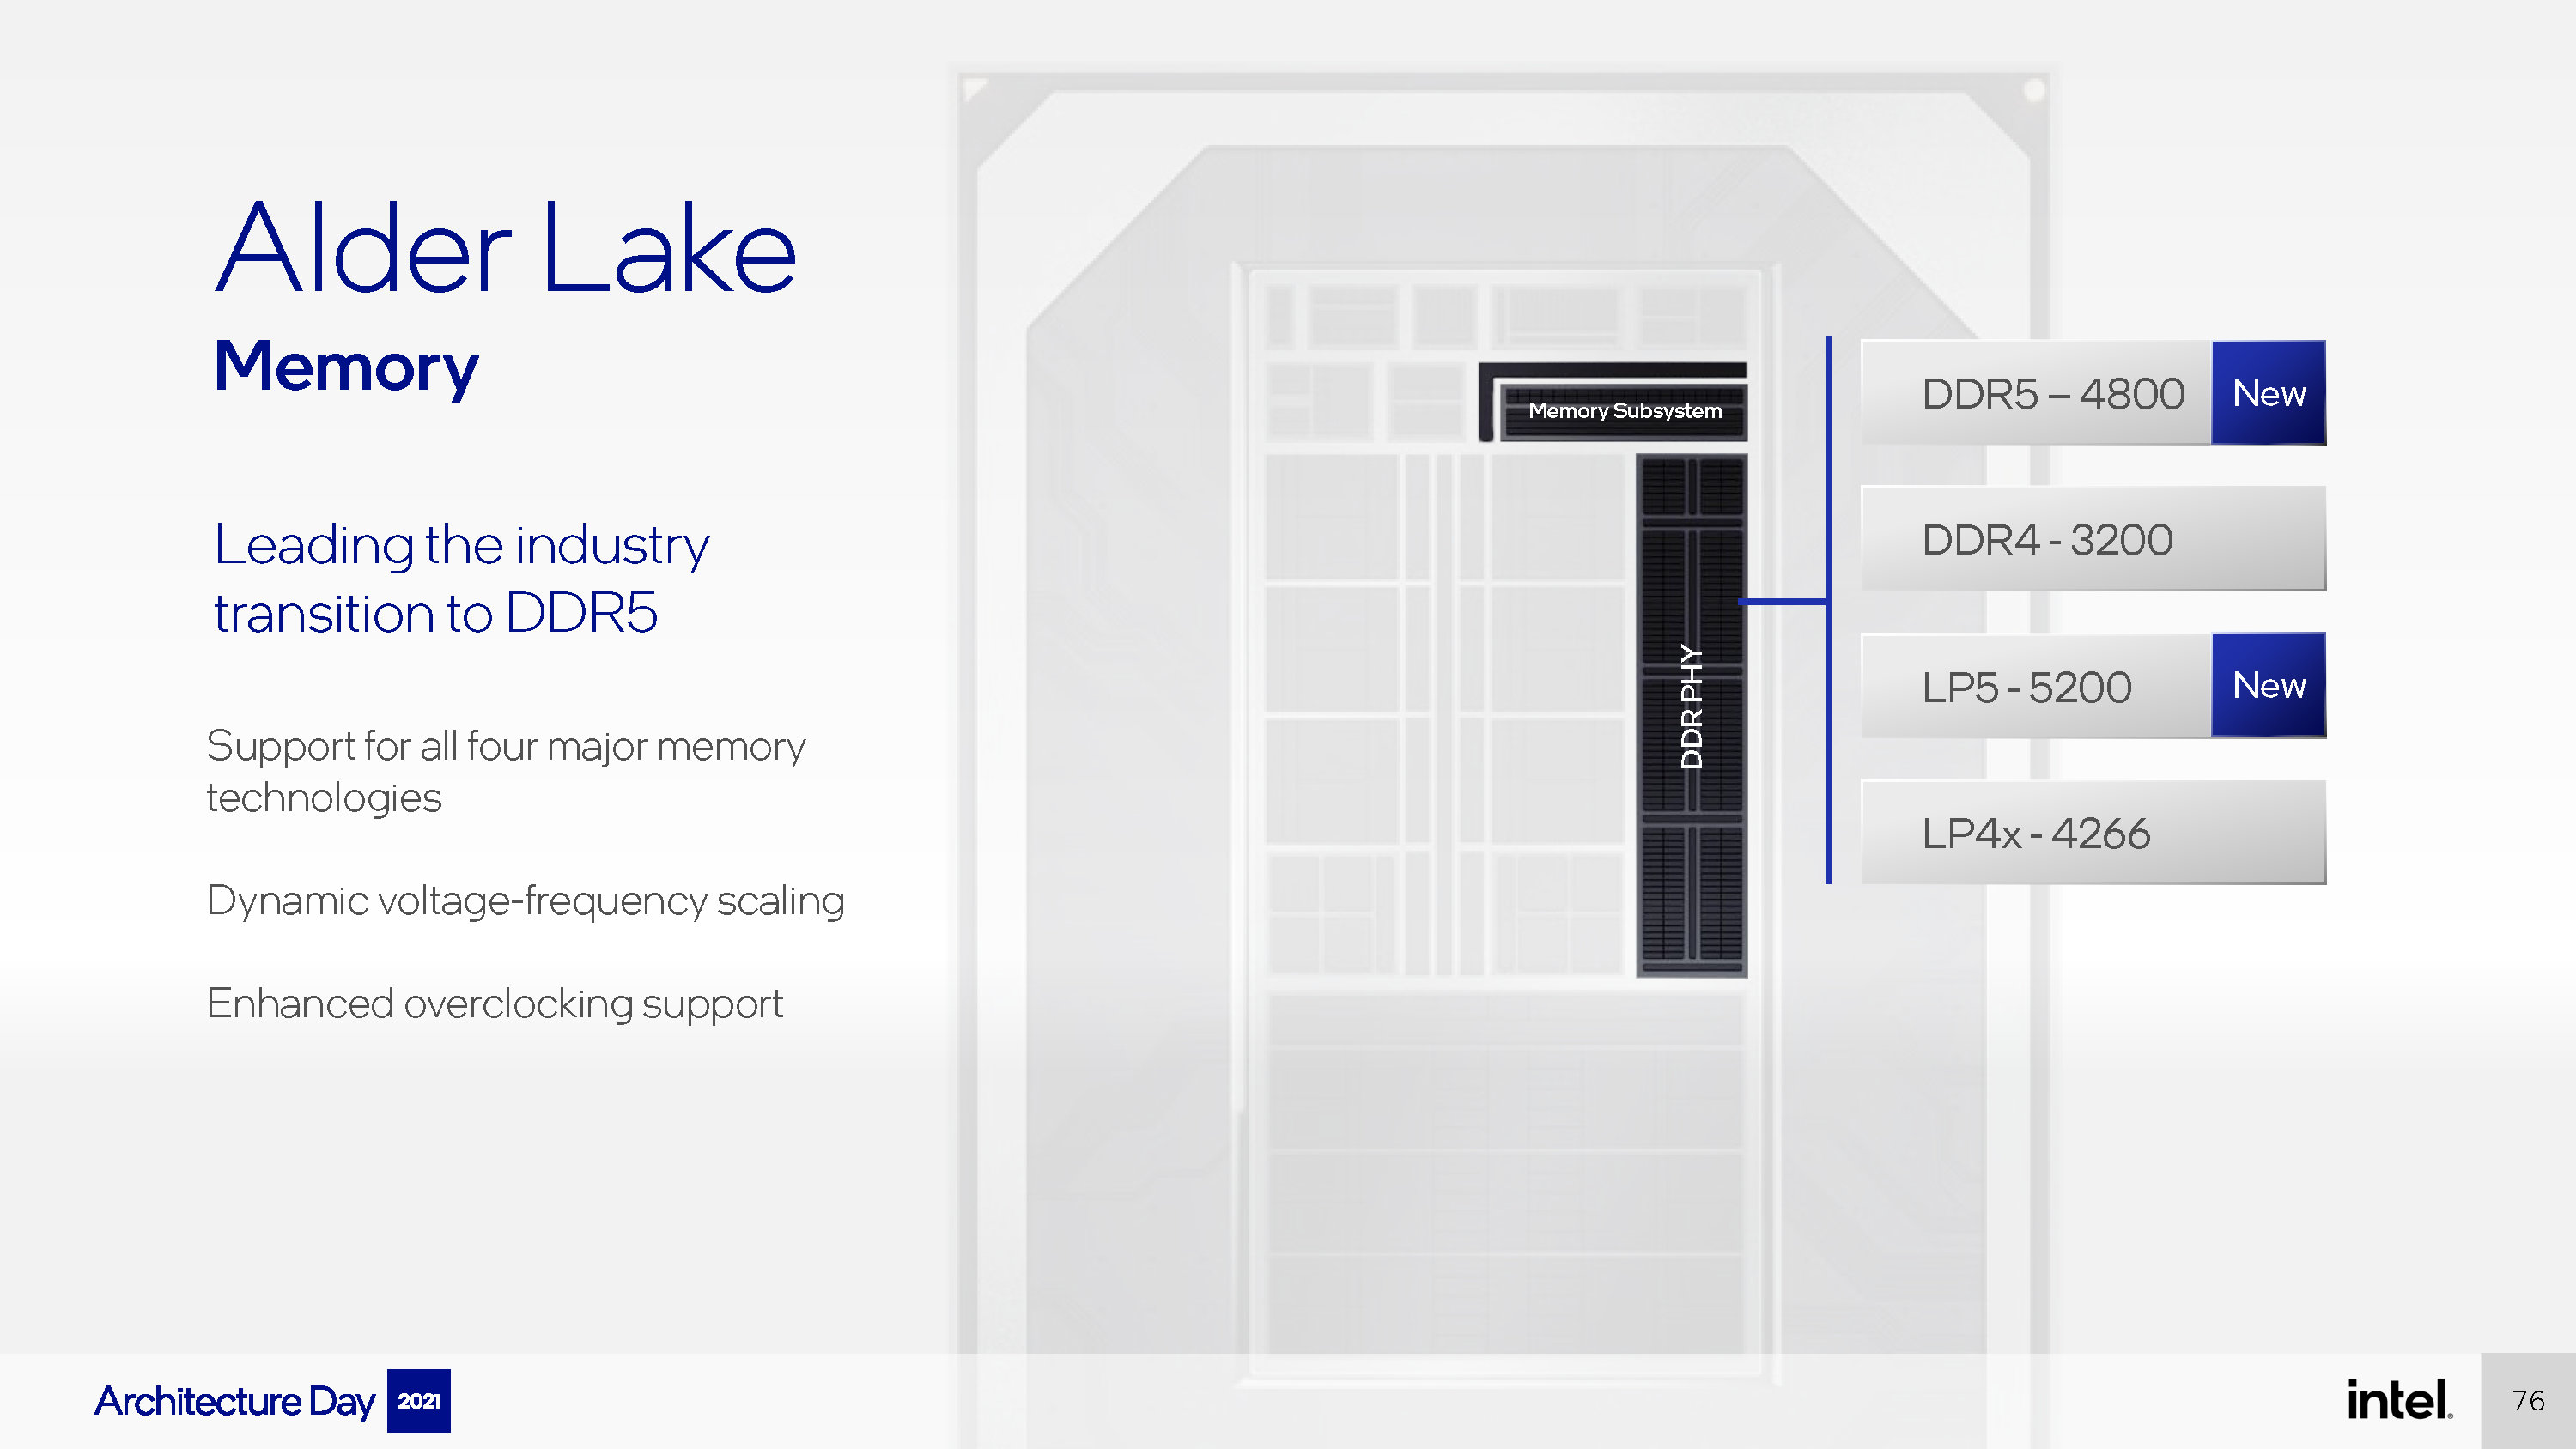
  • 内存控制器升级支持DDR5和LPDDR5内存
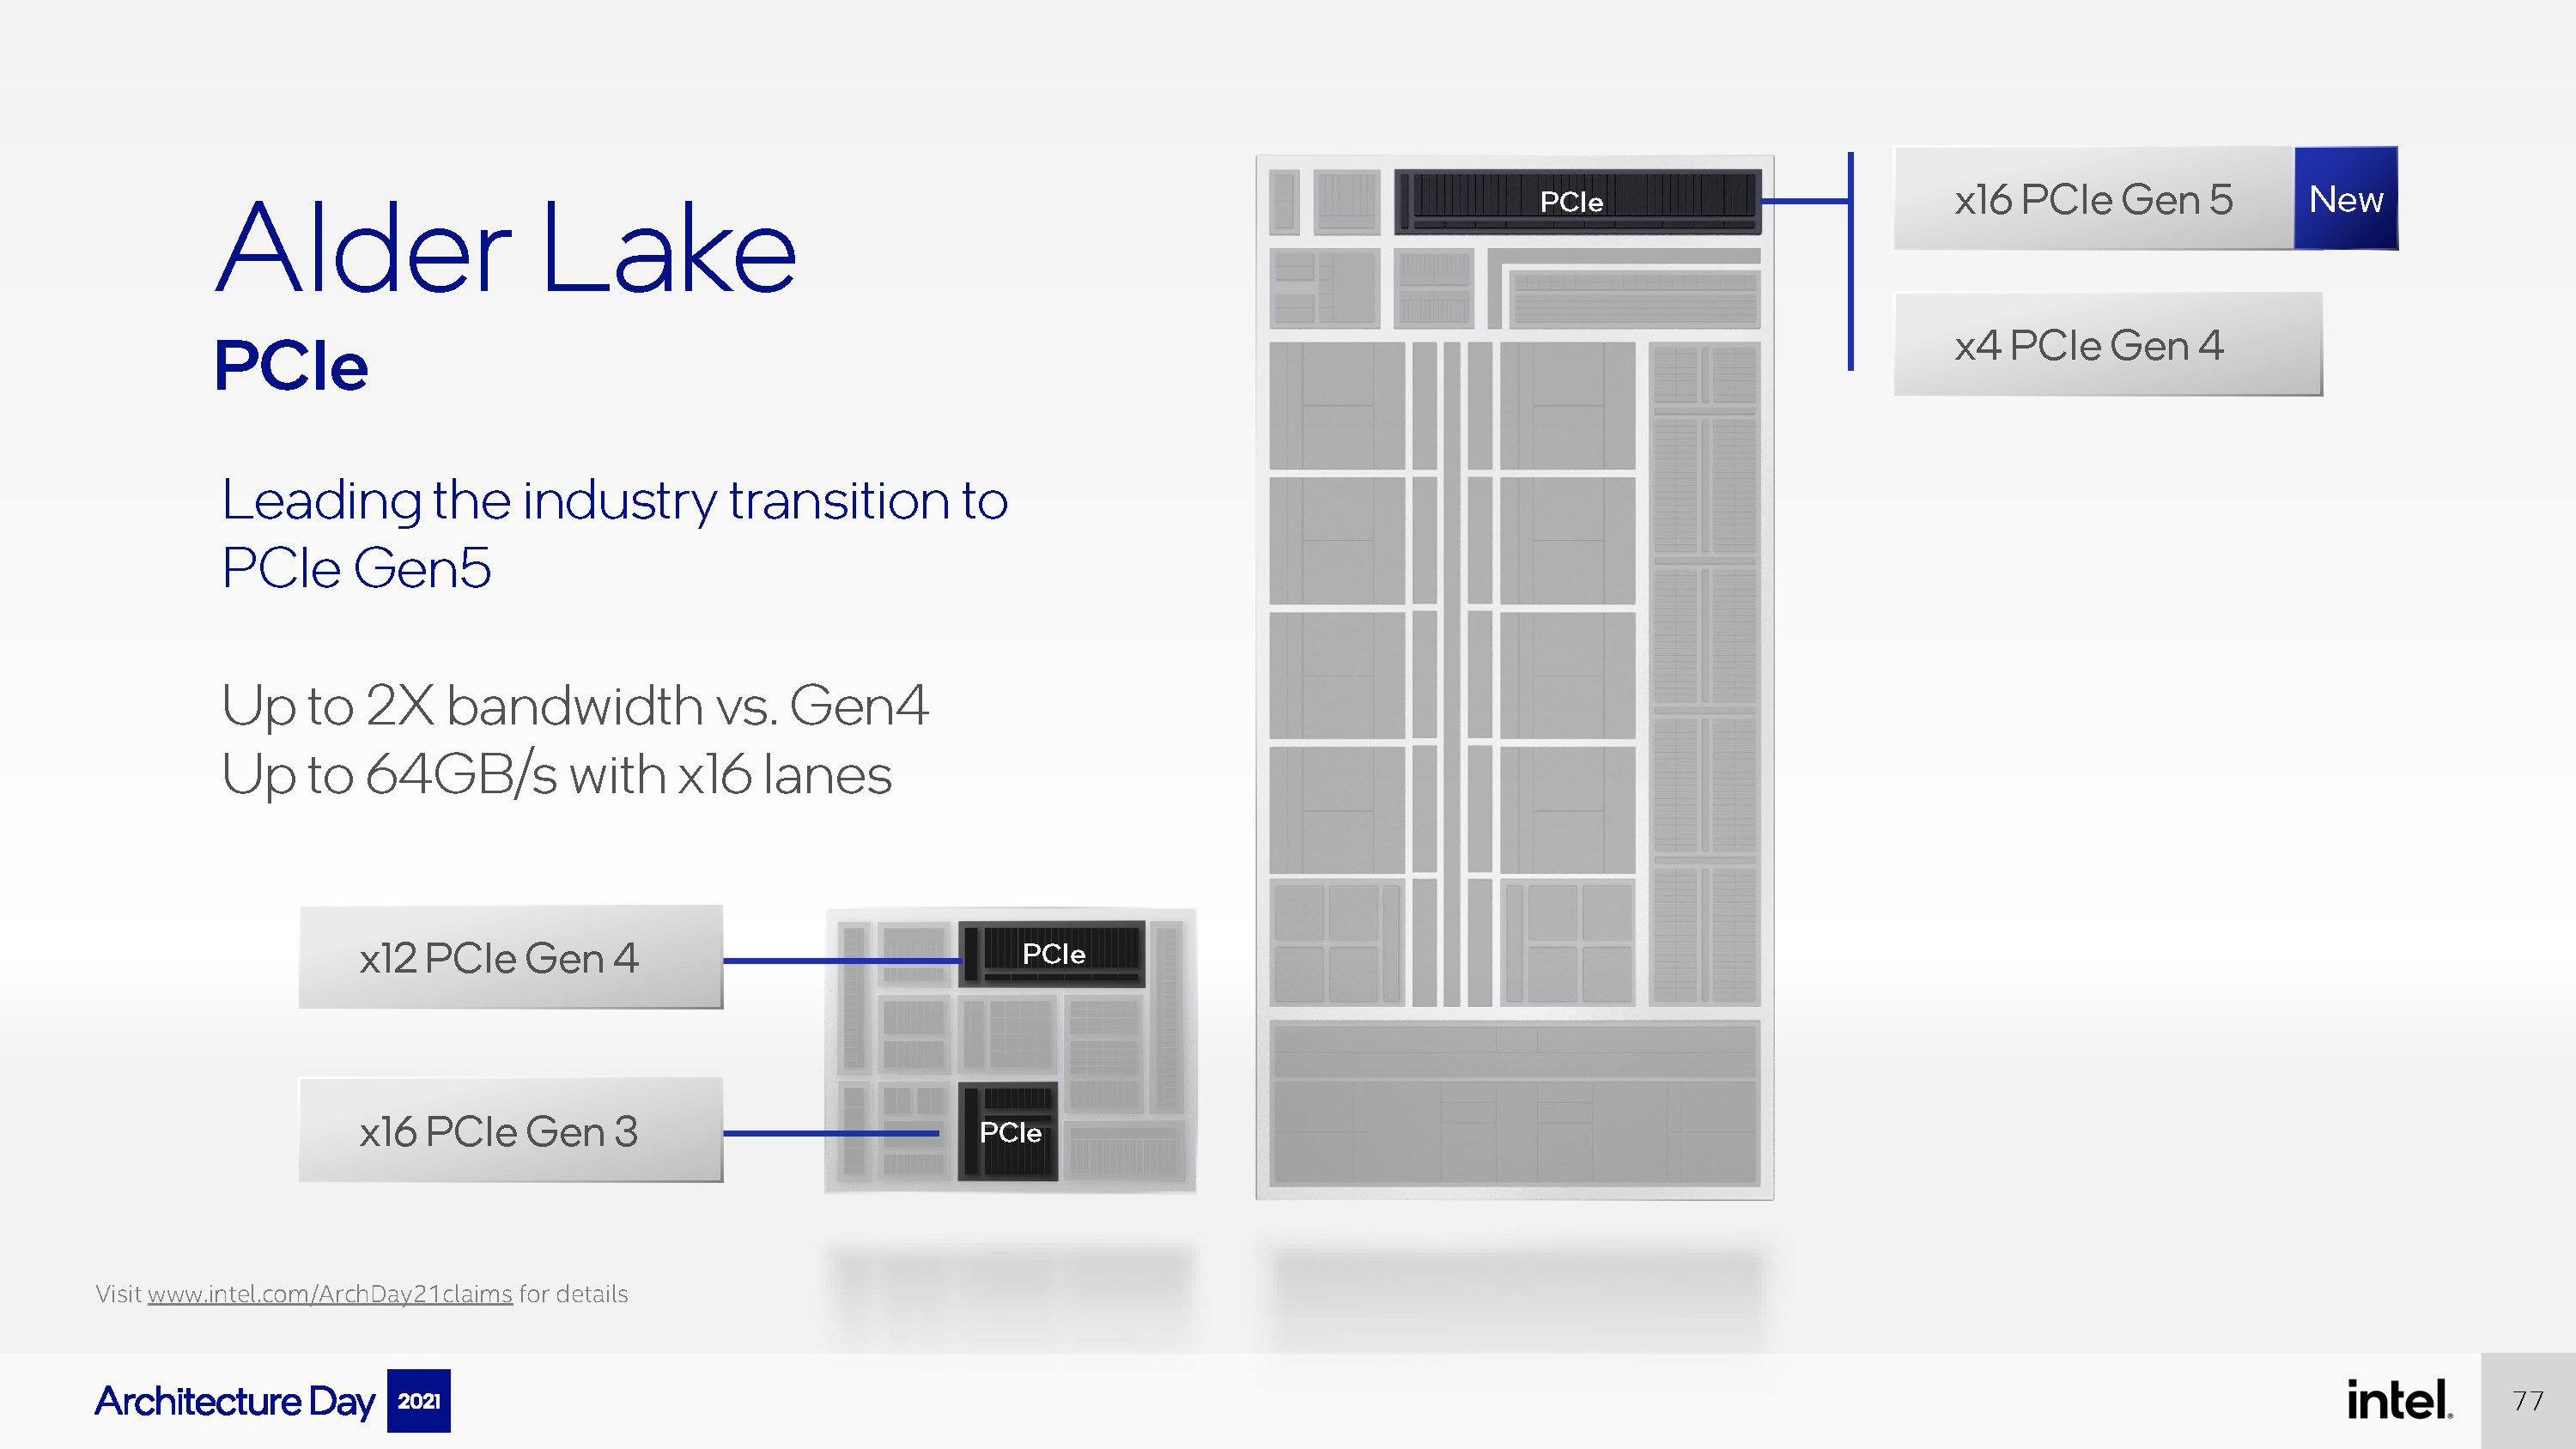
  • PCIe升级到5.0版本

让我们一点点来看Alder Lake的进化。

x86大小核异构

Alder Lake上最大的变化点便是它采用大小核异构的架构,此前Intel曾在Lakefield上试水大小核异构,并推出了两款正式产品,不过它们都是低功耗处理器,性能不强。因此Alder Lake可以说是首款大小核异构设计的高性能x86处理器,在继承Lakefield的大小核异构设计之上,进行了深度改进。首先来看被Intel称为效率核心(E-Core)的Gracemont。

E-Core:整体性能接近Skylake、但能耗更低的Gracemont

在大小核异构设计中,一般小核的设计目标是高能效比,而大核的目标则是提供极限高性能,Gracemont便是一个非常高效的核心。Intel的小核心设计是独立于大核心的另外一条线,现在一般称为Atom核心。一脉相传下来,Gracemont的上代是Tremont。从Tremont到Gracemont,Intel着重加强了小核心的后端执行能力,尤其是整数性能。

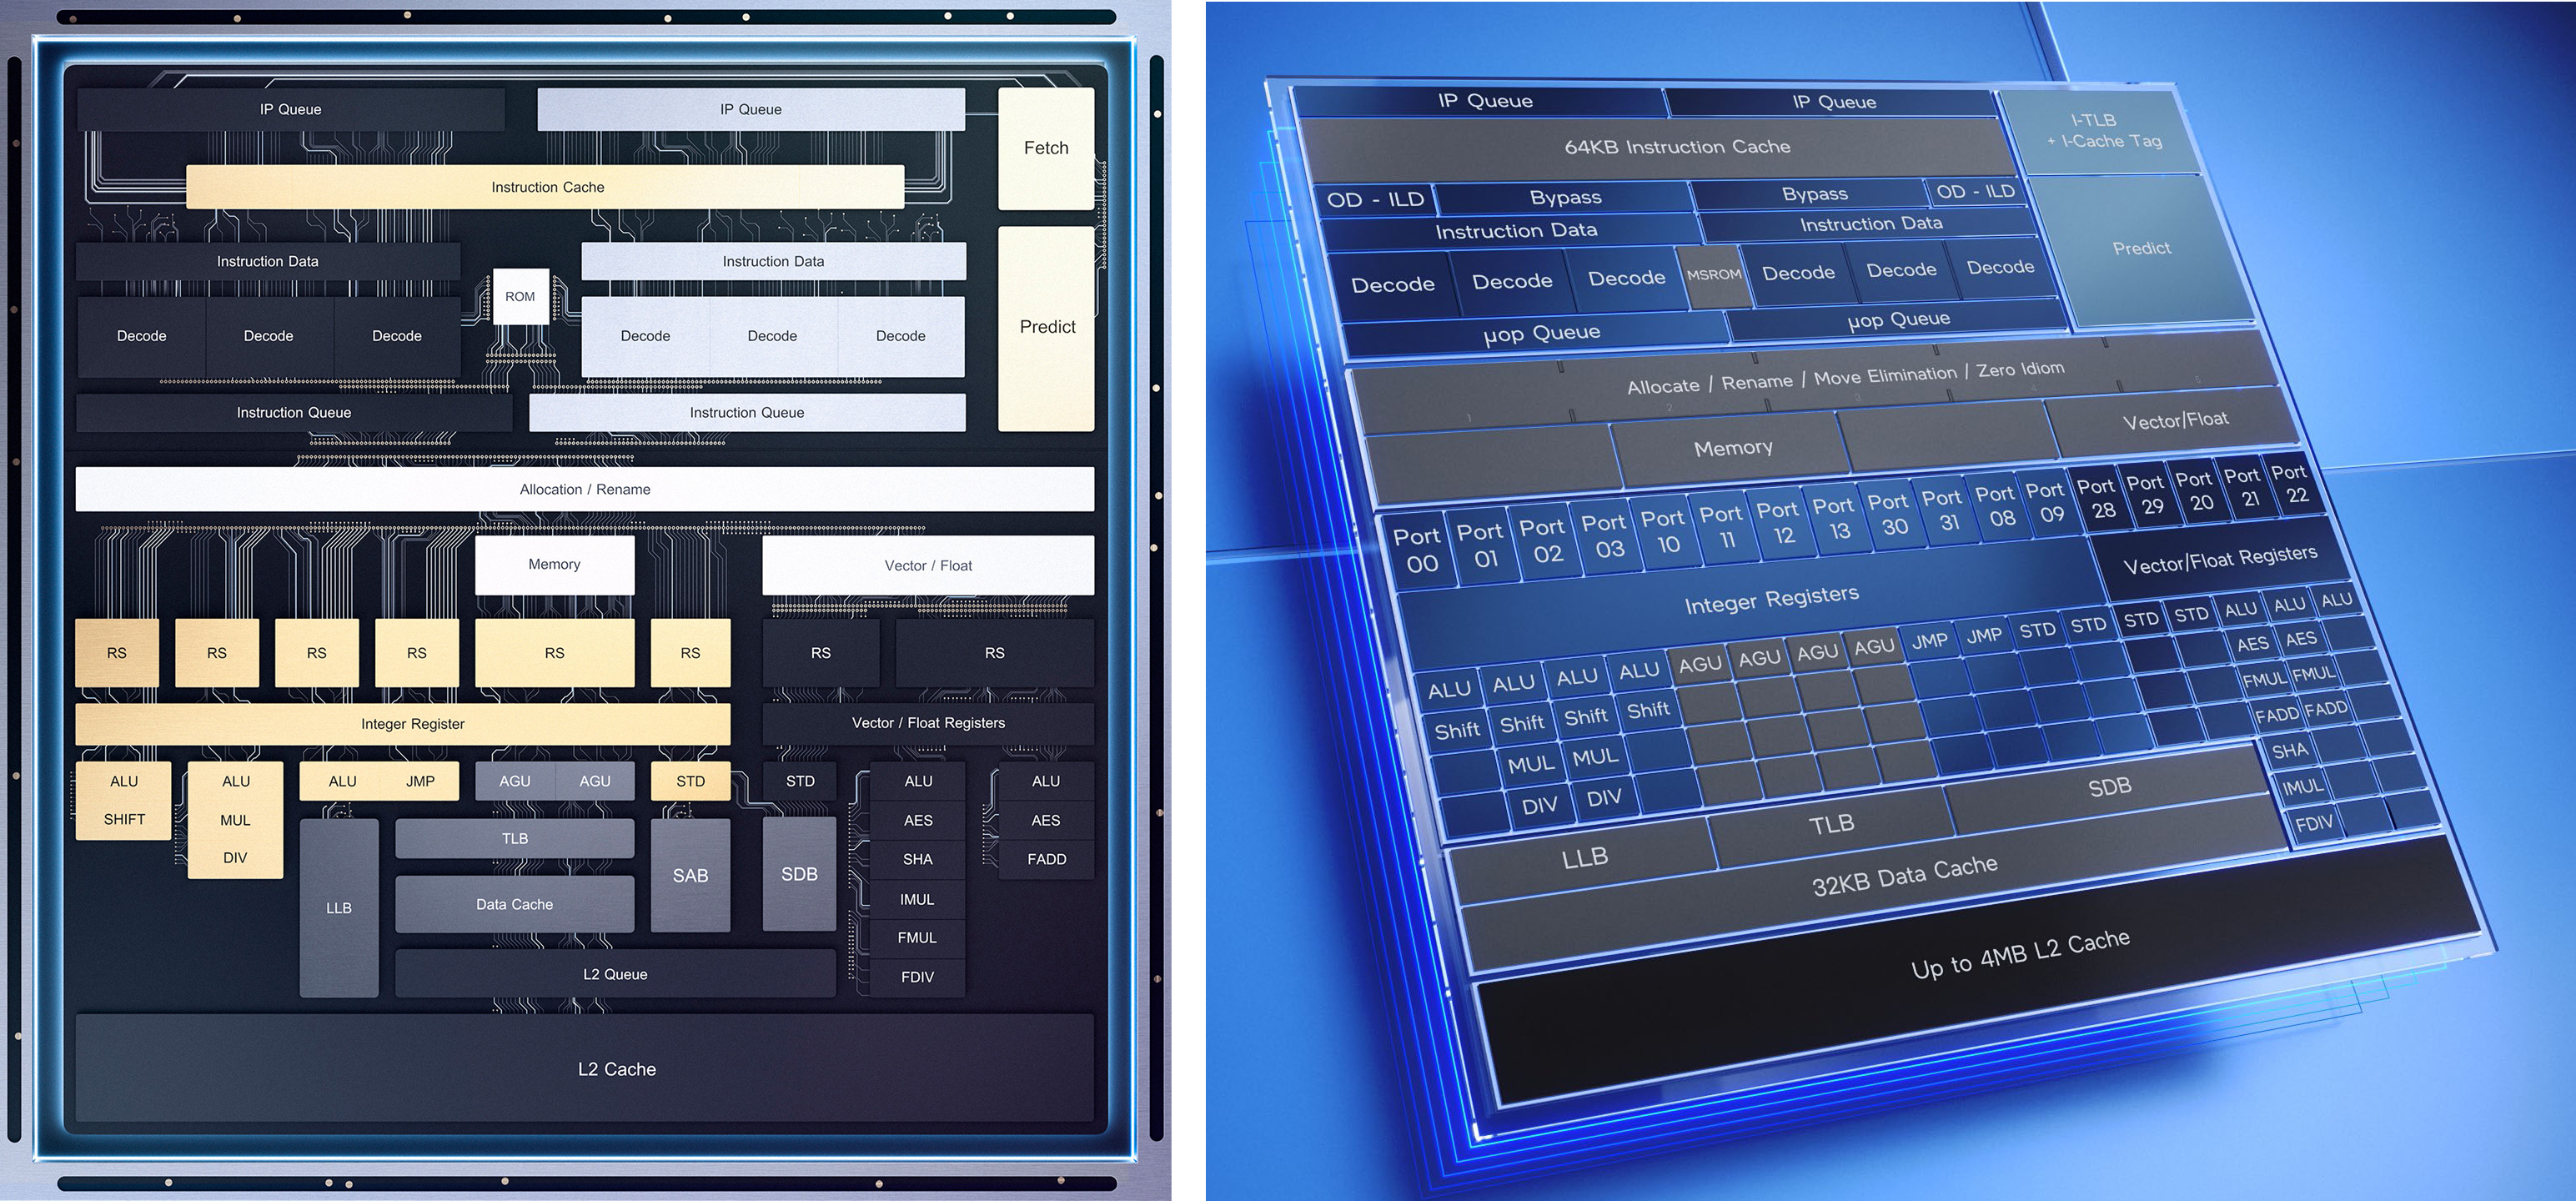
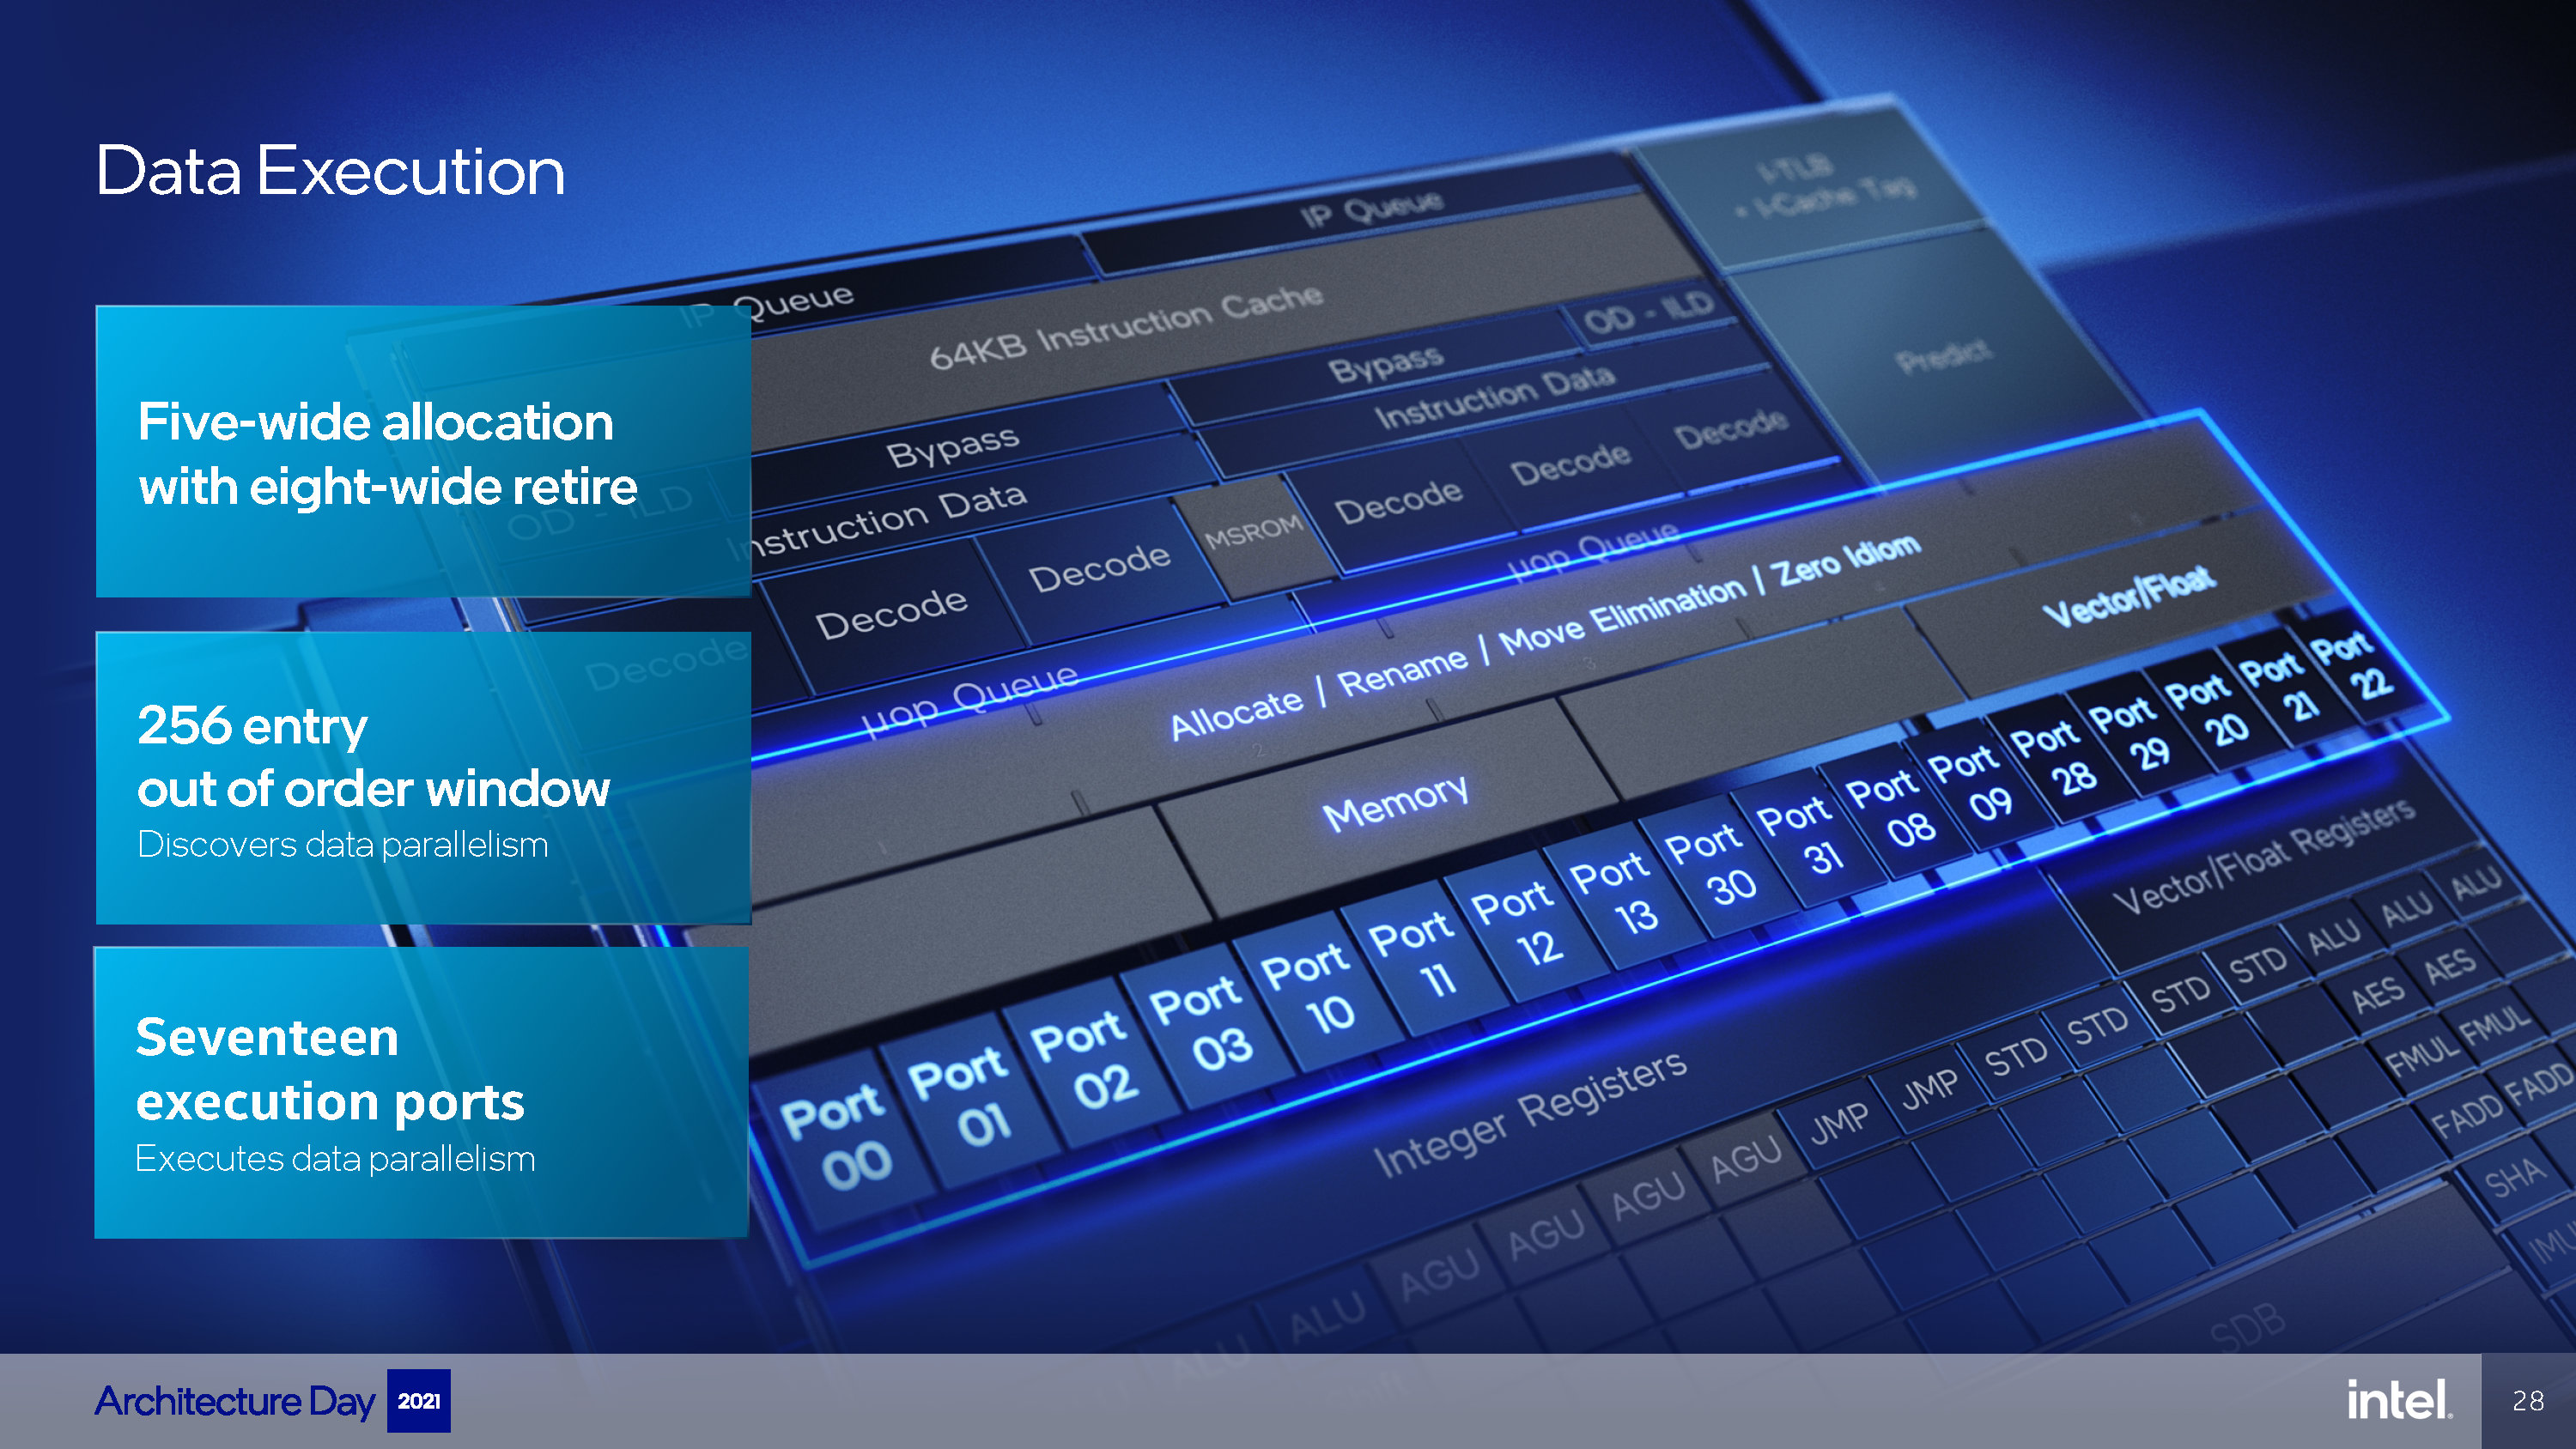
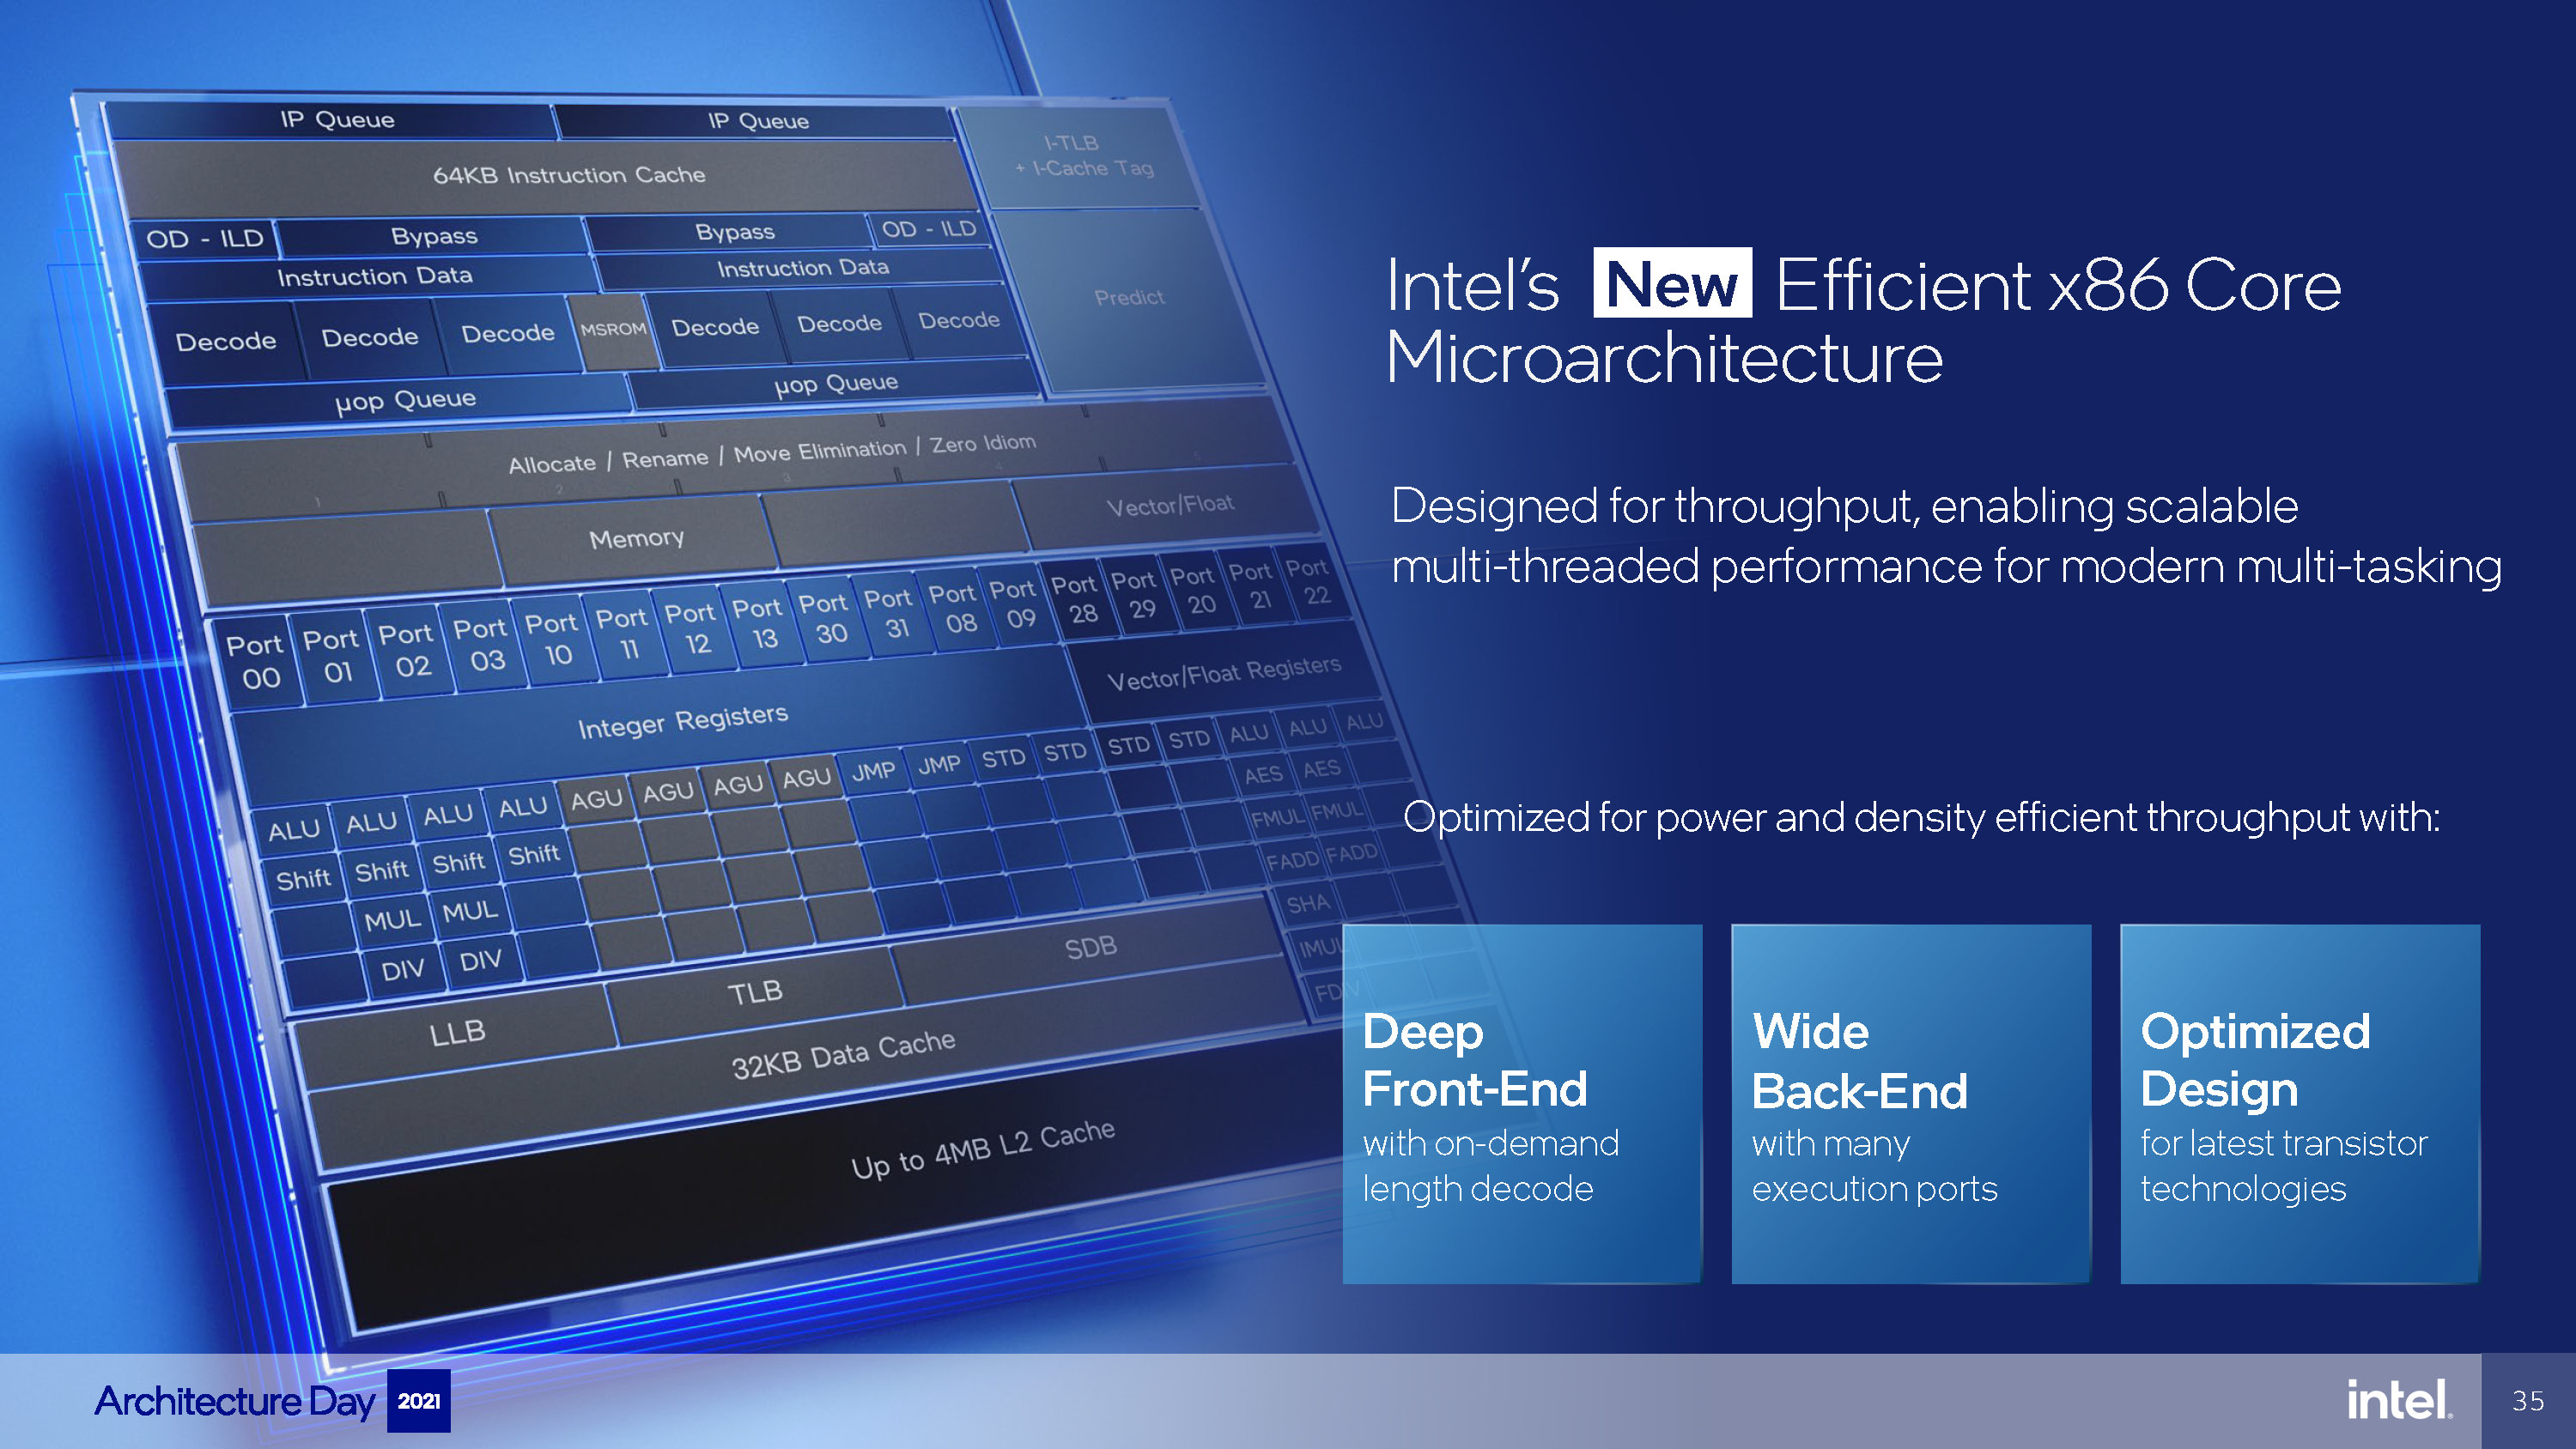
上图左边是Tremont,右边是Gracemont,可以非常明显的看到,Gracemont的执行端口多了不少,从原本的10个猛增至17个,而跟着的就是执行单元数量变多了。

整数部分ALU从3个增加到4个,AGU从2个倍增到4个,对应还增加了一组MUL和DIV单元,整数执行能力得到大幅增强;浮点运算部分也有一定提升,原本只有一个的FADD和FMUL单元现在均有两个,能够拼合处理256-bit宽度的数据,也就是说能够满足执行AVX2指令集的需求;浮点ALU和STD均增加一个,计算能力会有较大提升。

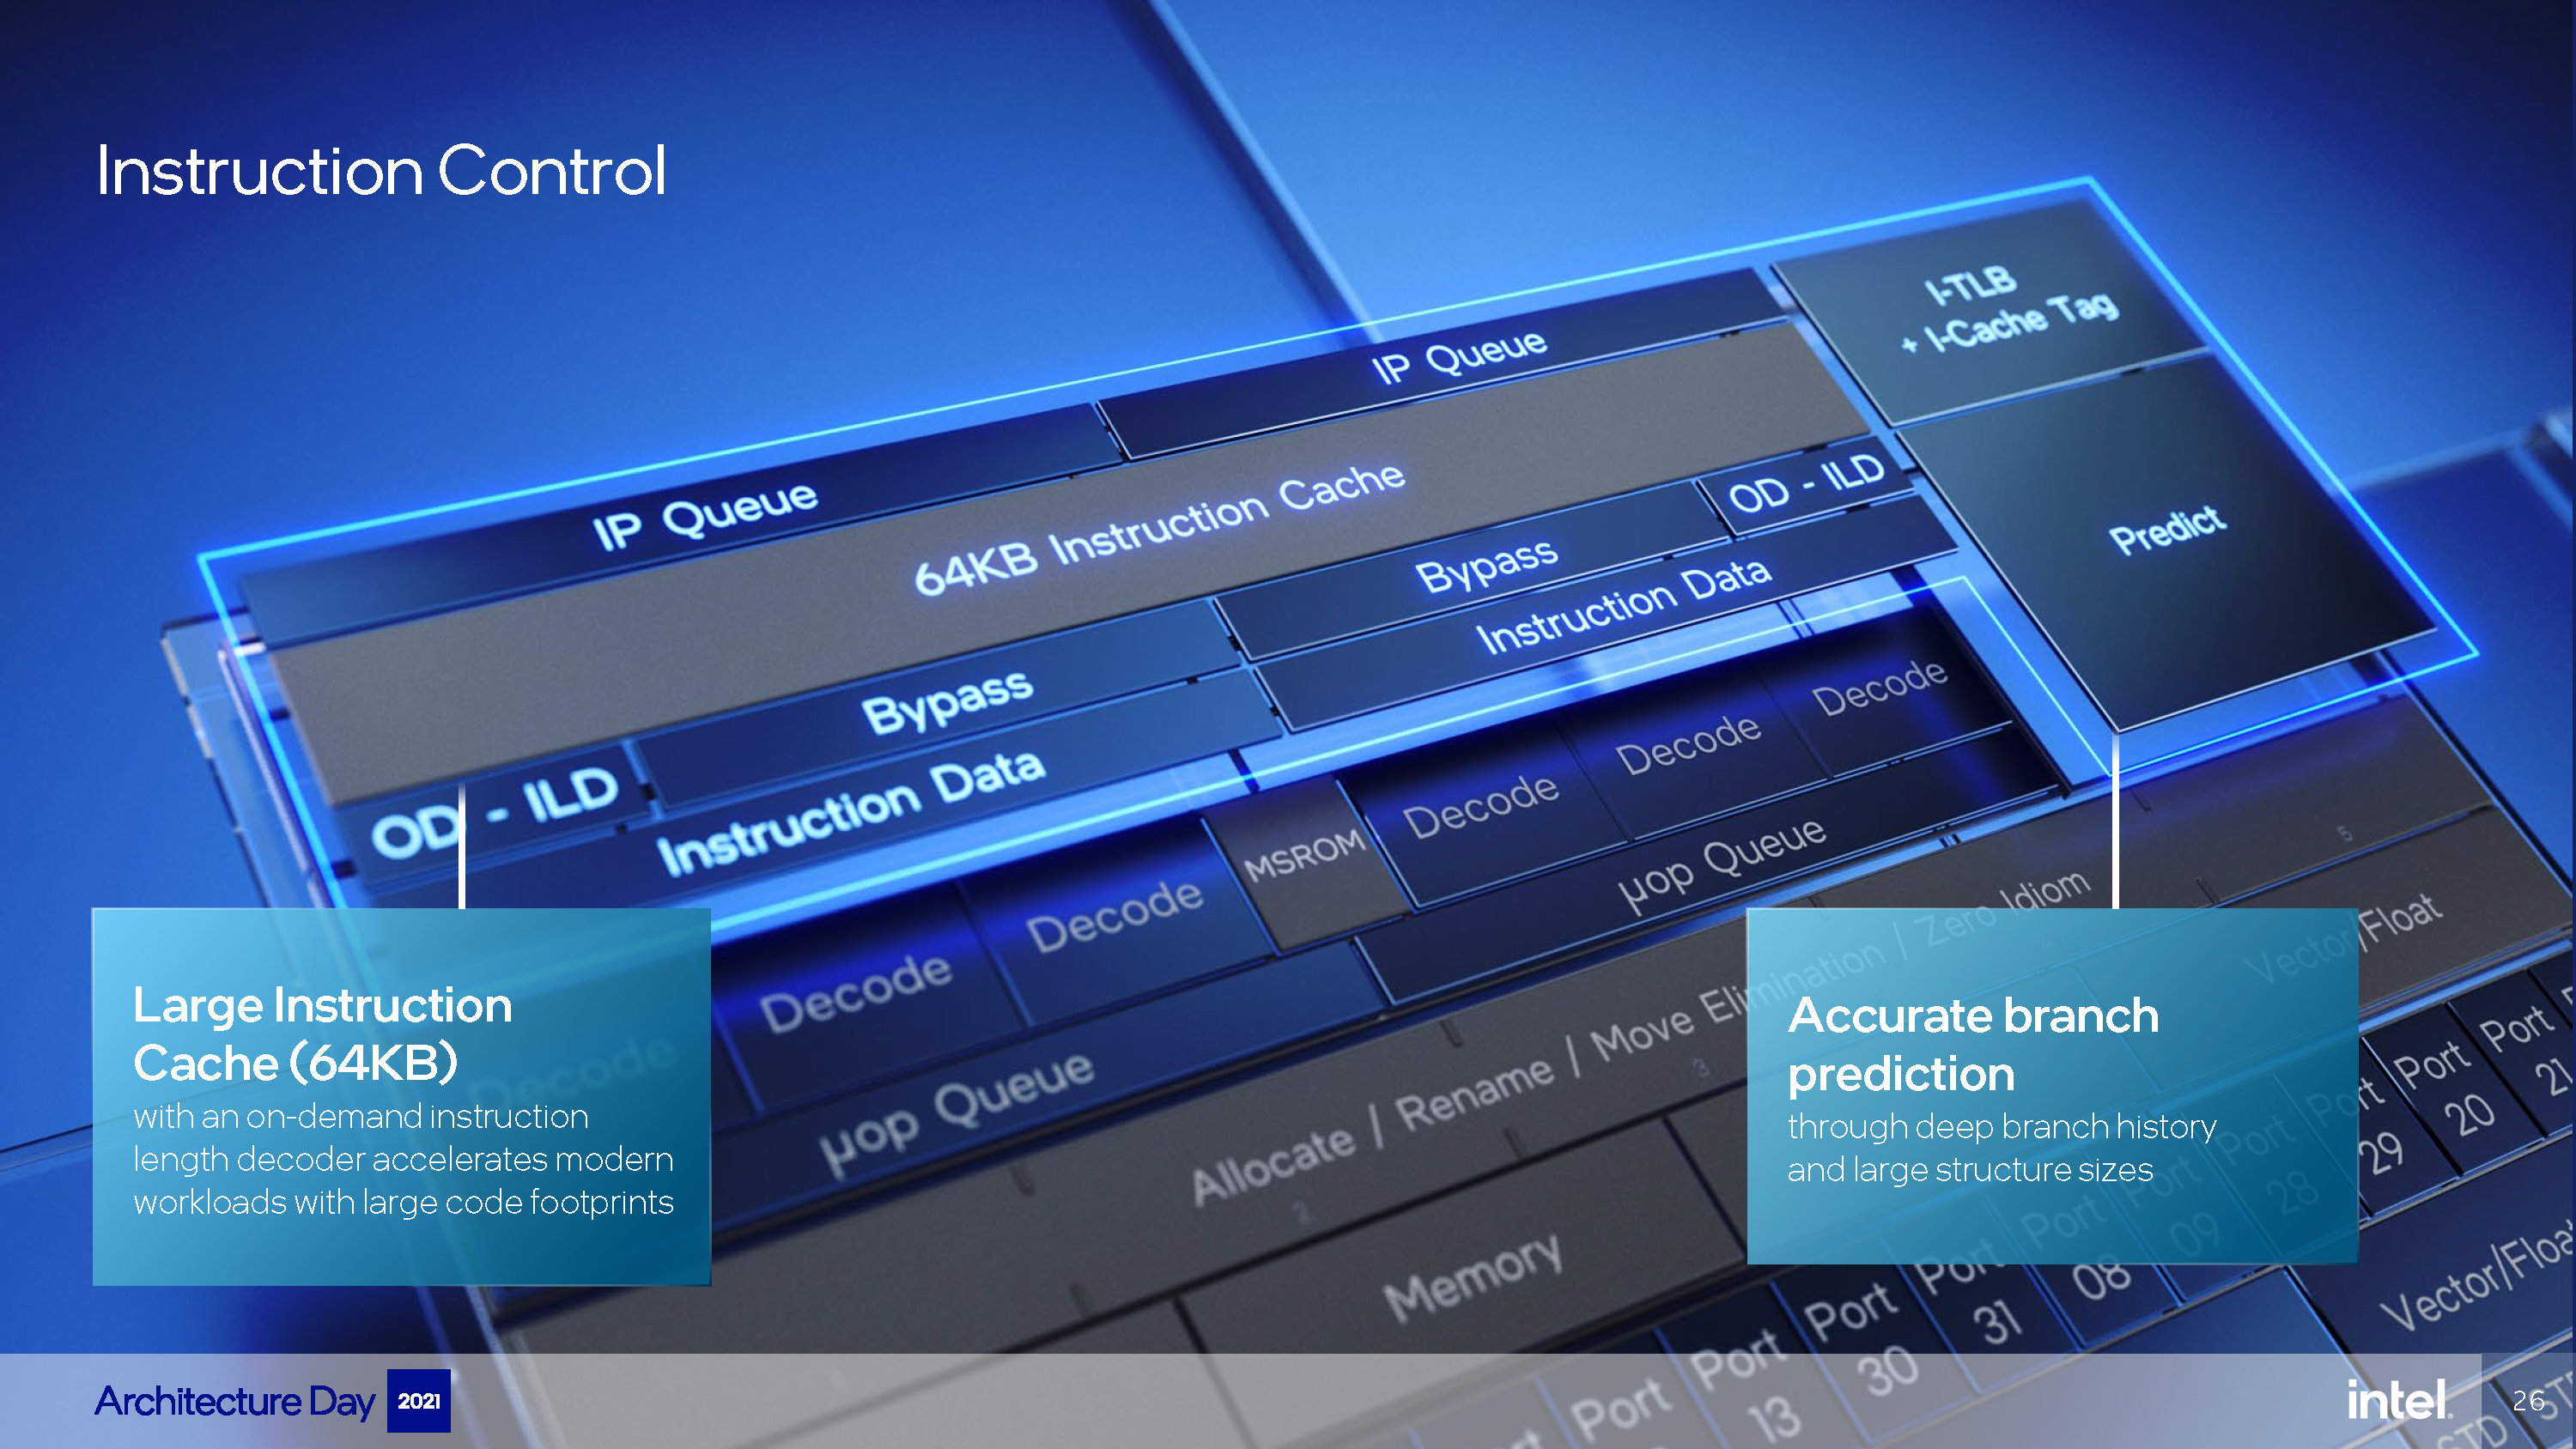
为了满足大幅膨胀的后端,前端也相应做了较大增强,解码部分仍然是两组三宽度设计,可以同时启用达成六解码。L1指令缓存(L1I)倍增至64KB,同时分支预测器得到加强,拥有更大的缓存。

中核部分,ROB增大到256,这一数字比Skylake的224更大,与Zen 3持平。

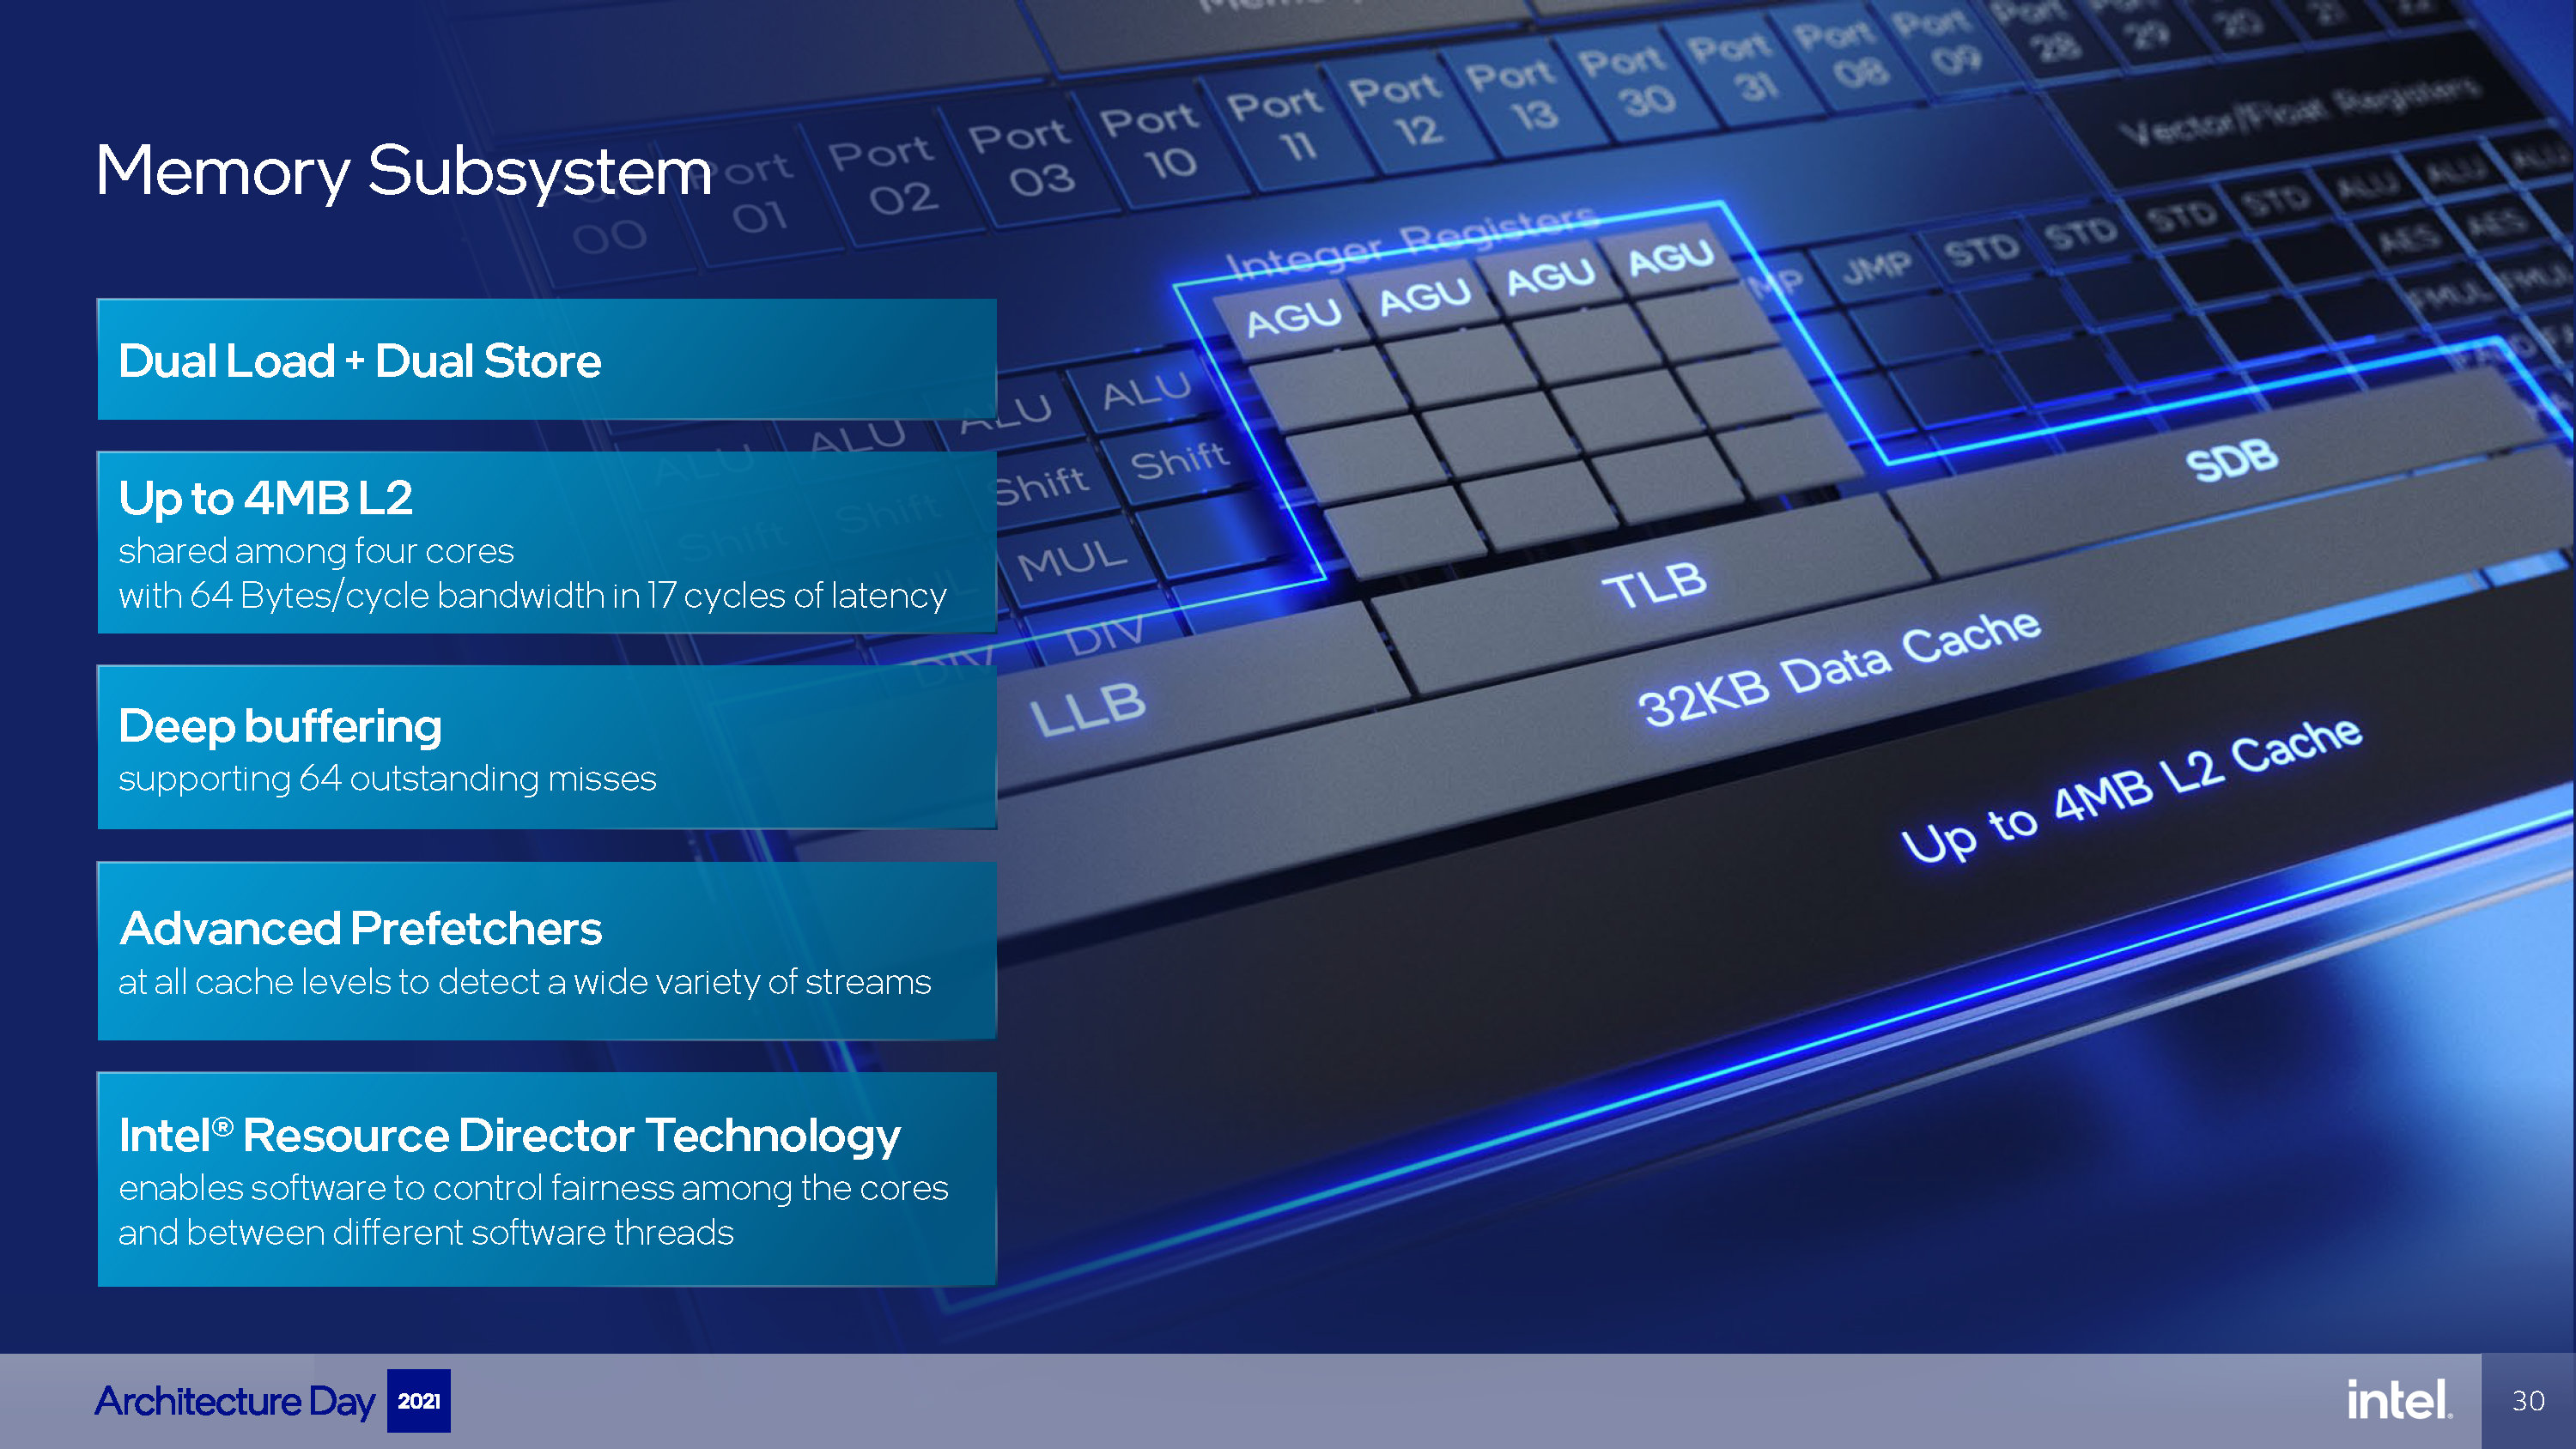
最后是缓存子系统,前面说过AGU从2个倍增到4个,分配成2个Load和2个Store。L1D的大小没有变化,仍为32KB,L2的缓存最高可达4MB,需要注意的是,L2缓存是4个小核一起共用的,同时容量可配置。对了,还需要提到的是,小核以4个为一组,一组小核的面积与一个Golden Cove差不多。

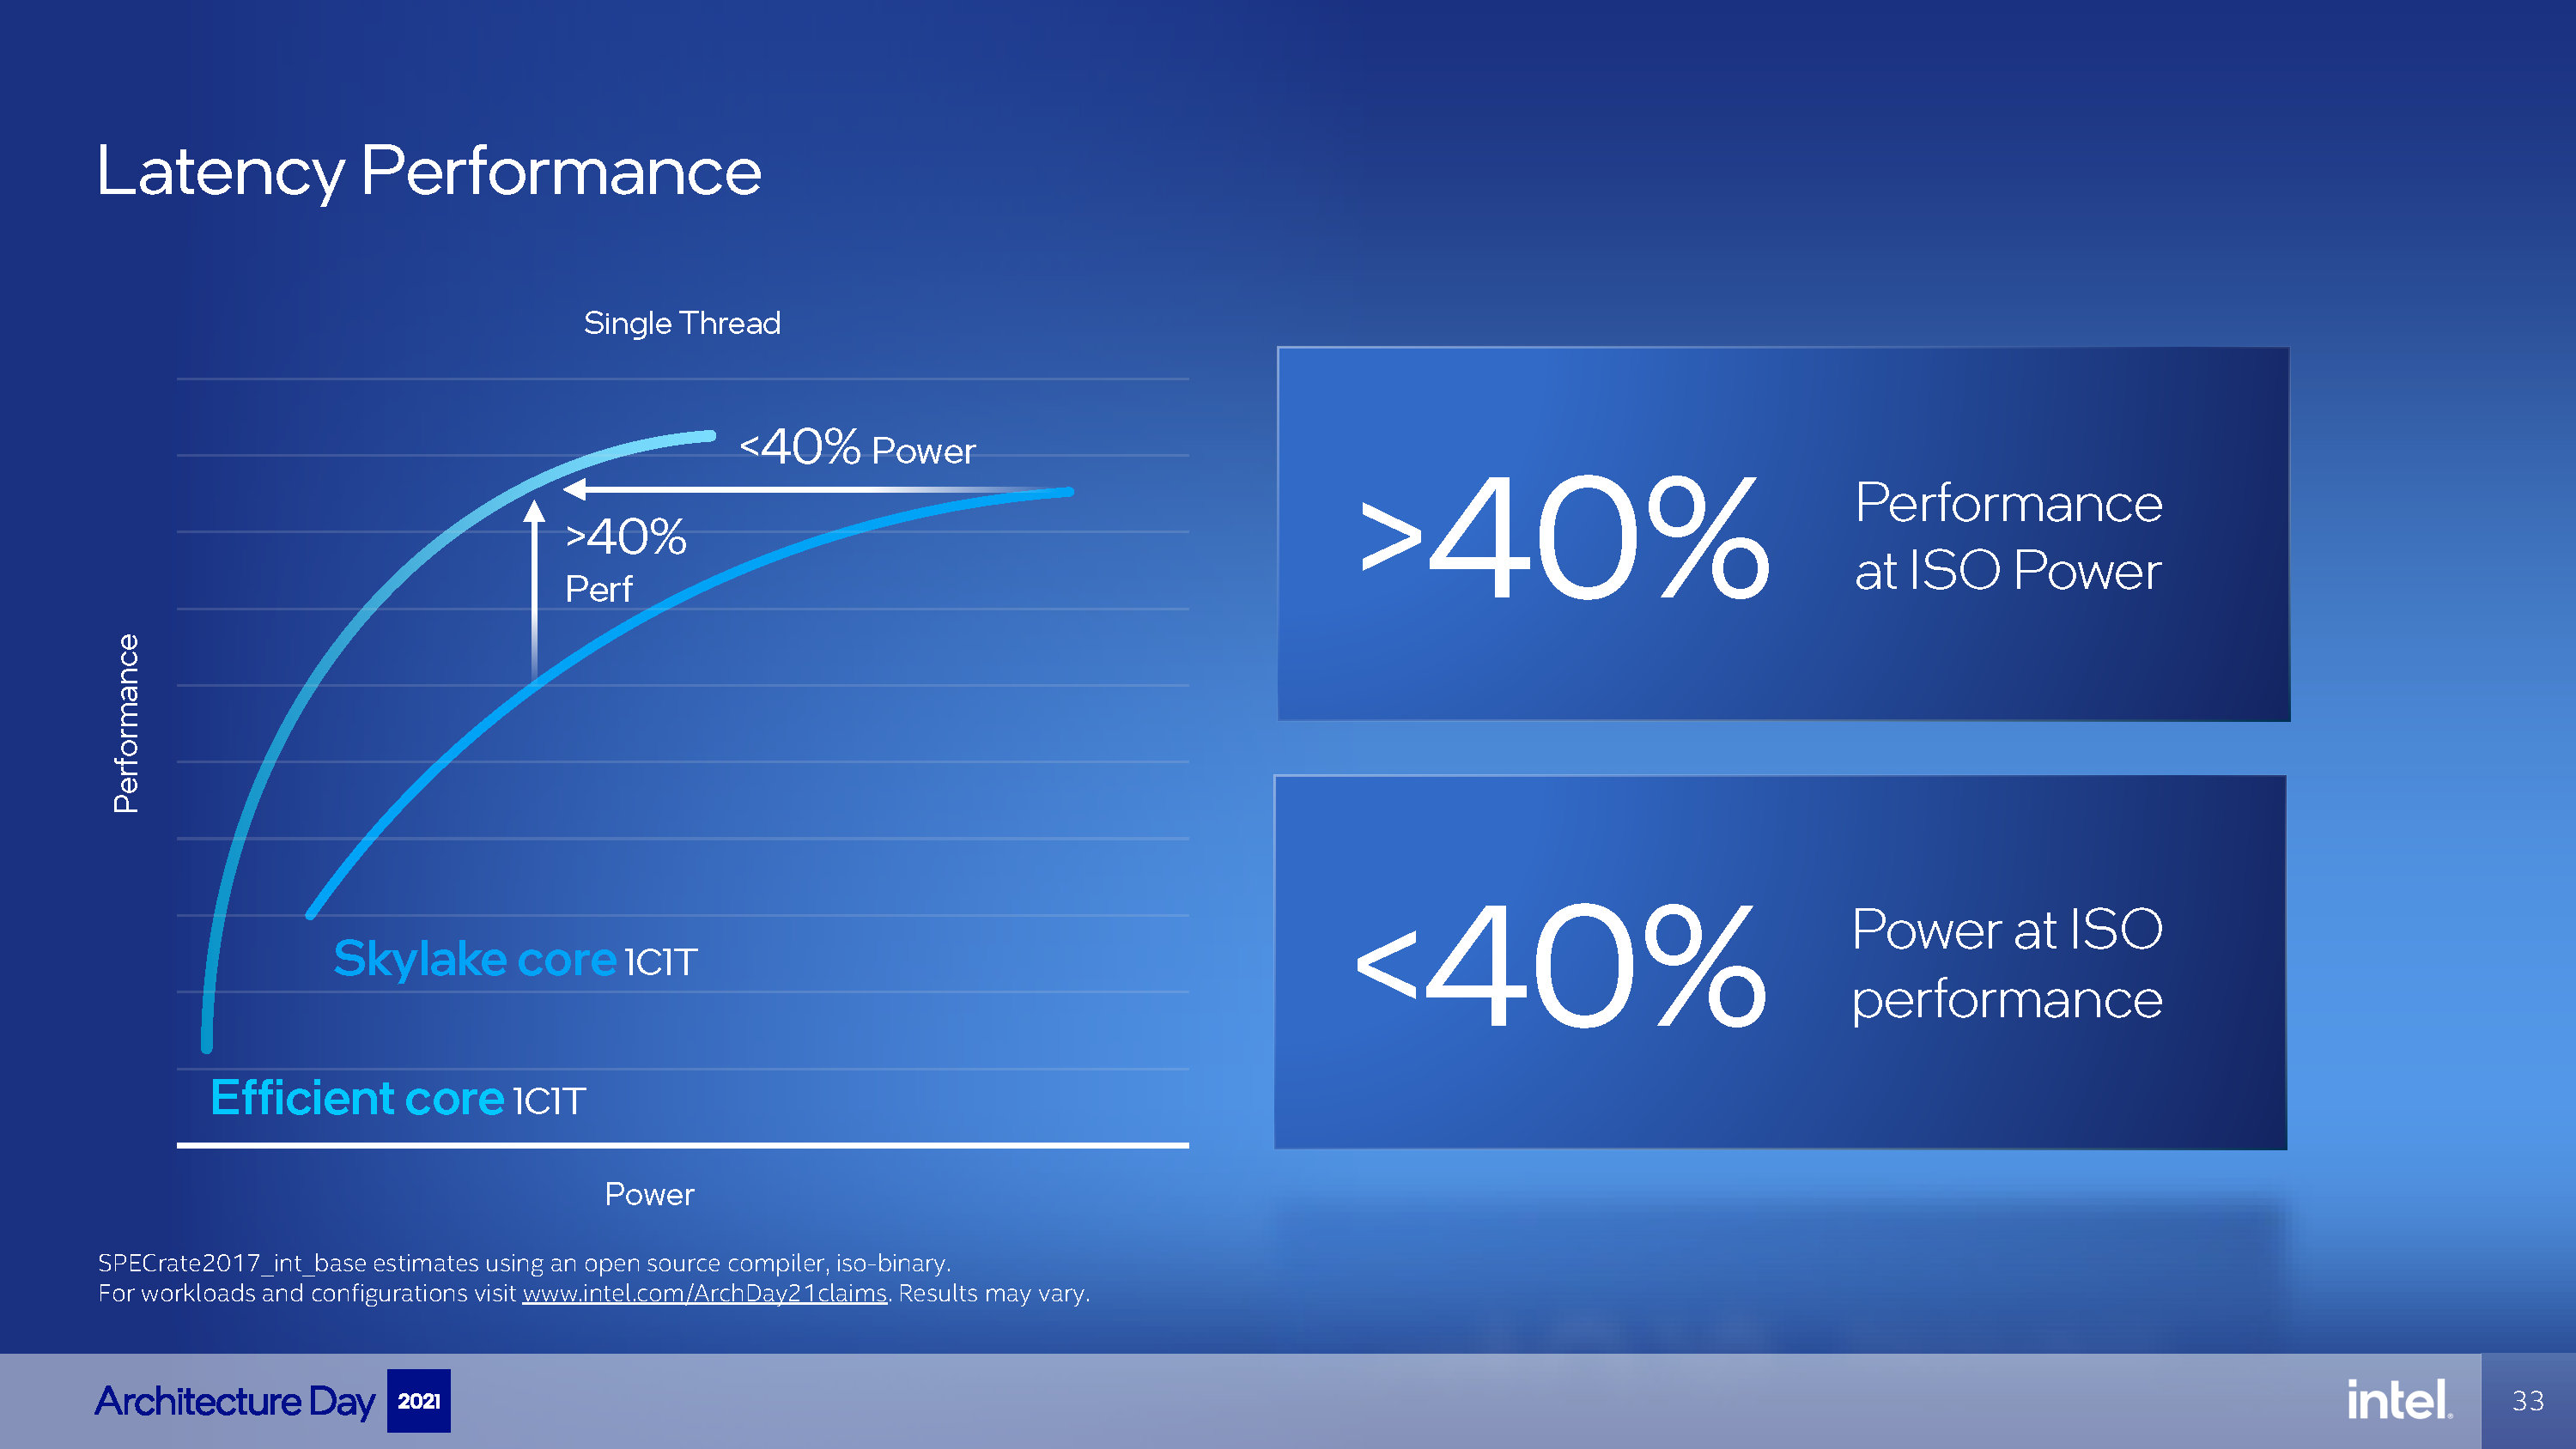
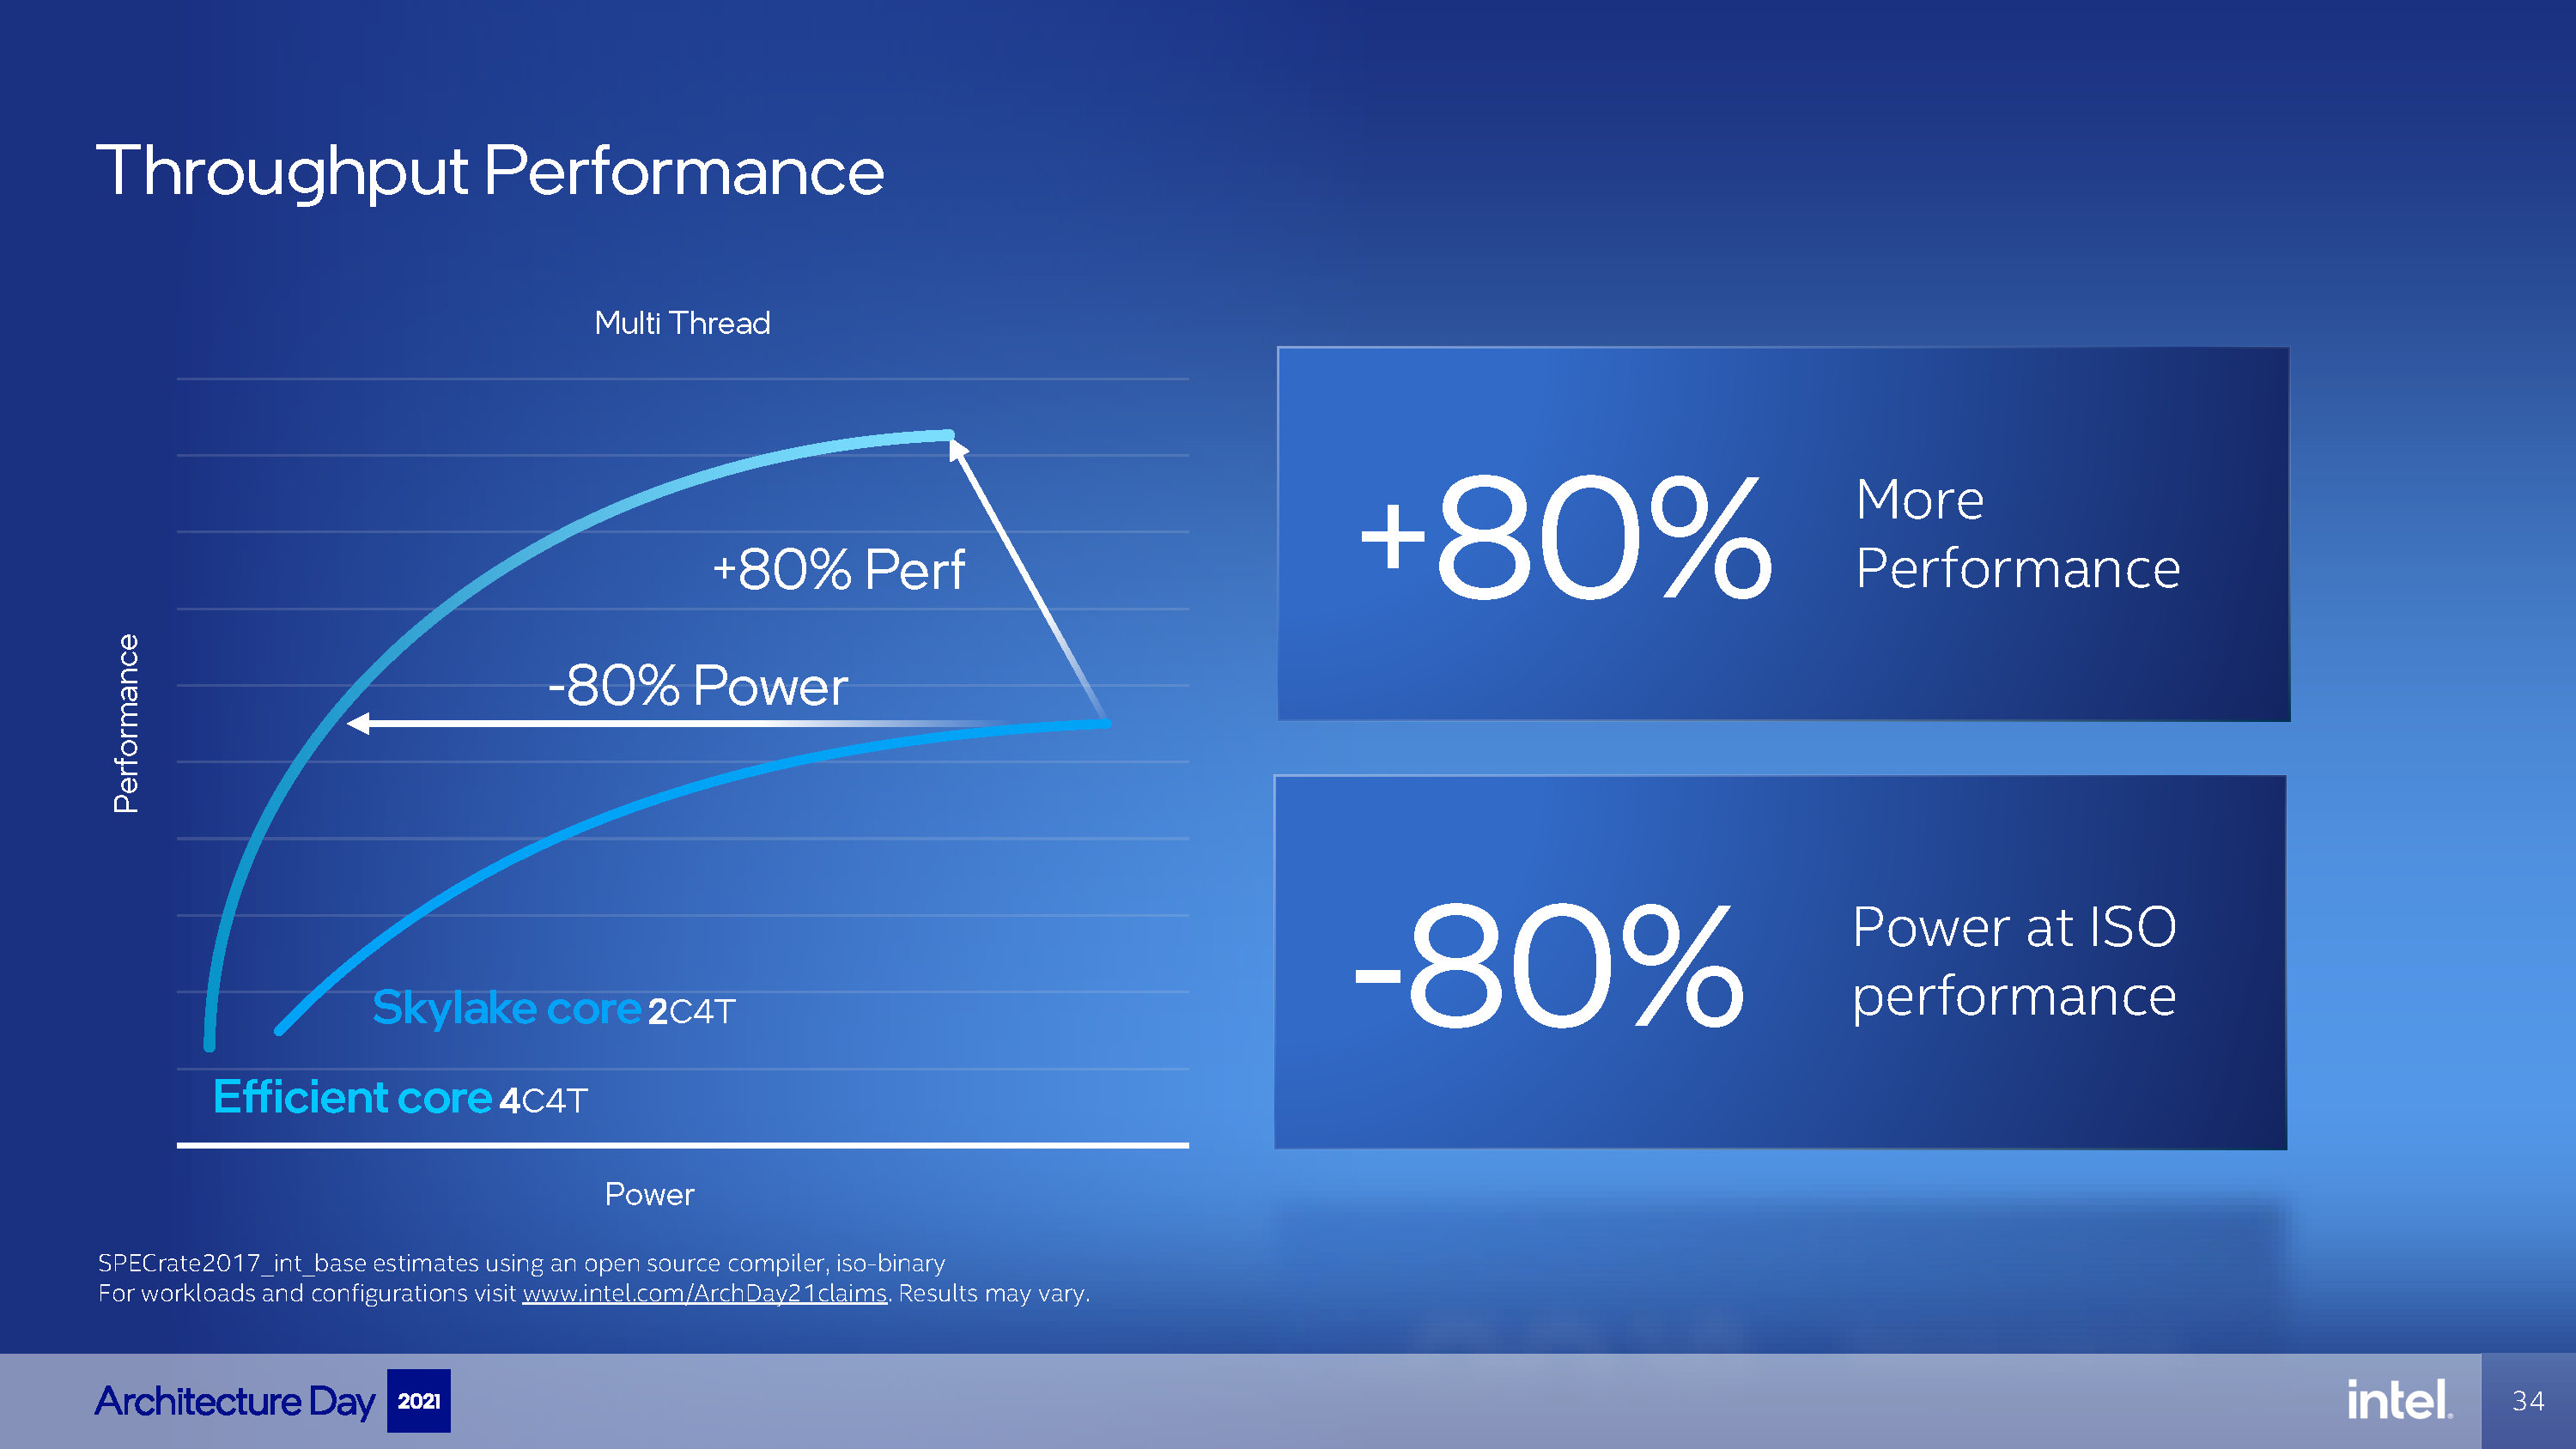
总的这些改进加起来,Gracemont的性能提升相当可观。官方将它与Skylake进行了对比,在单线程的整数性能方面,Gracemont同功耗性能可提升超过40%,同性能下节约40%左右的功耗,能效比超群。

而在多线程方面,同样是4线程,与开启超线程的2个Skylake内核相比,4个Gracemont内核能够在少用80%功耗的情况下输出同样的整数性能,而如果火力全开,那么能够提供约1.8倍的整数性能,同时功耗还更低。

总的来说,Alder Lake使用Gracemont来提升处理器在多线程情景下的总性能,同时在注重节能的场景下,可以凭借小核优异的能效比实现更长的续航表现。

P-Core:IPC提升约19%的Golden Cove

小核很强,而大核——Intel称为性能核心(Performance Core,简称P-Core)——的Golden Cove内核只能说是改的更大提升更多。用Intel的官方口径来说,就是变得更宽、更深和更智能了。

更宽指的是内核解码、执行指令的并行程度更大;更深指的是内核中的各种指令缓存变得更大;更智能指的是部分组件具有更准确的判断能力。

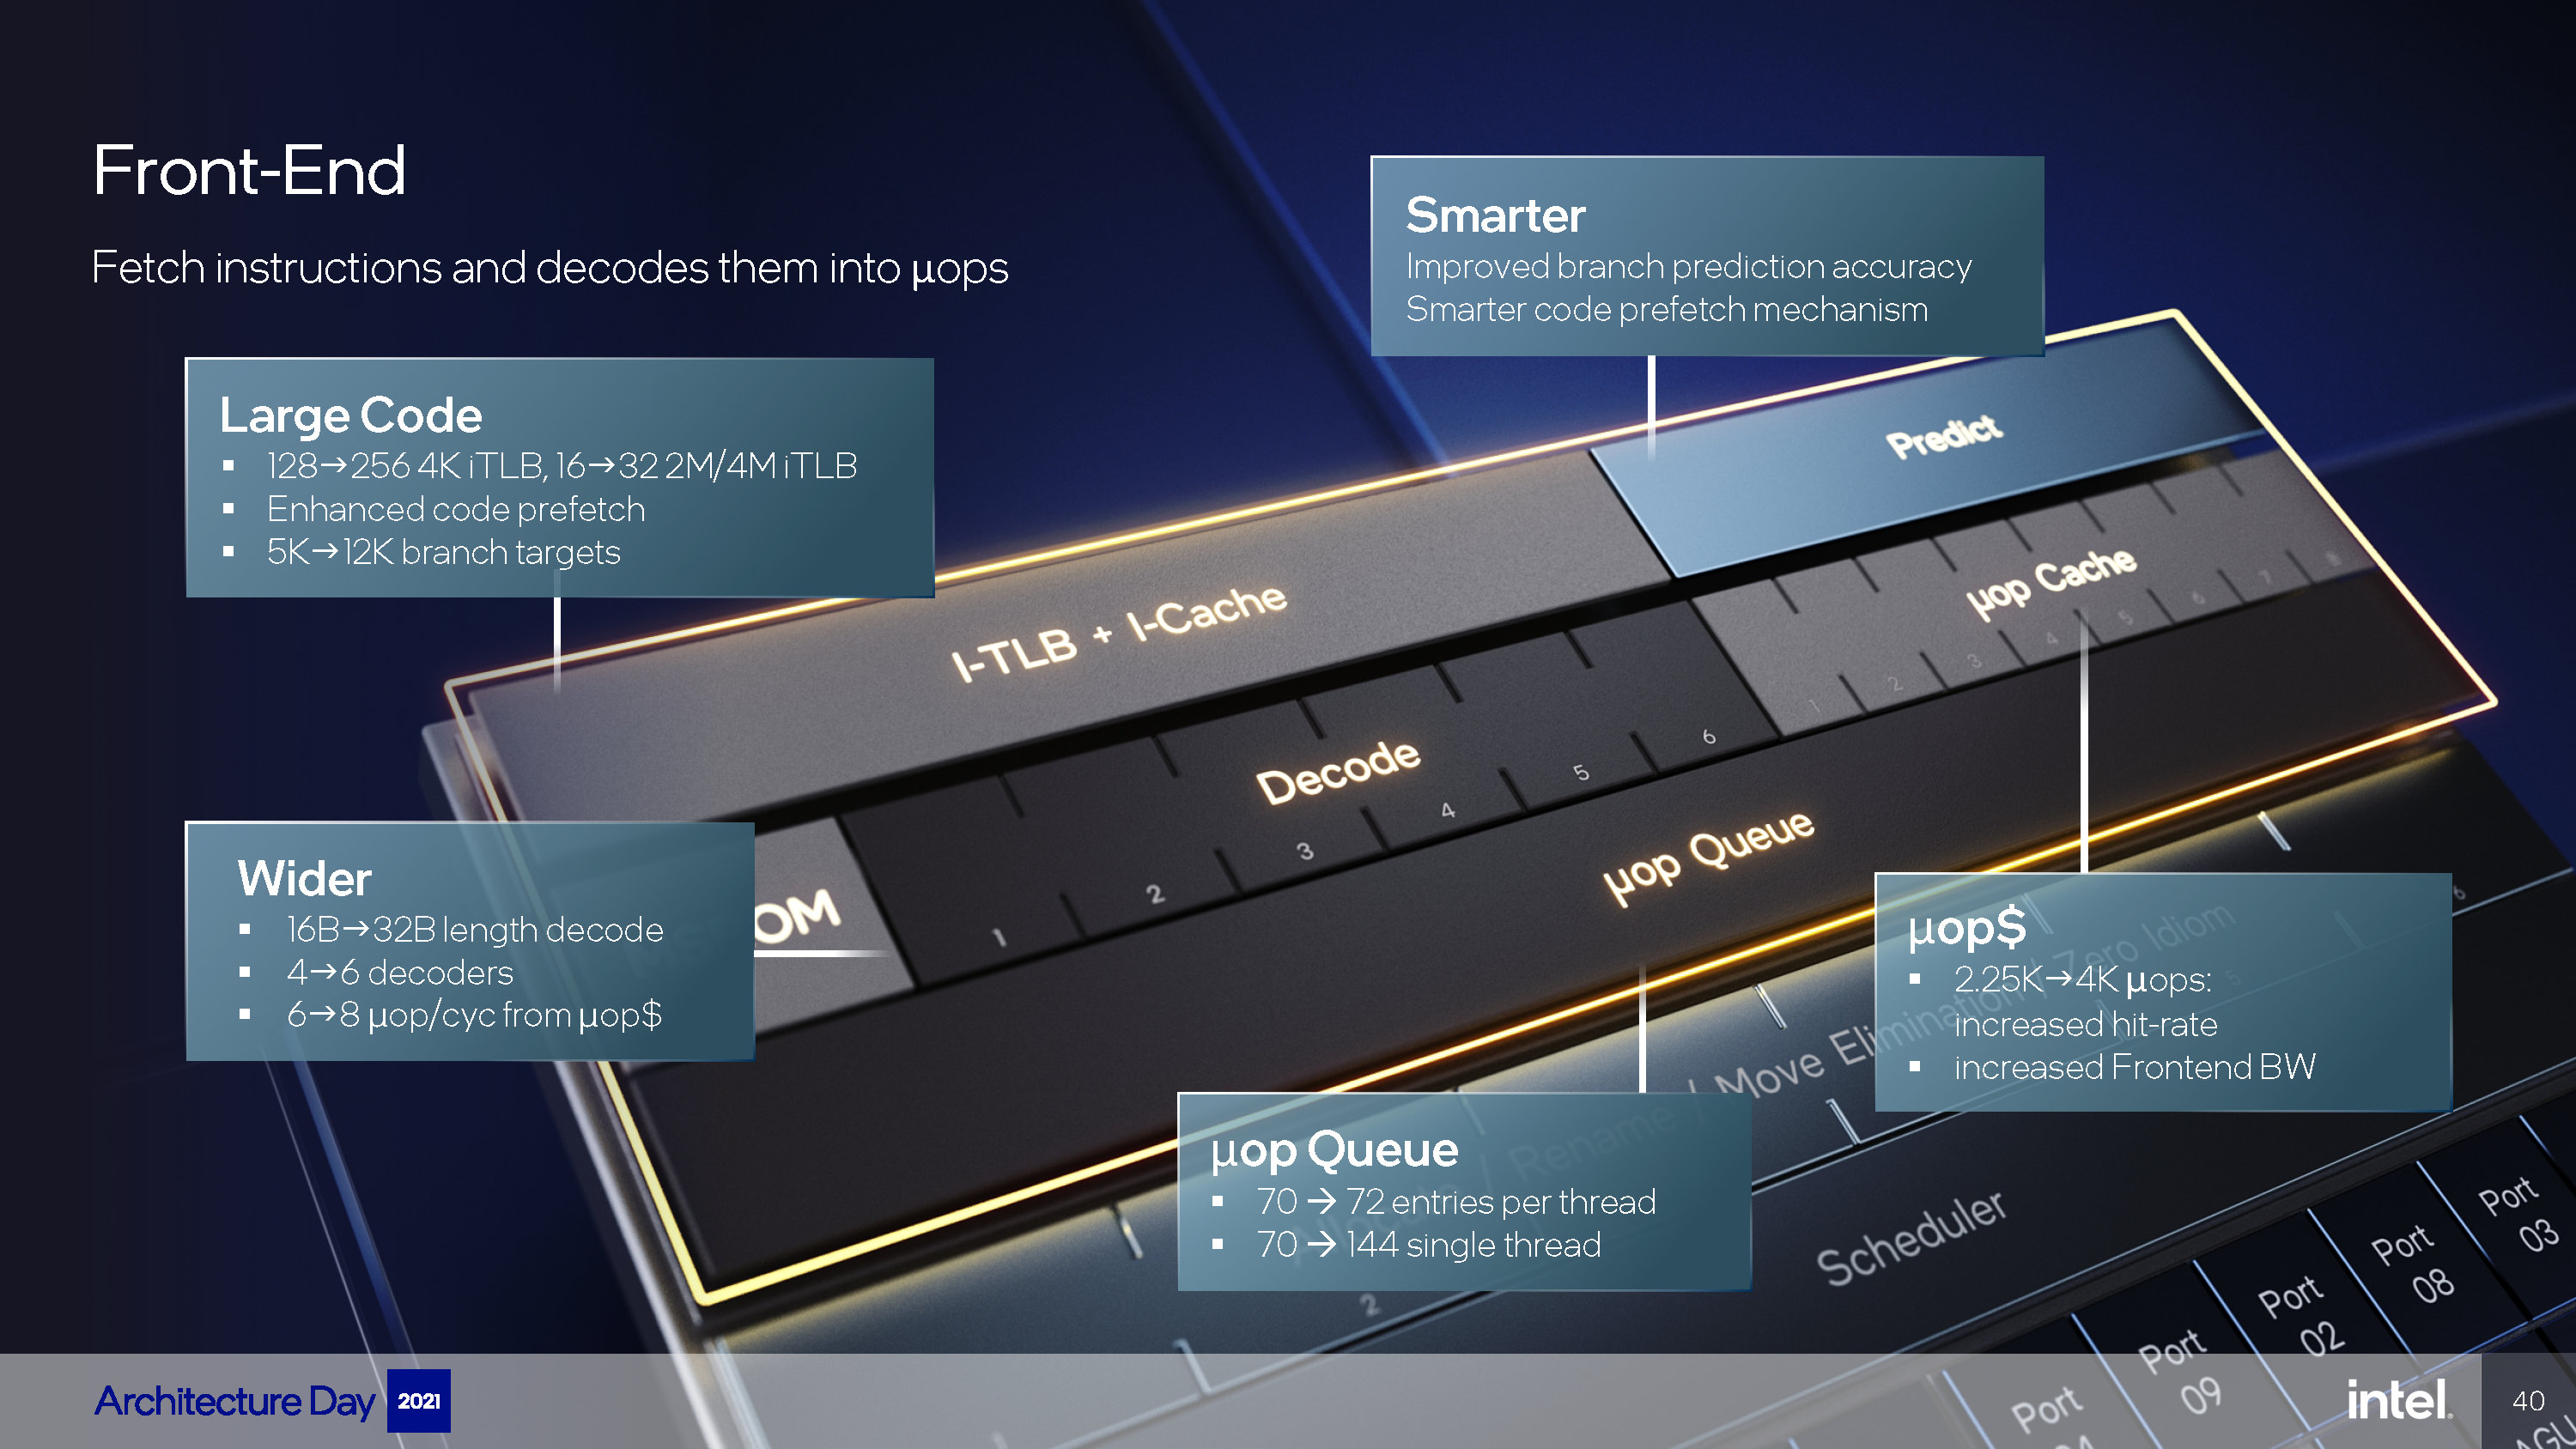
Golden Cove的前端部分改动相当大,最明显的就是多年未变的4宽度(实际上是4+1宽度)解码器升级成了6宽度解码器(应该是6+1)。不像Arm等RISC体系的内核,属于CISC体系的x86要增加指令解码器的代价相当大,因此不管是AMD还是Intel都把前端解码器维持在4宽度,现在Intel首先前行一步。同时L1I缓存的带宽也扩大一倍到32Bytes以满足6宽度解码器的需要。

增加解码器宽度会增加处理器的流水线长度,这让分支预测错误的惩罚更重。Intel选择增加分支预测缓冲区(BTB)来应对这一问题,其分支条目数量从5K直接增加到12K,比Zen 3的6.5K多将近一倍。分支预测器本身也变得“Smarter”了,准确率继续提升。

宏指令(µOP)的吞吐量从多年未变的每周期6个增加到8个,同时用于缓存宏指令的宏指令缓存(µOP Cache)继续增大,从2.25K直接增大到4K,与Zen 2/Zen 3持平。宏指令队列的结构有所调整,现在为超线程进行了更多优化,双线程同时利用的情况下,单线程队列深度为72;而如果是单线程利用核心的情况则可以完整利用144的队列深度。

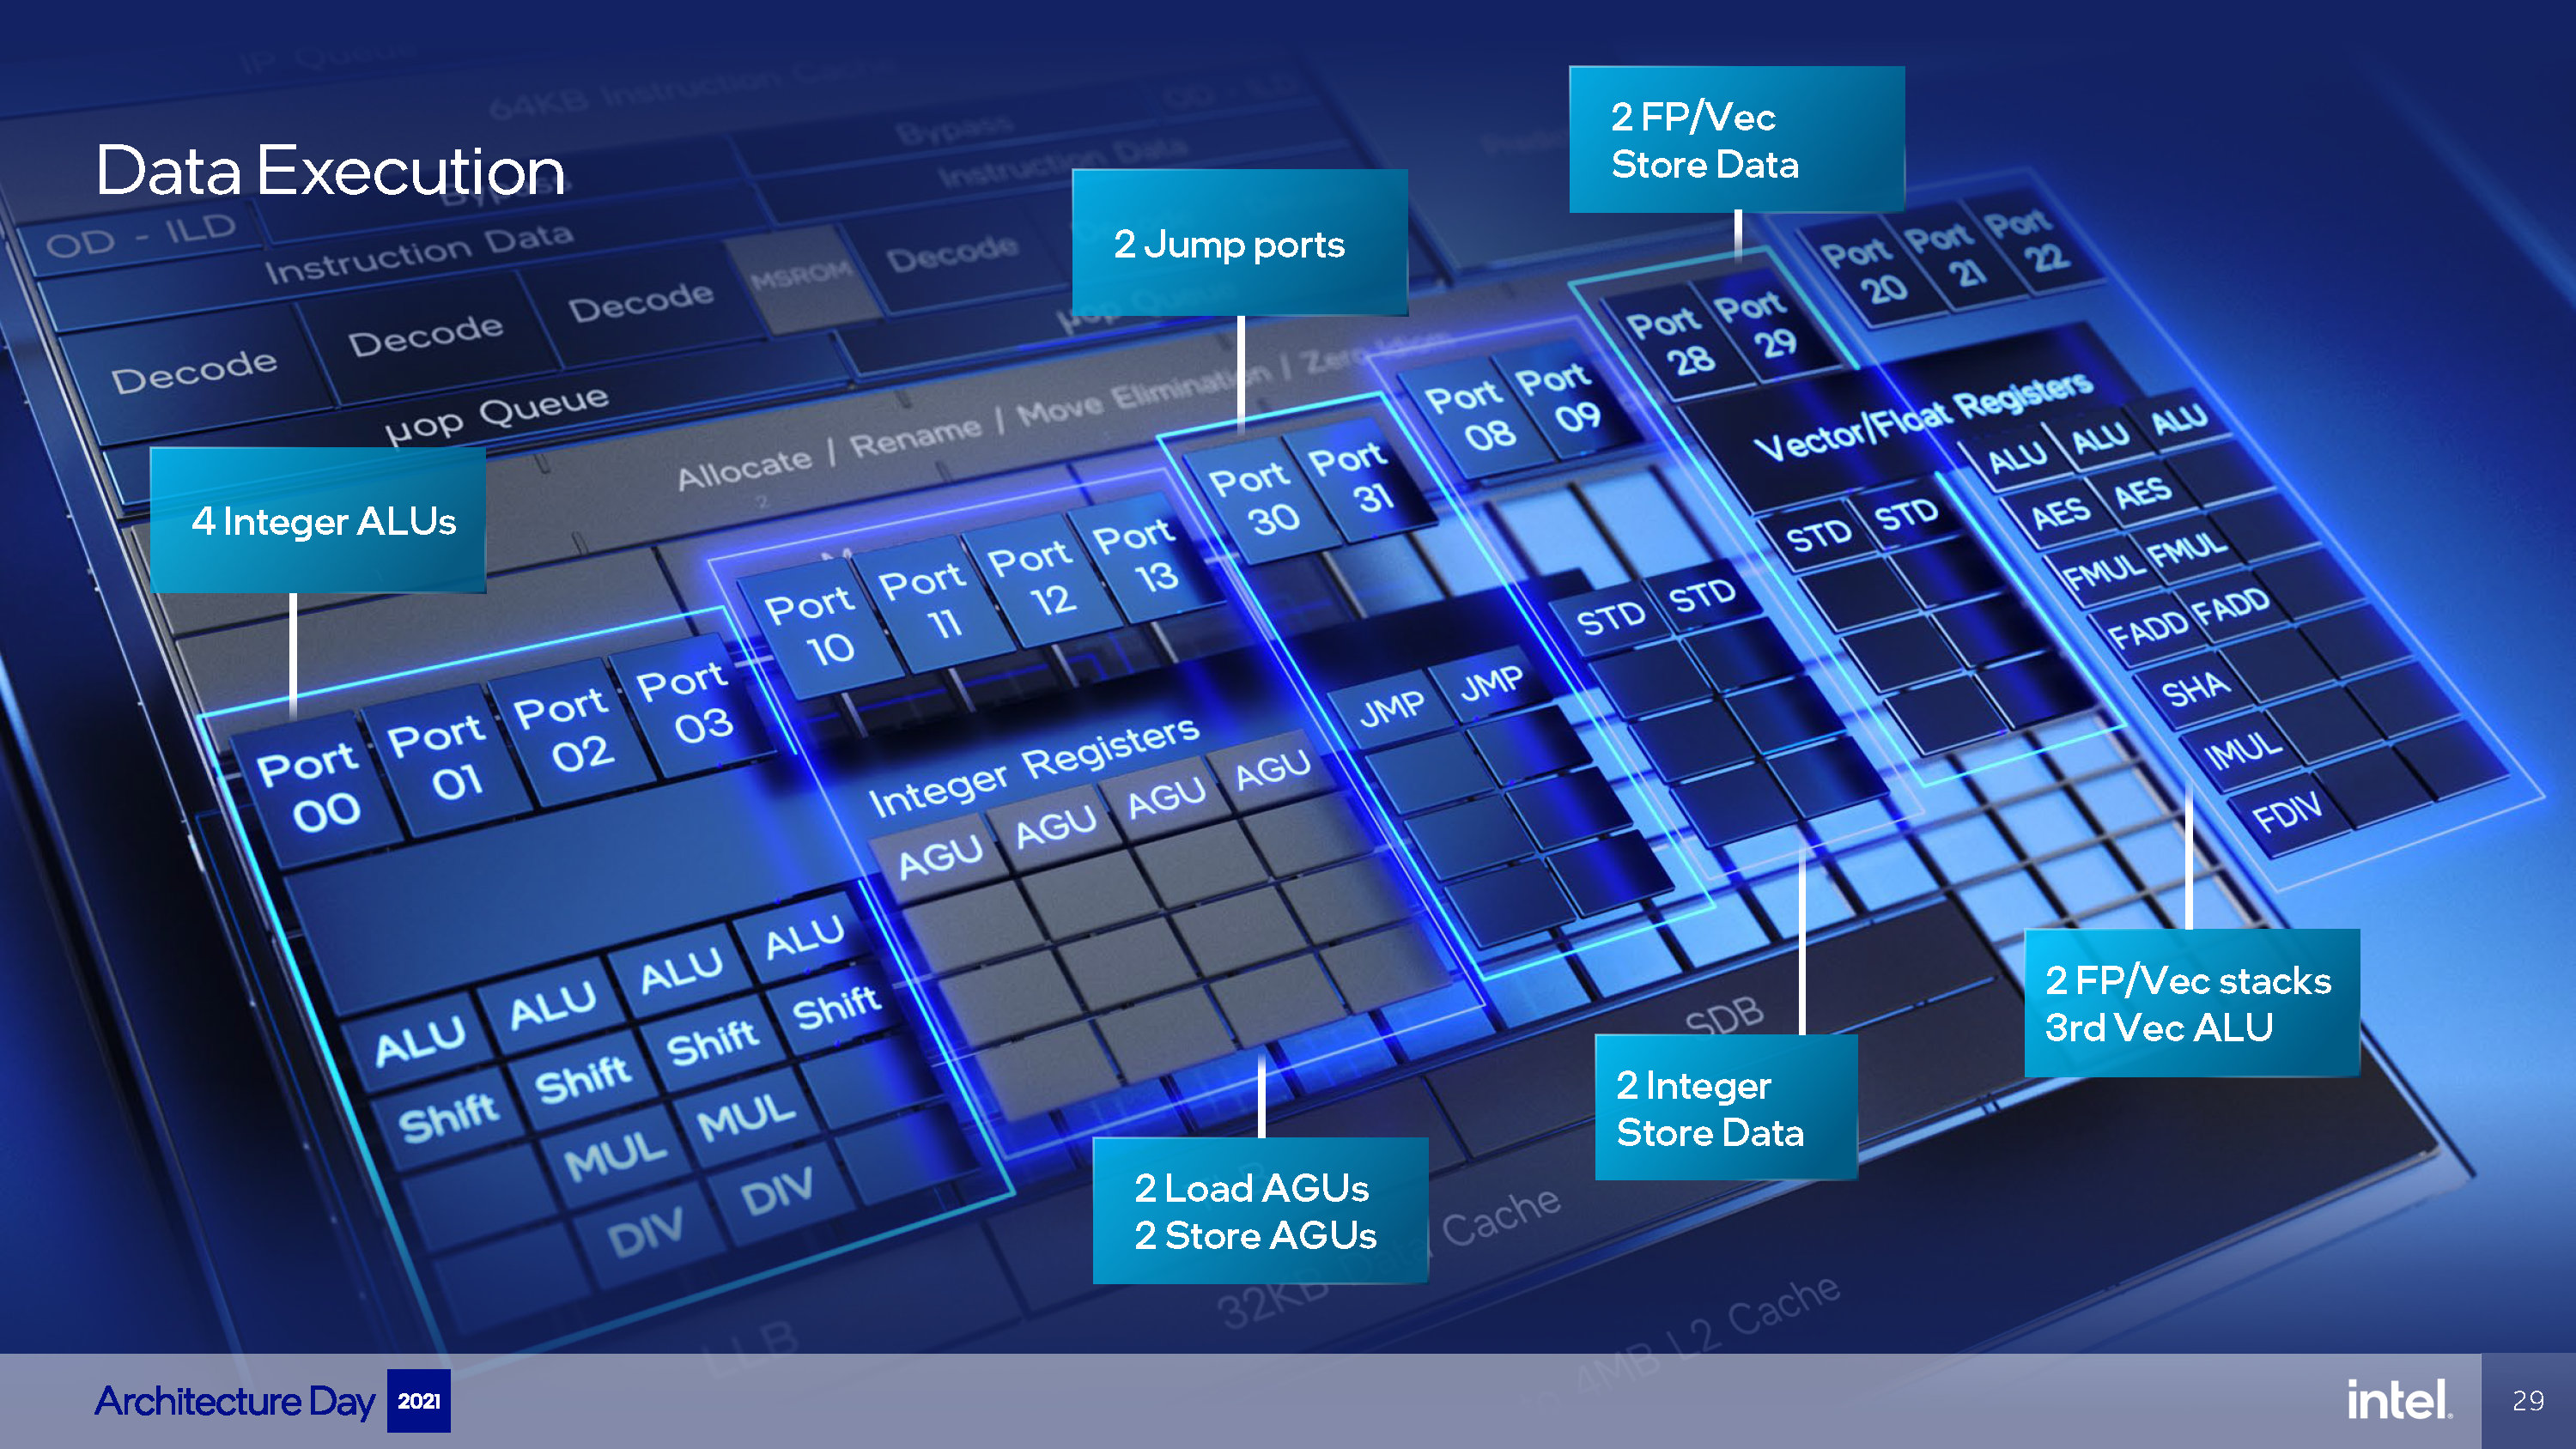
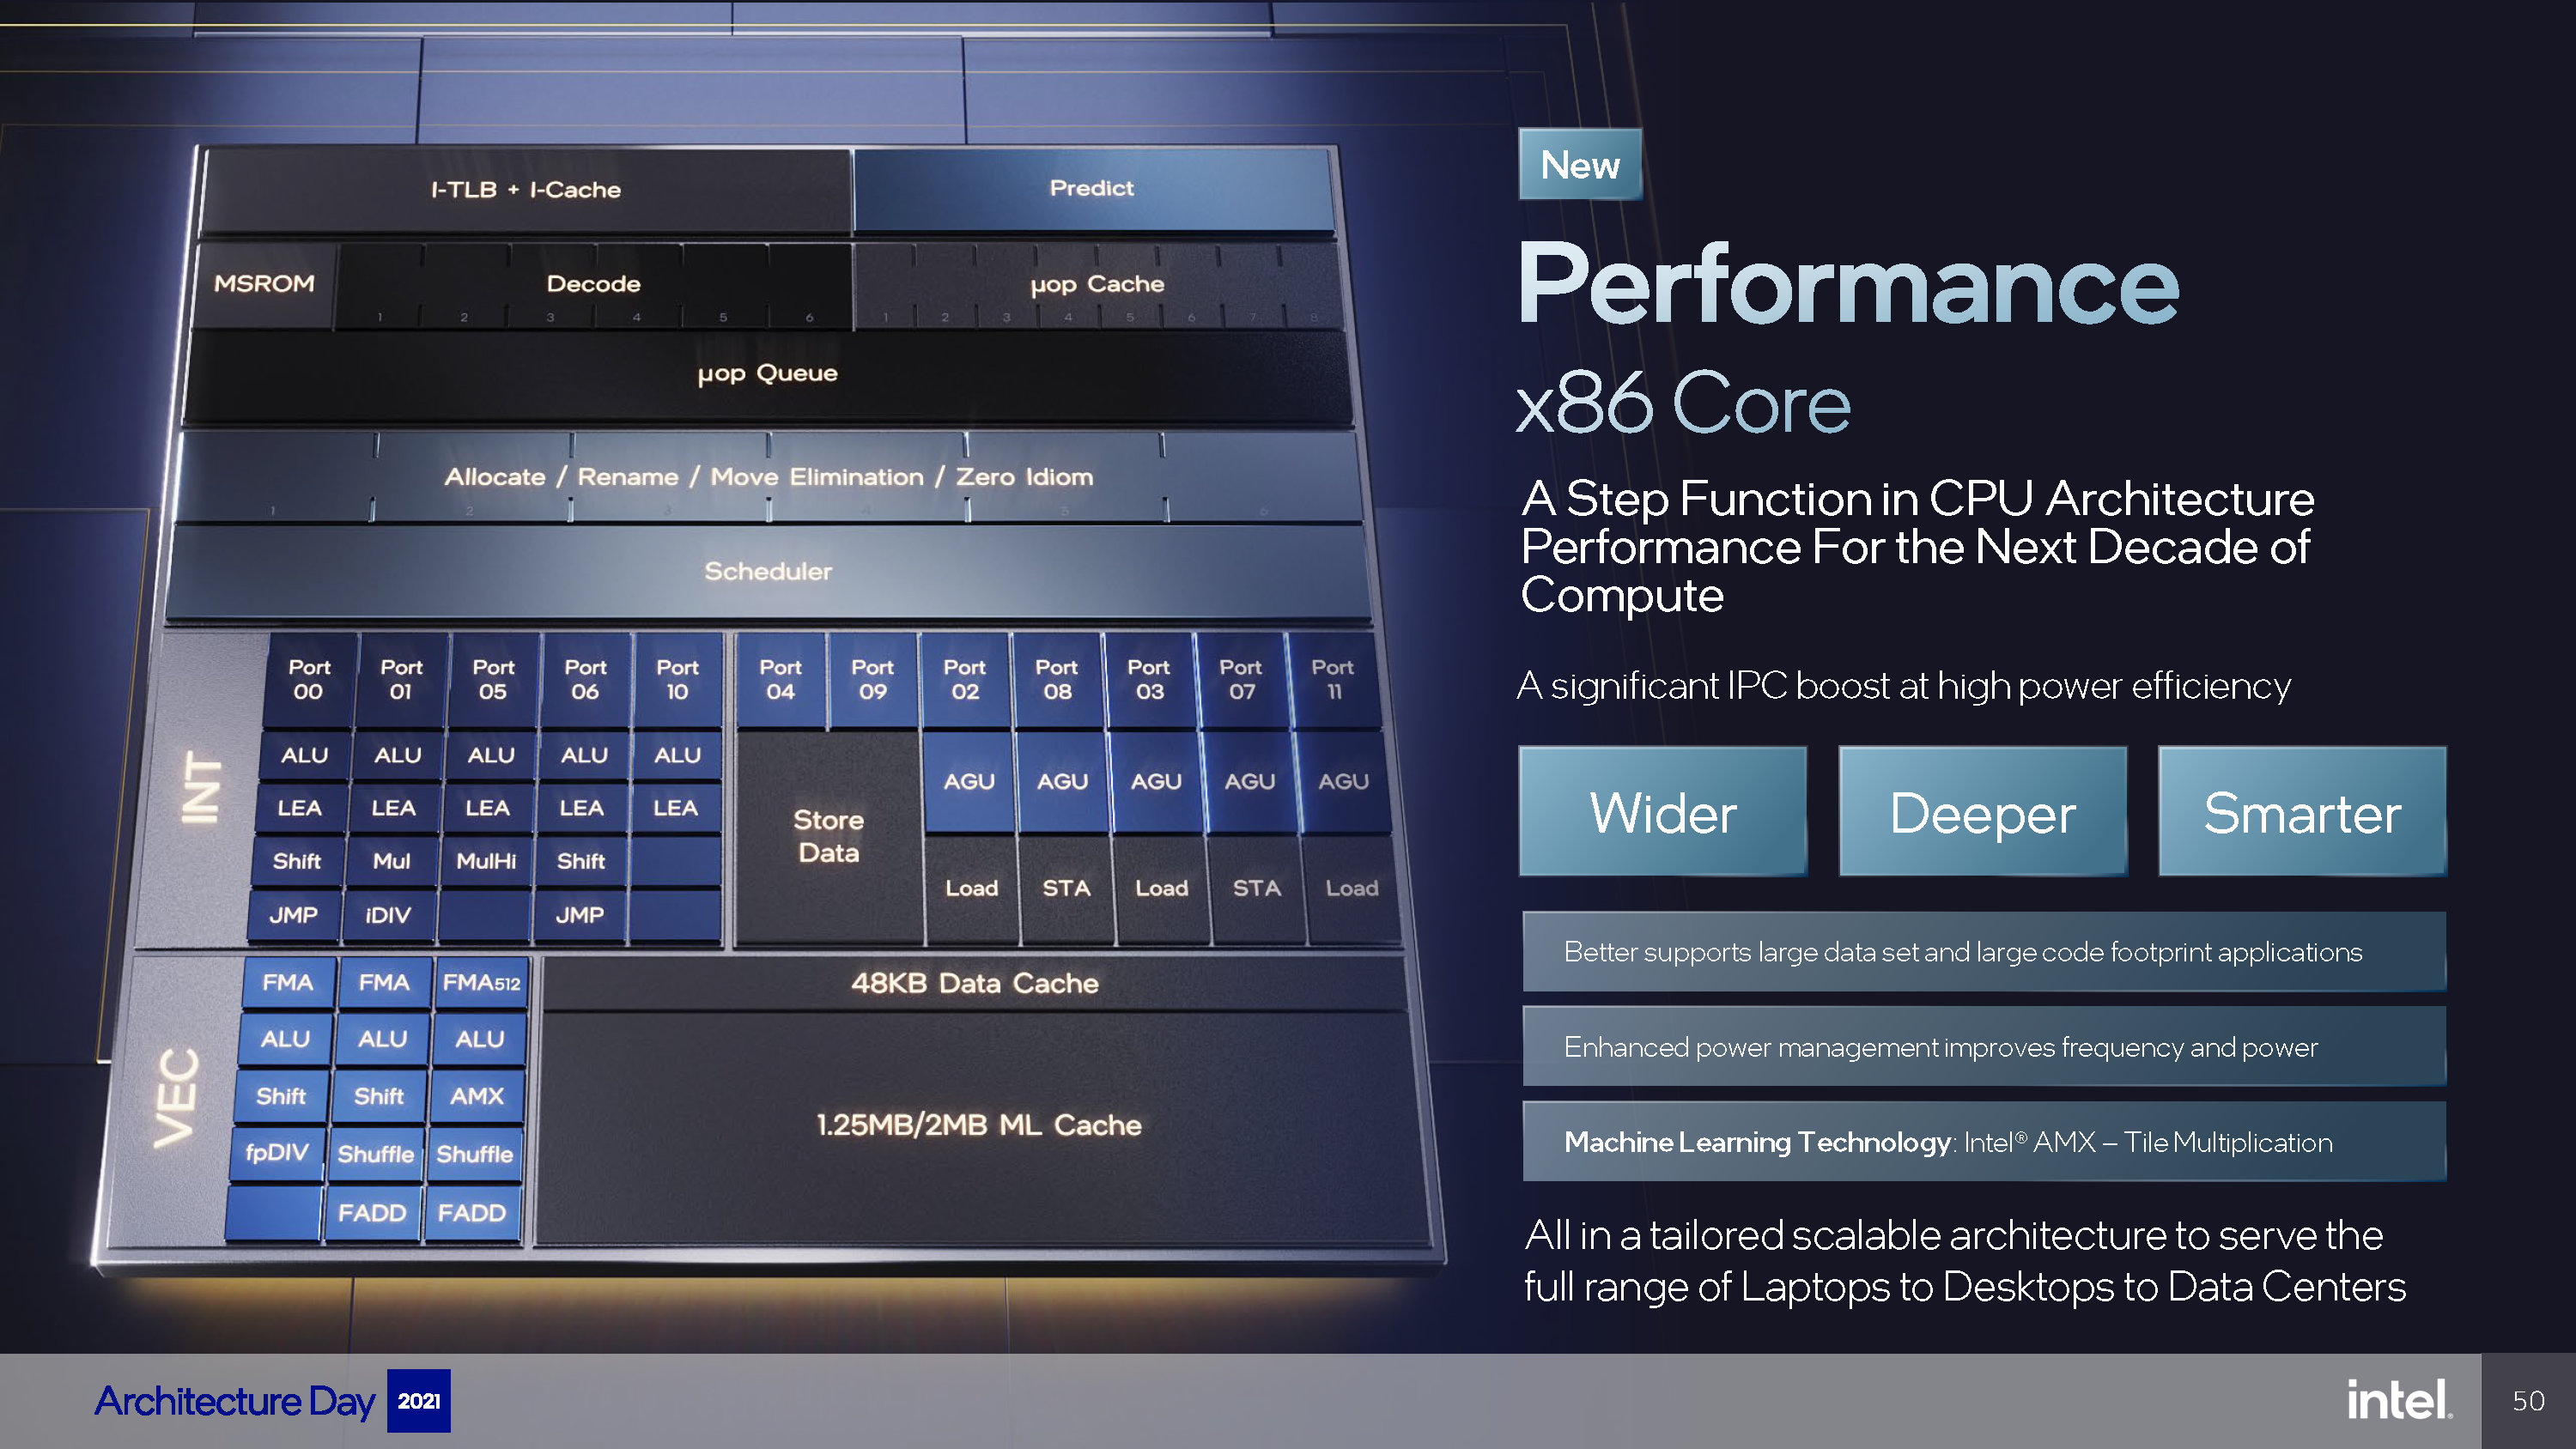
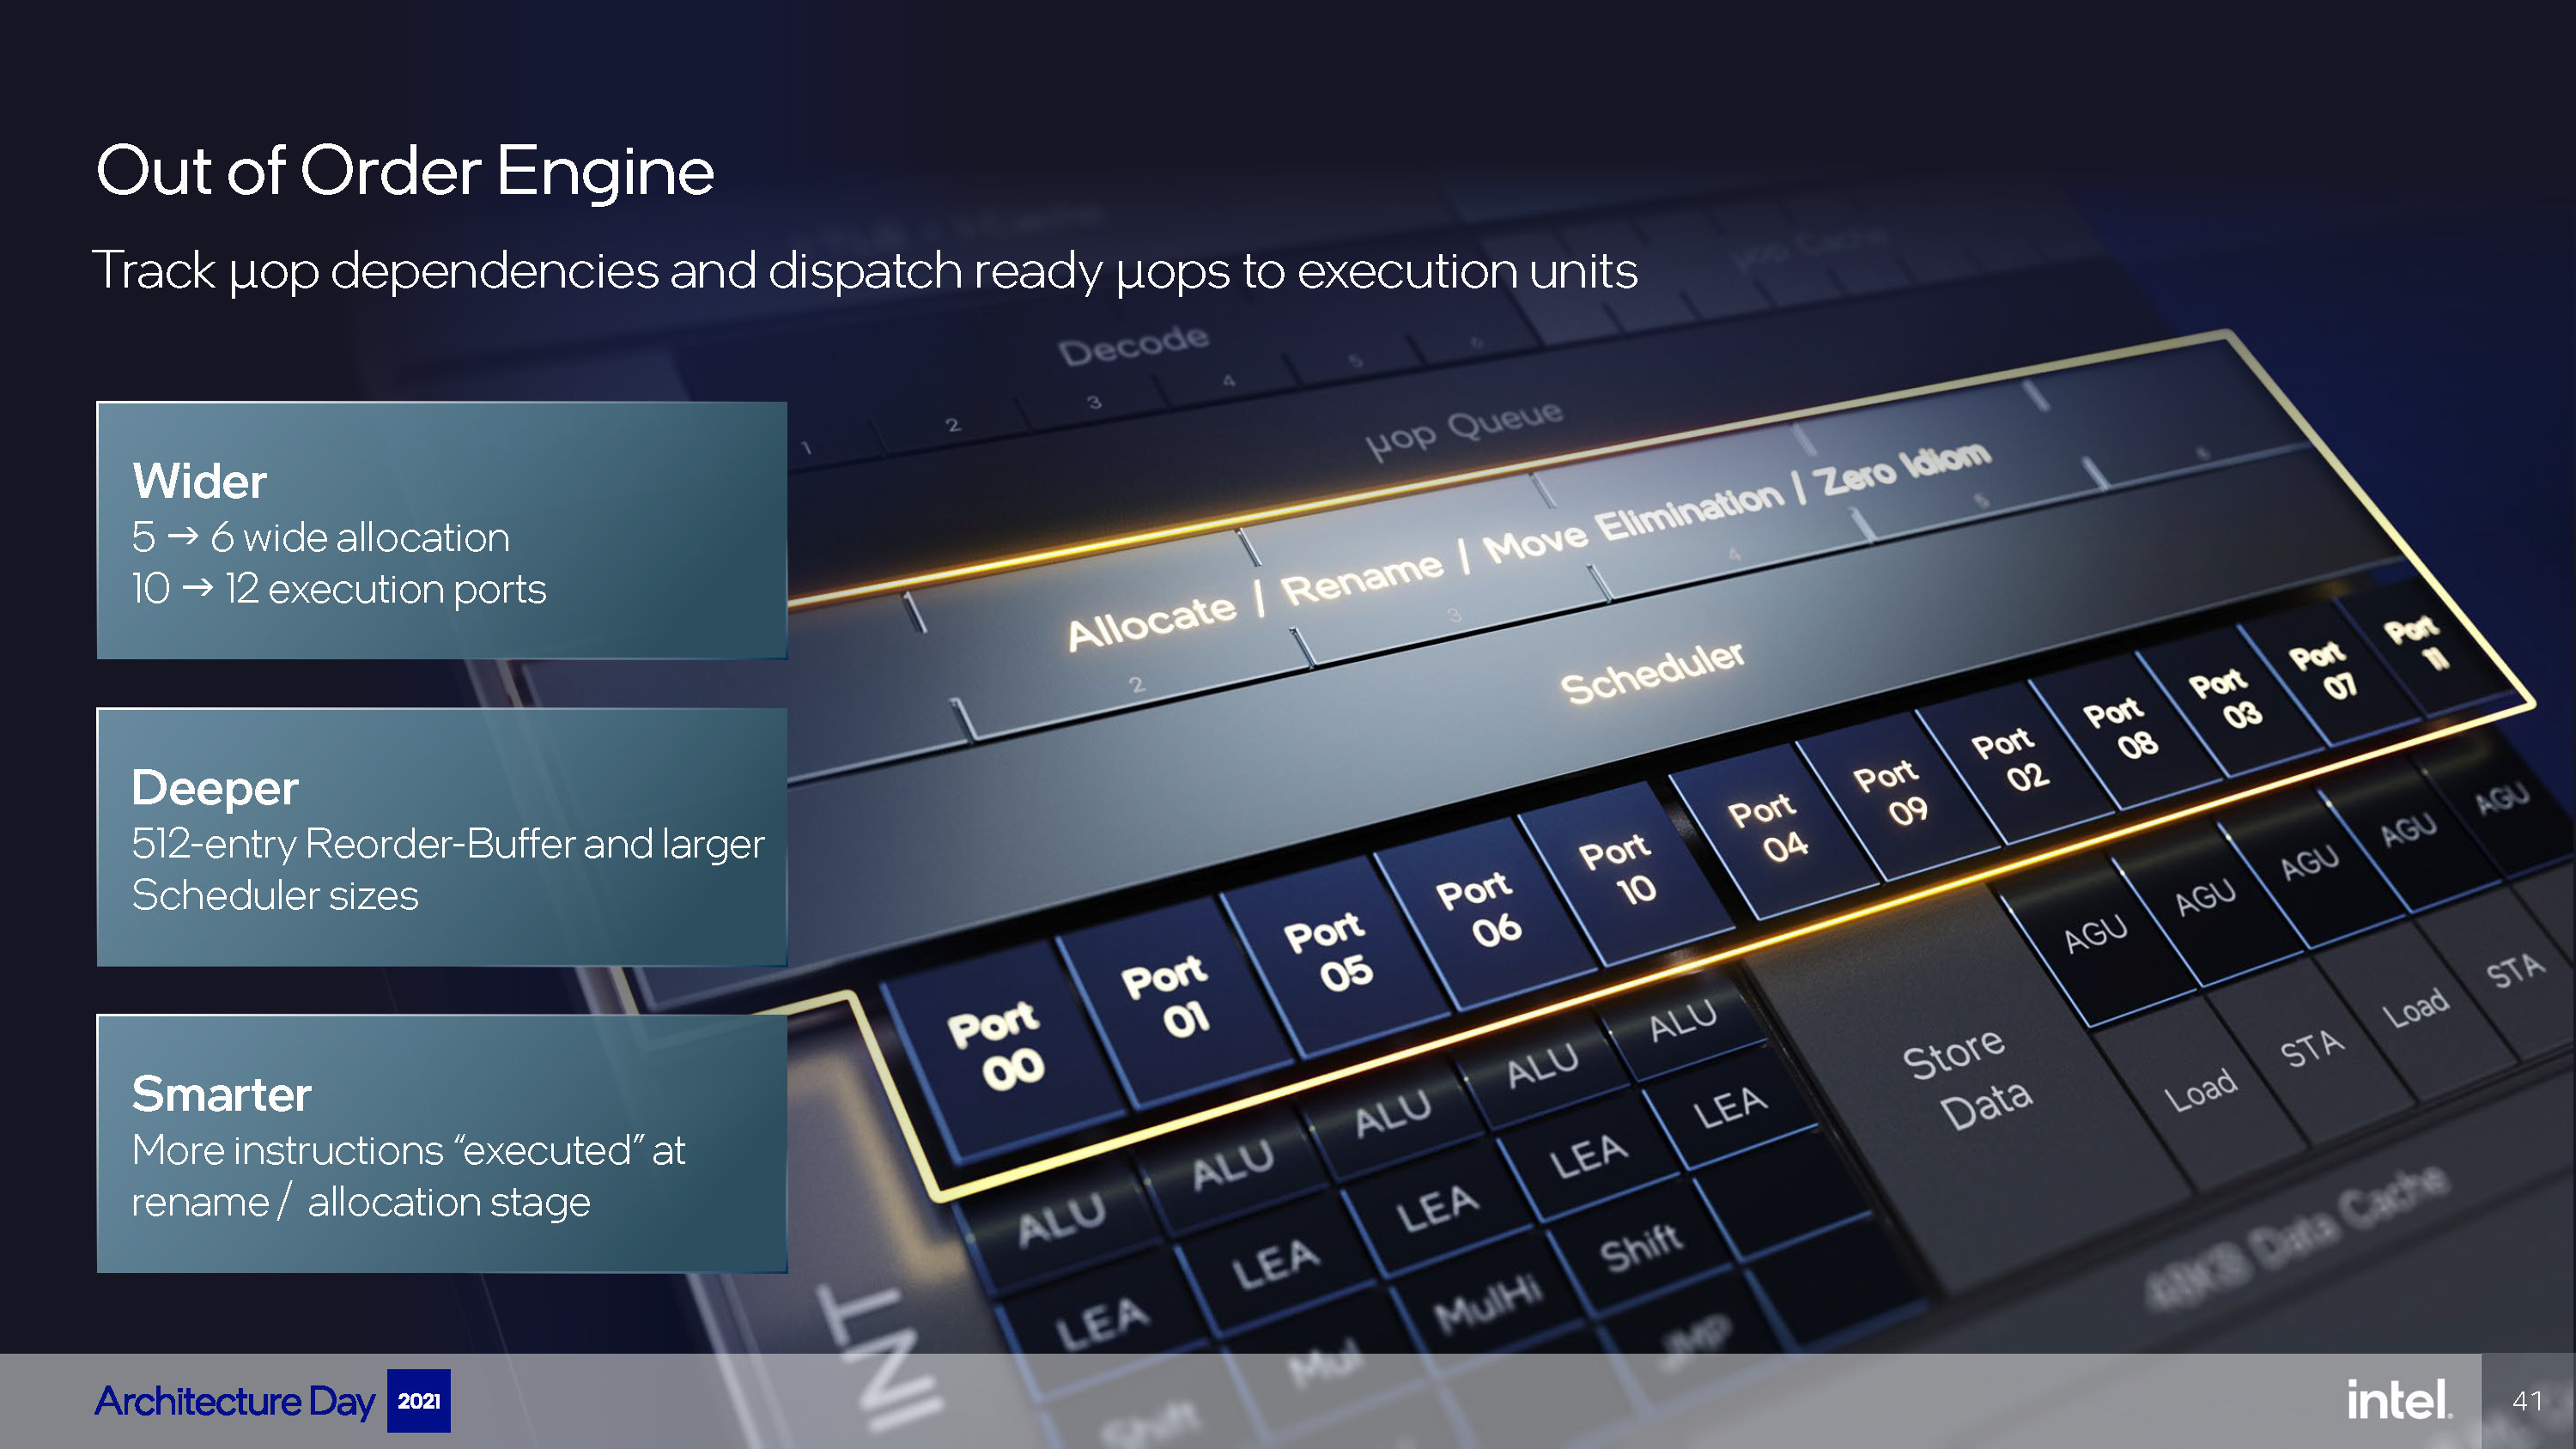
中核部分,同步变得更宽,发射区从原本的5宽度加宽到6宽度,ROB缓存从Sunny Cove的384加大到512,直逼苹果Firestorm内核的600+,ROB增大会显著增加内核功耗。另外,执行端口方面增加两个,现在共有12个端口,不过整数和浮点仍然共用发射端口,没有改成流行的分离式。

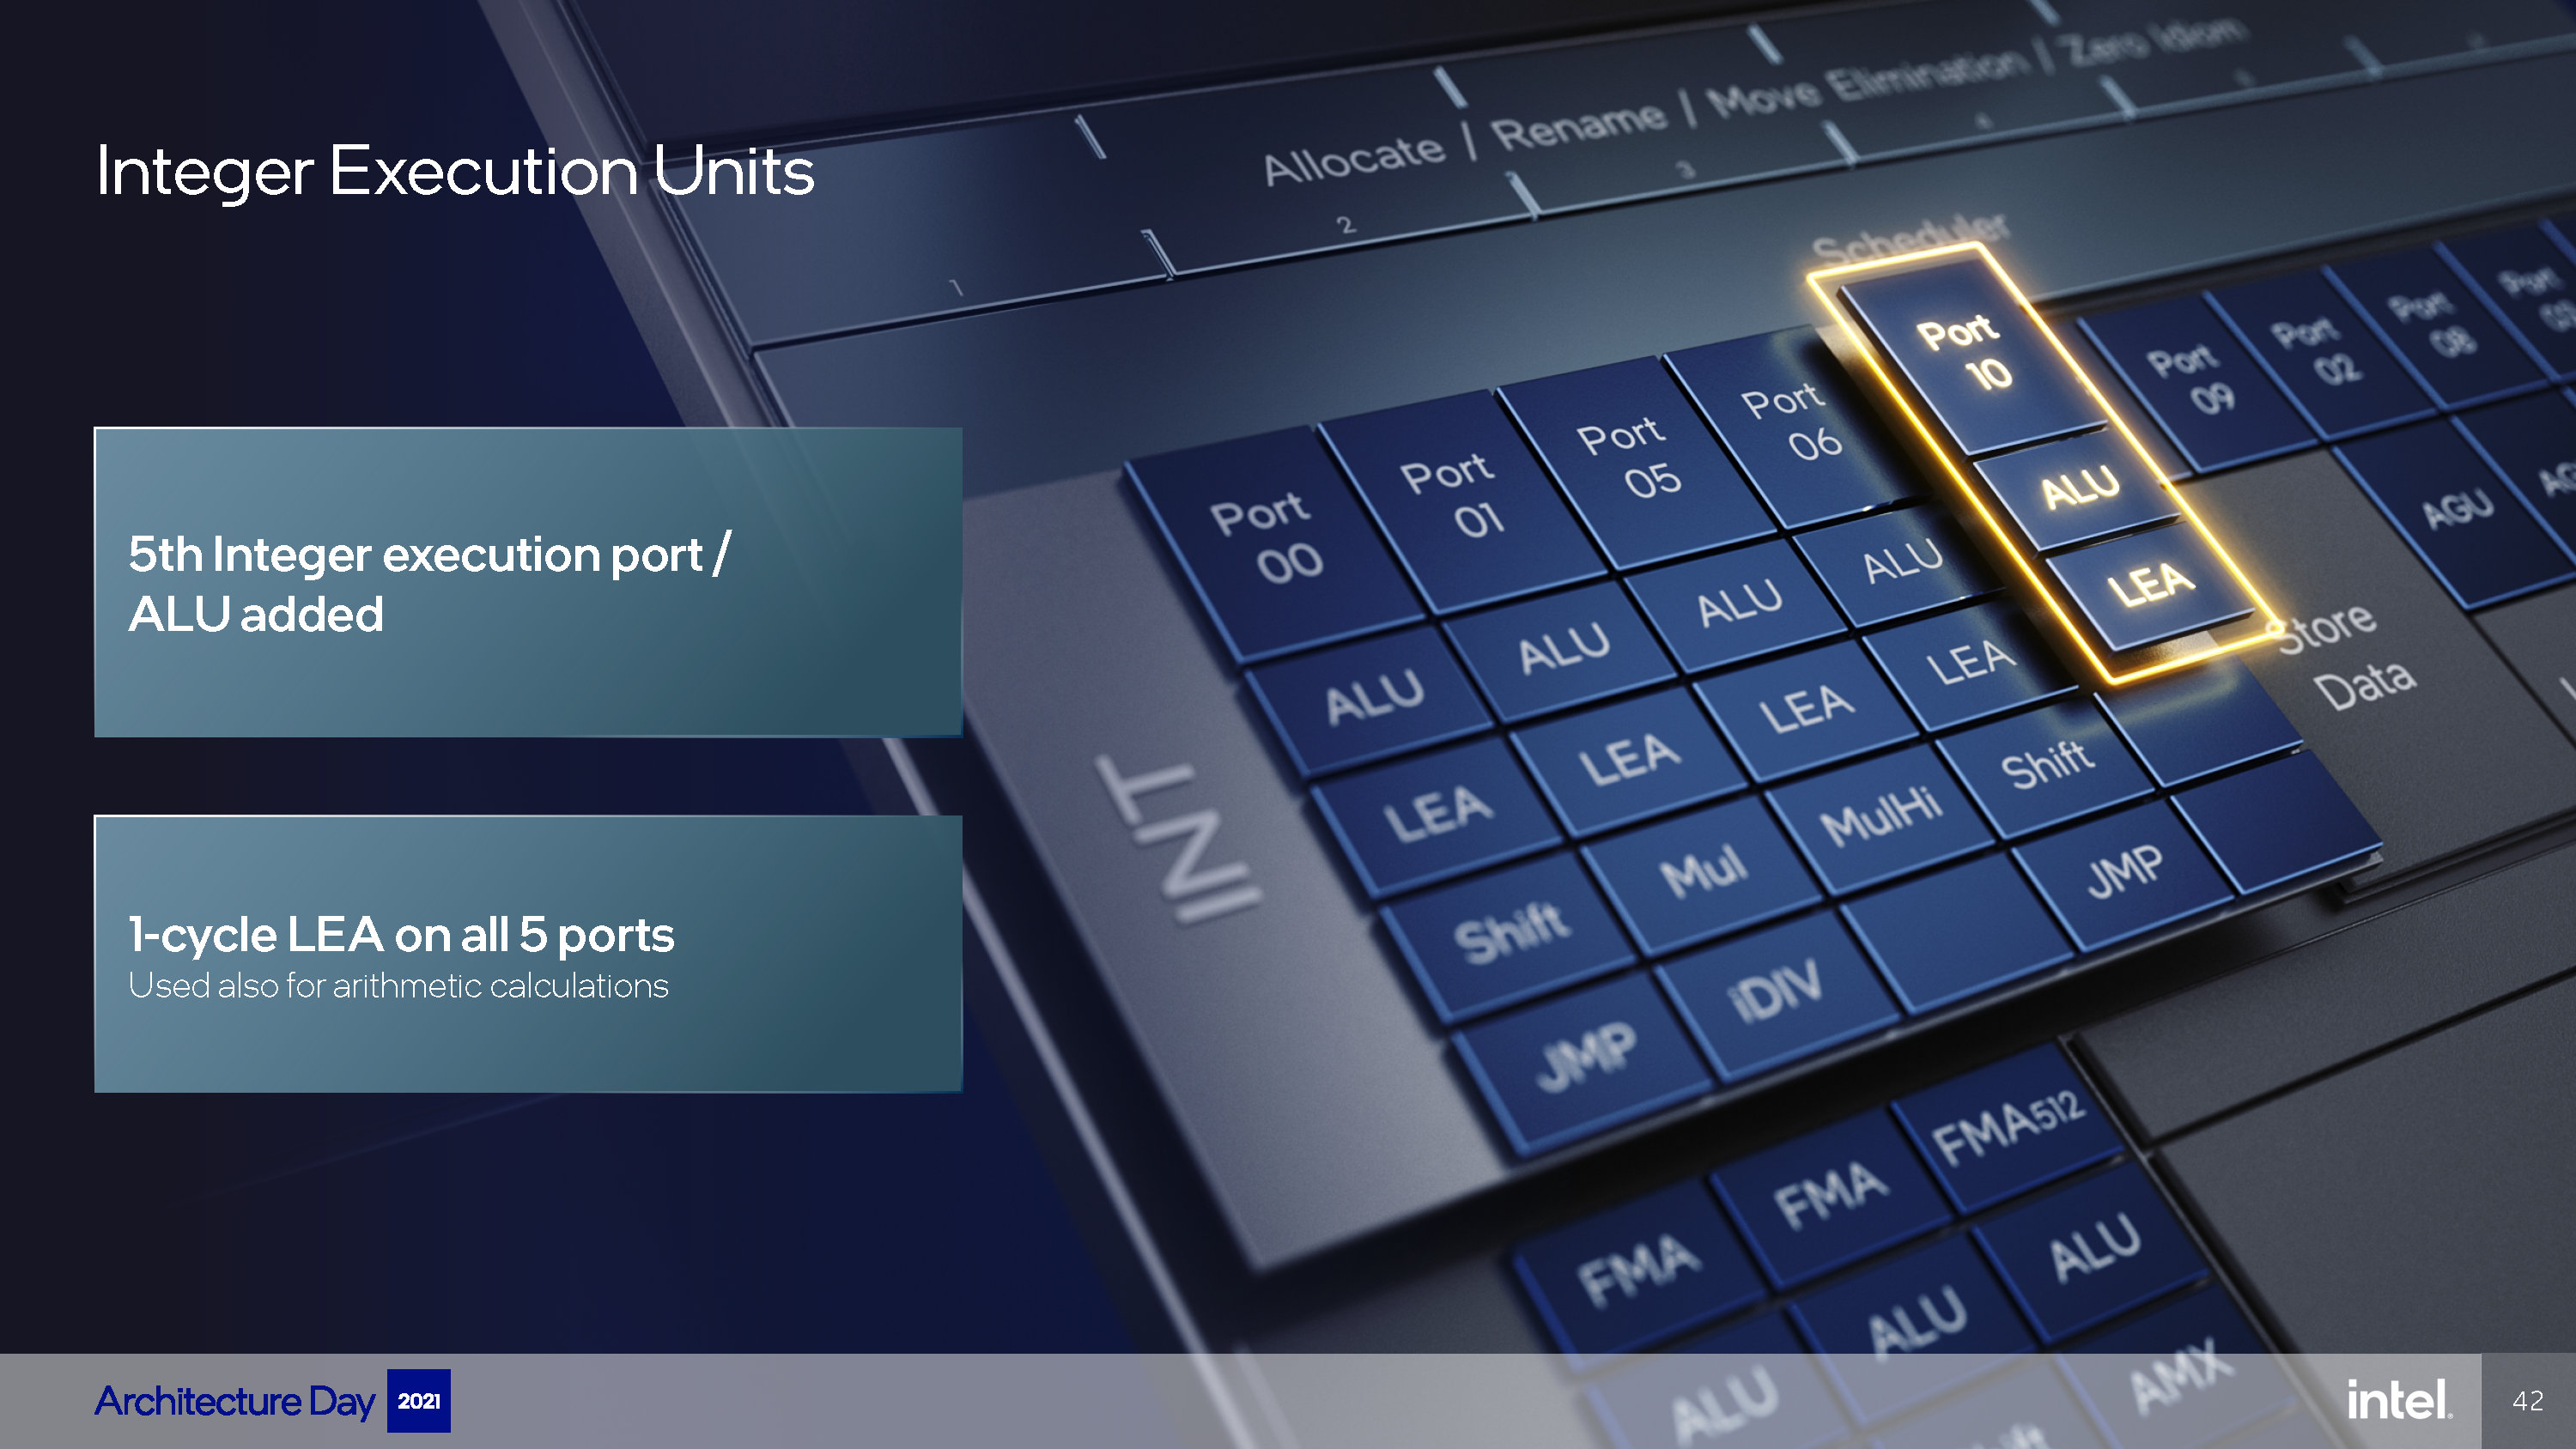
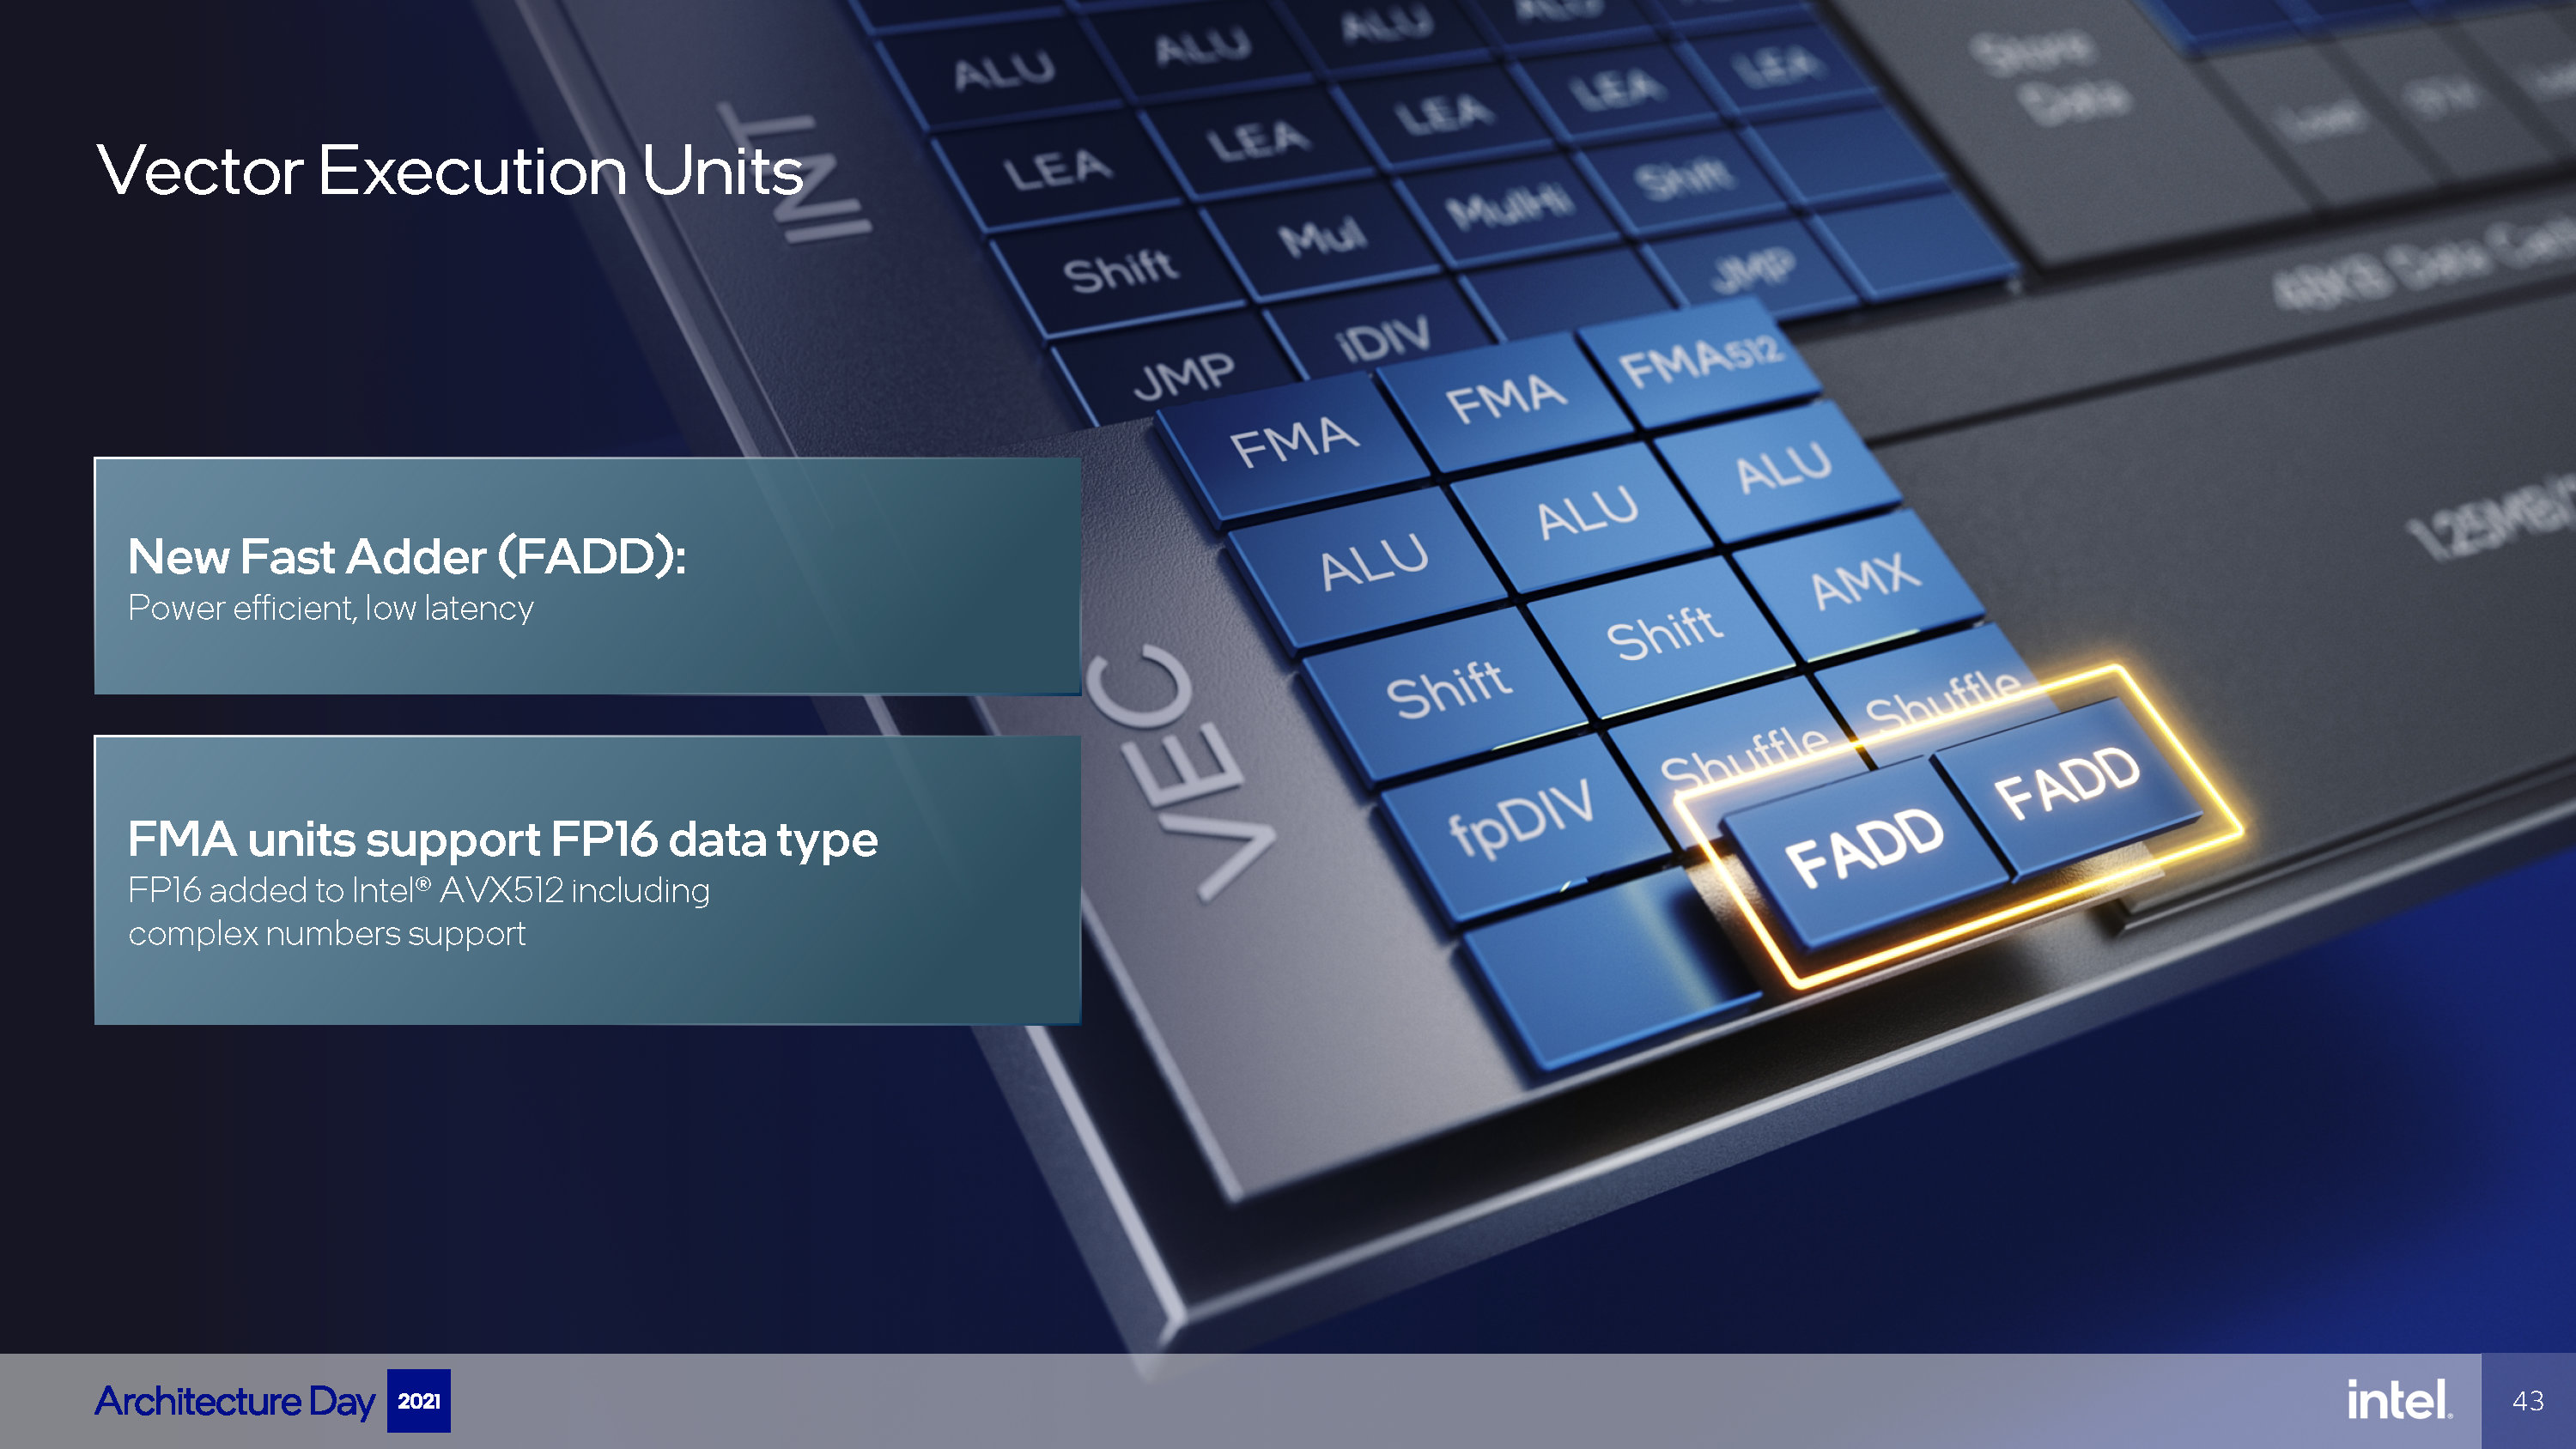
虽然是共用端口,不过Intel还是把整数和浮点的改进分开讲了。后端执行部分的改动相对较小,从上面两张图中可以看到,整数部分增加了一个ALU;FPU部分增加了两个FADD单元,它比FMA单元更高效,指令周期也更短了;而FMA单元增加了对FP16数据的支持,对低精度计算有帮助,不过因为需要调用AVX-512指令集,所以在Alder Lake上我们无法利用到它。

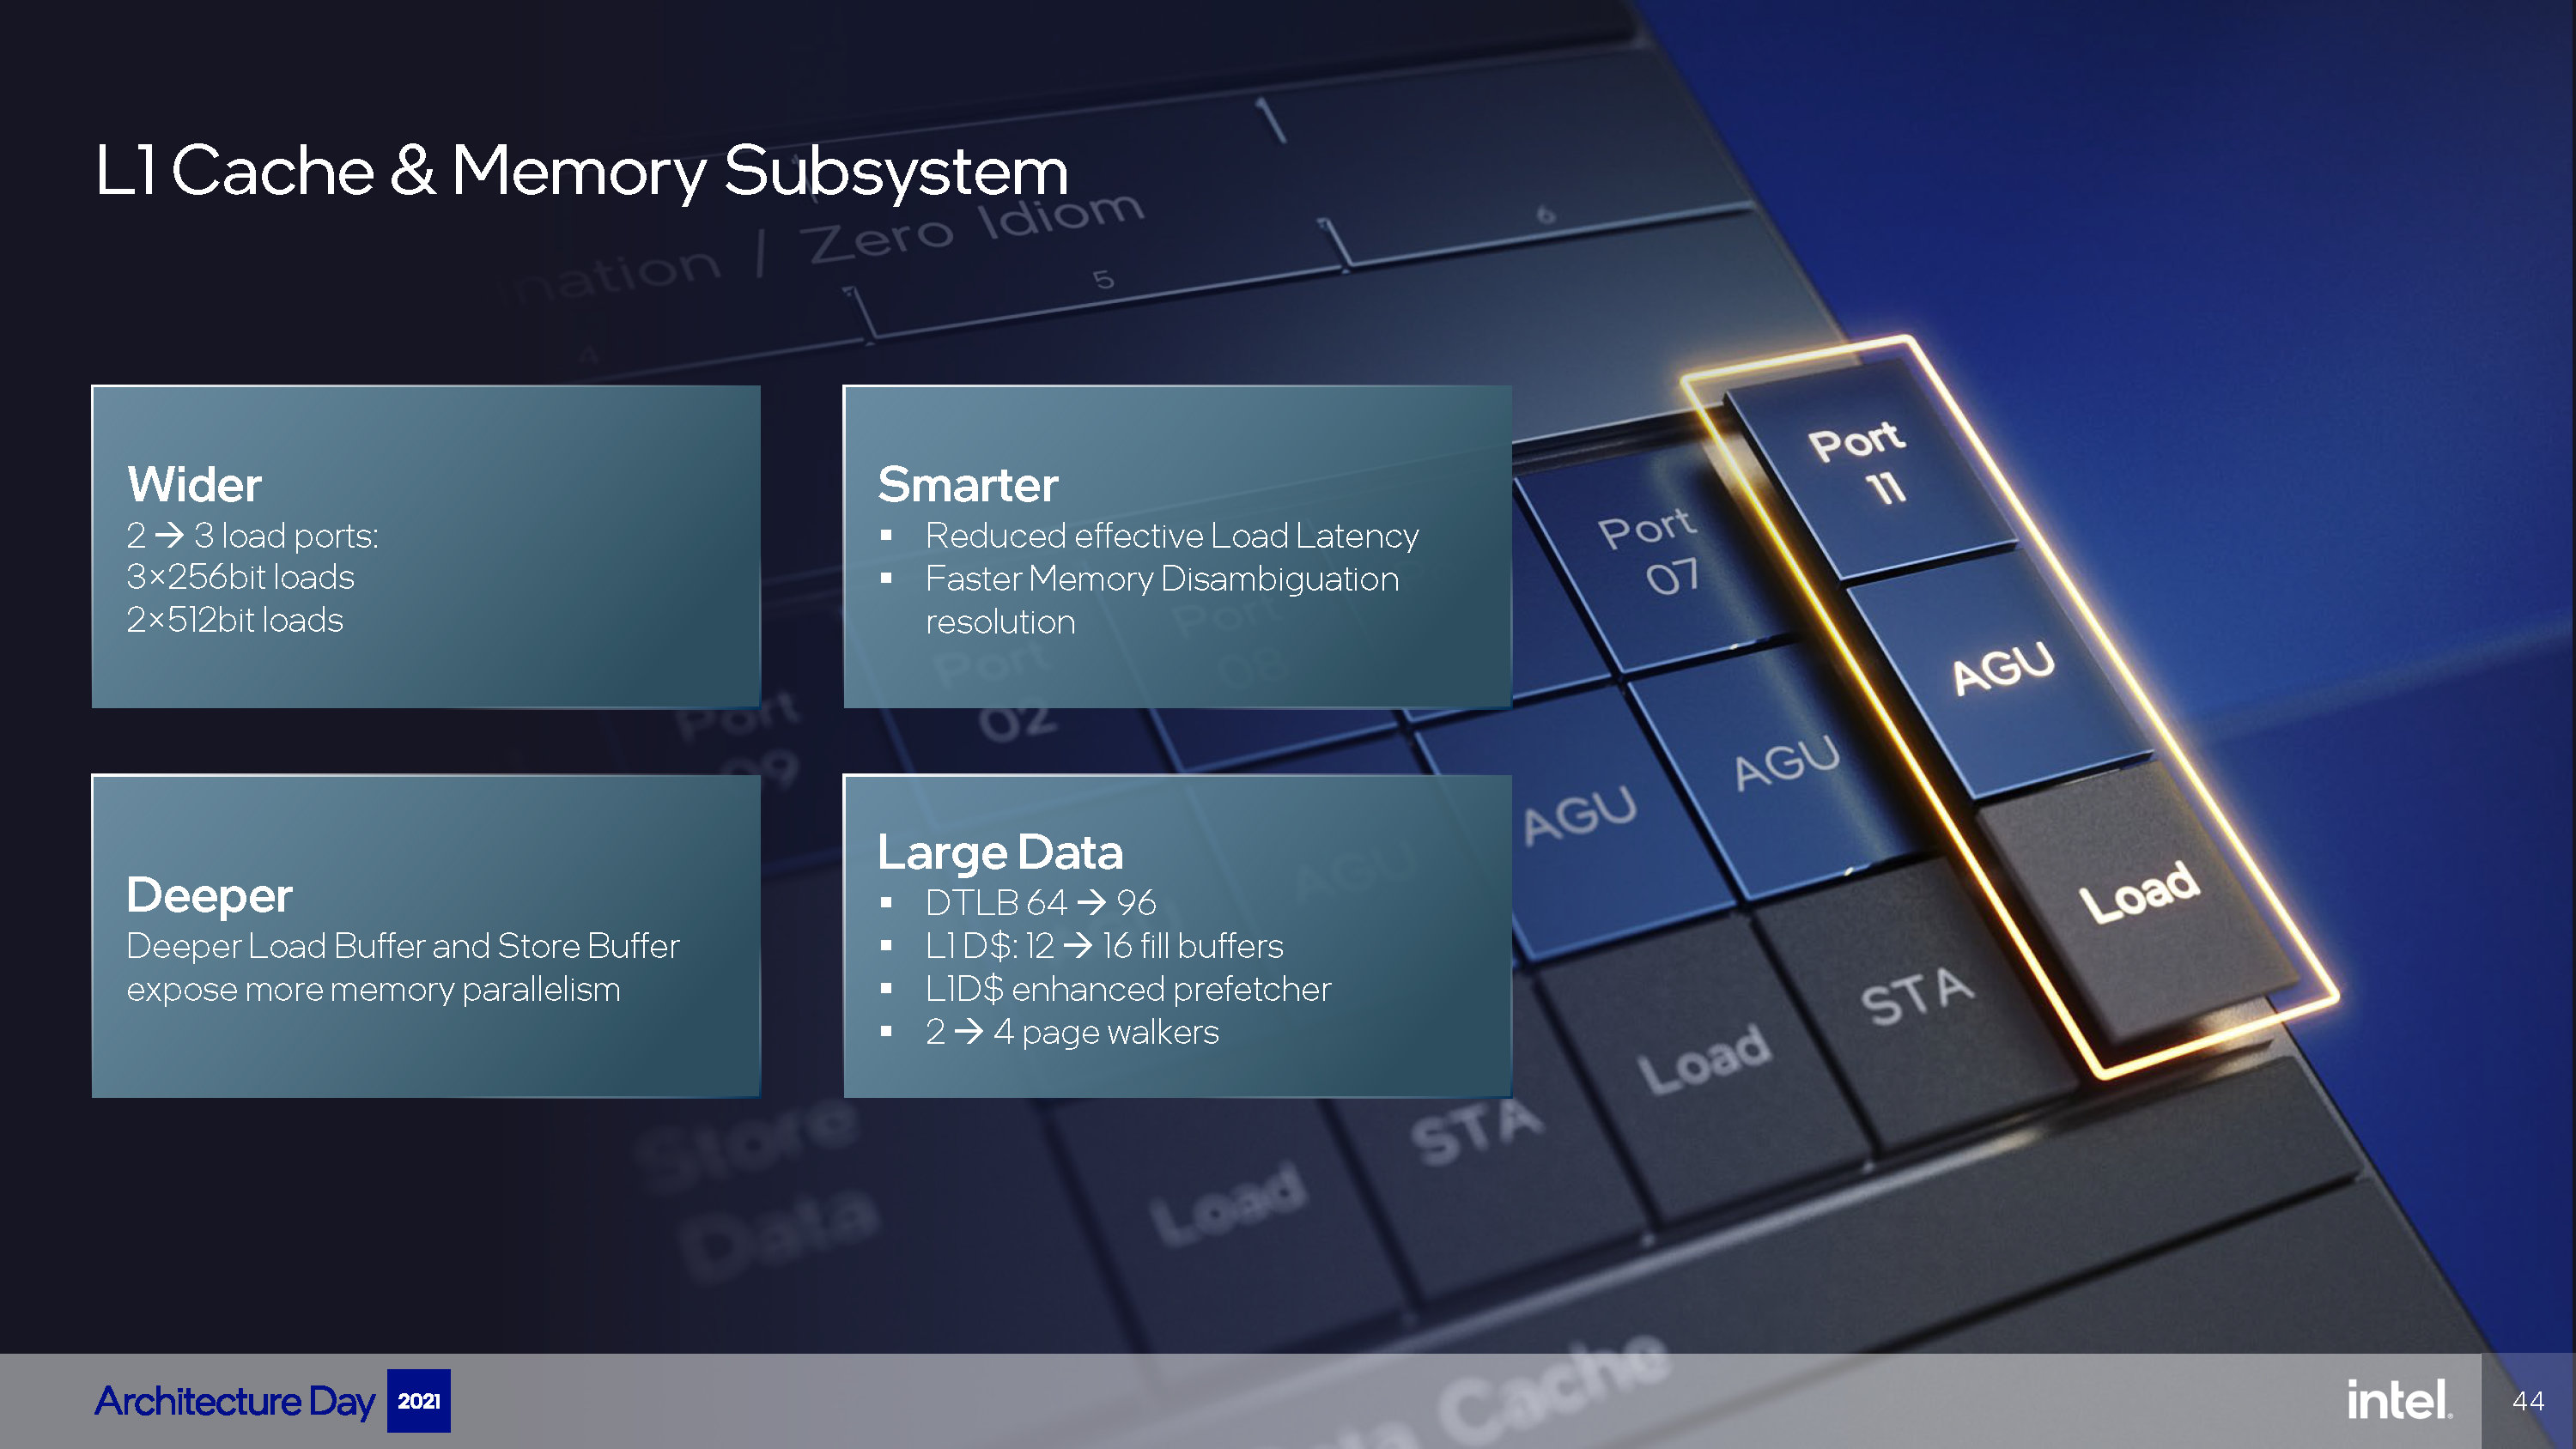
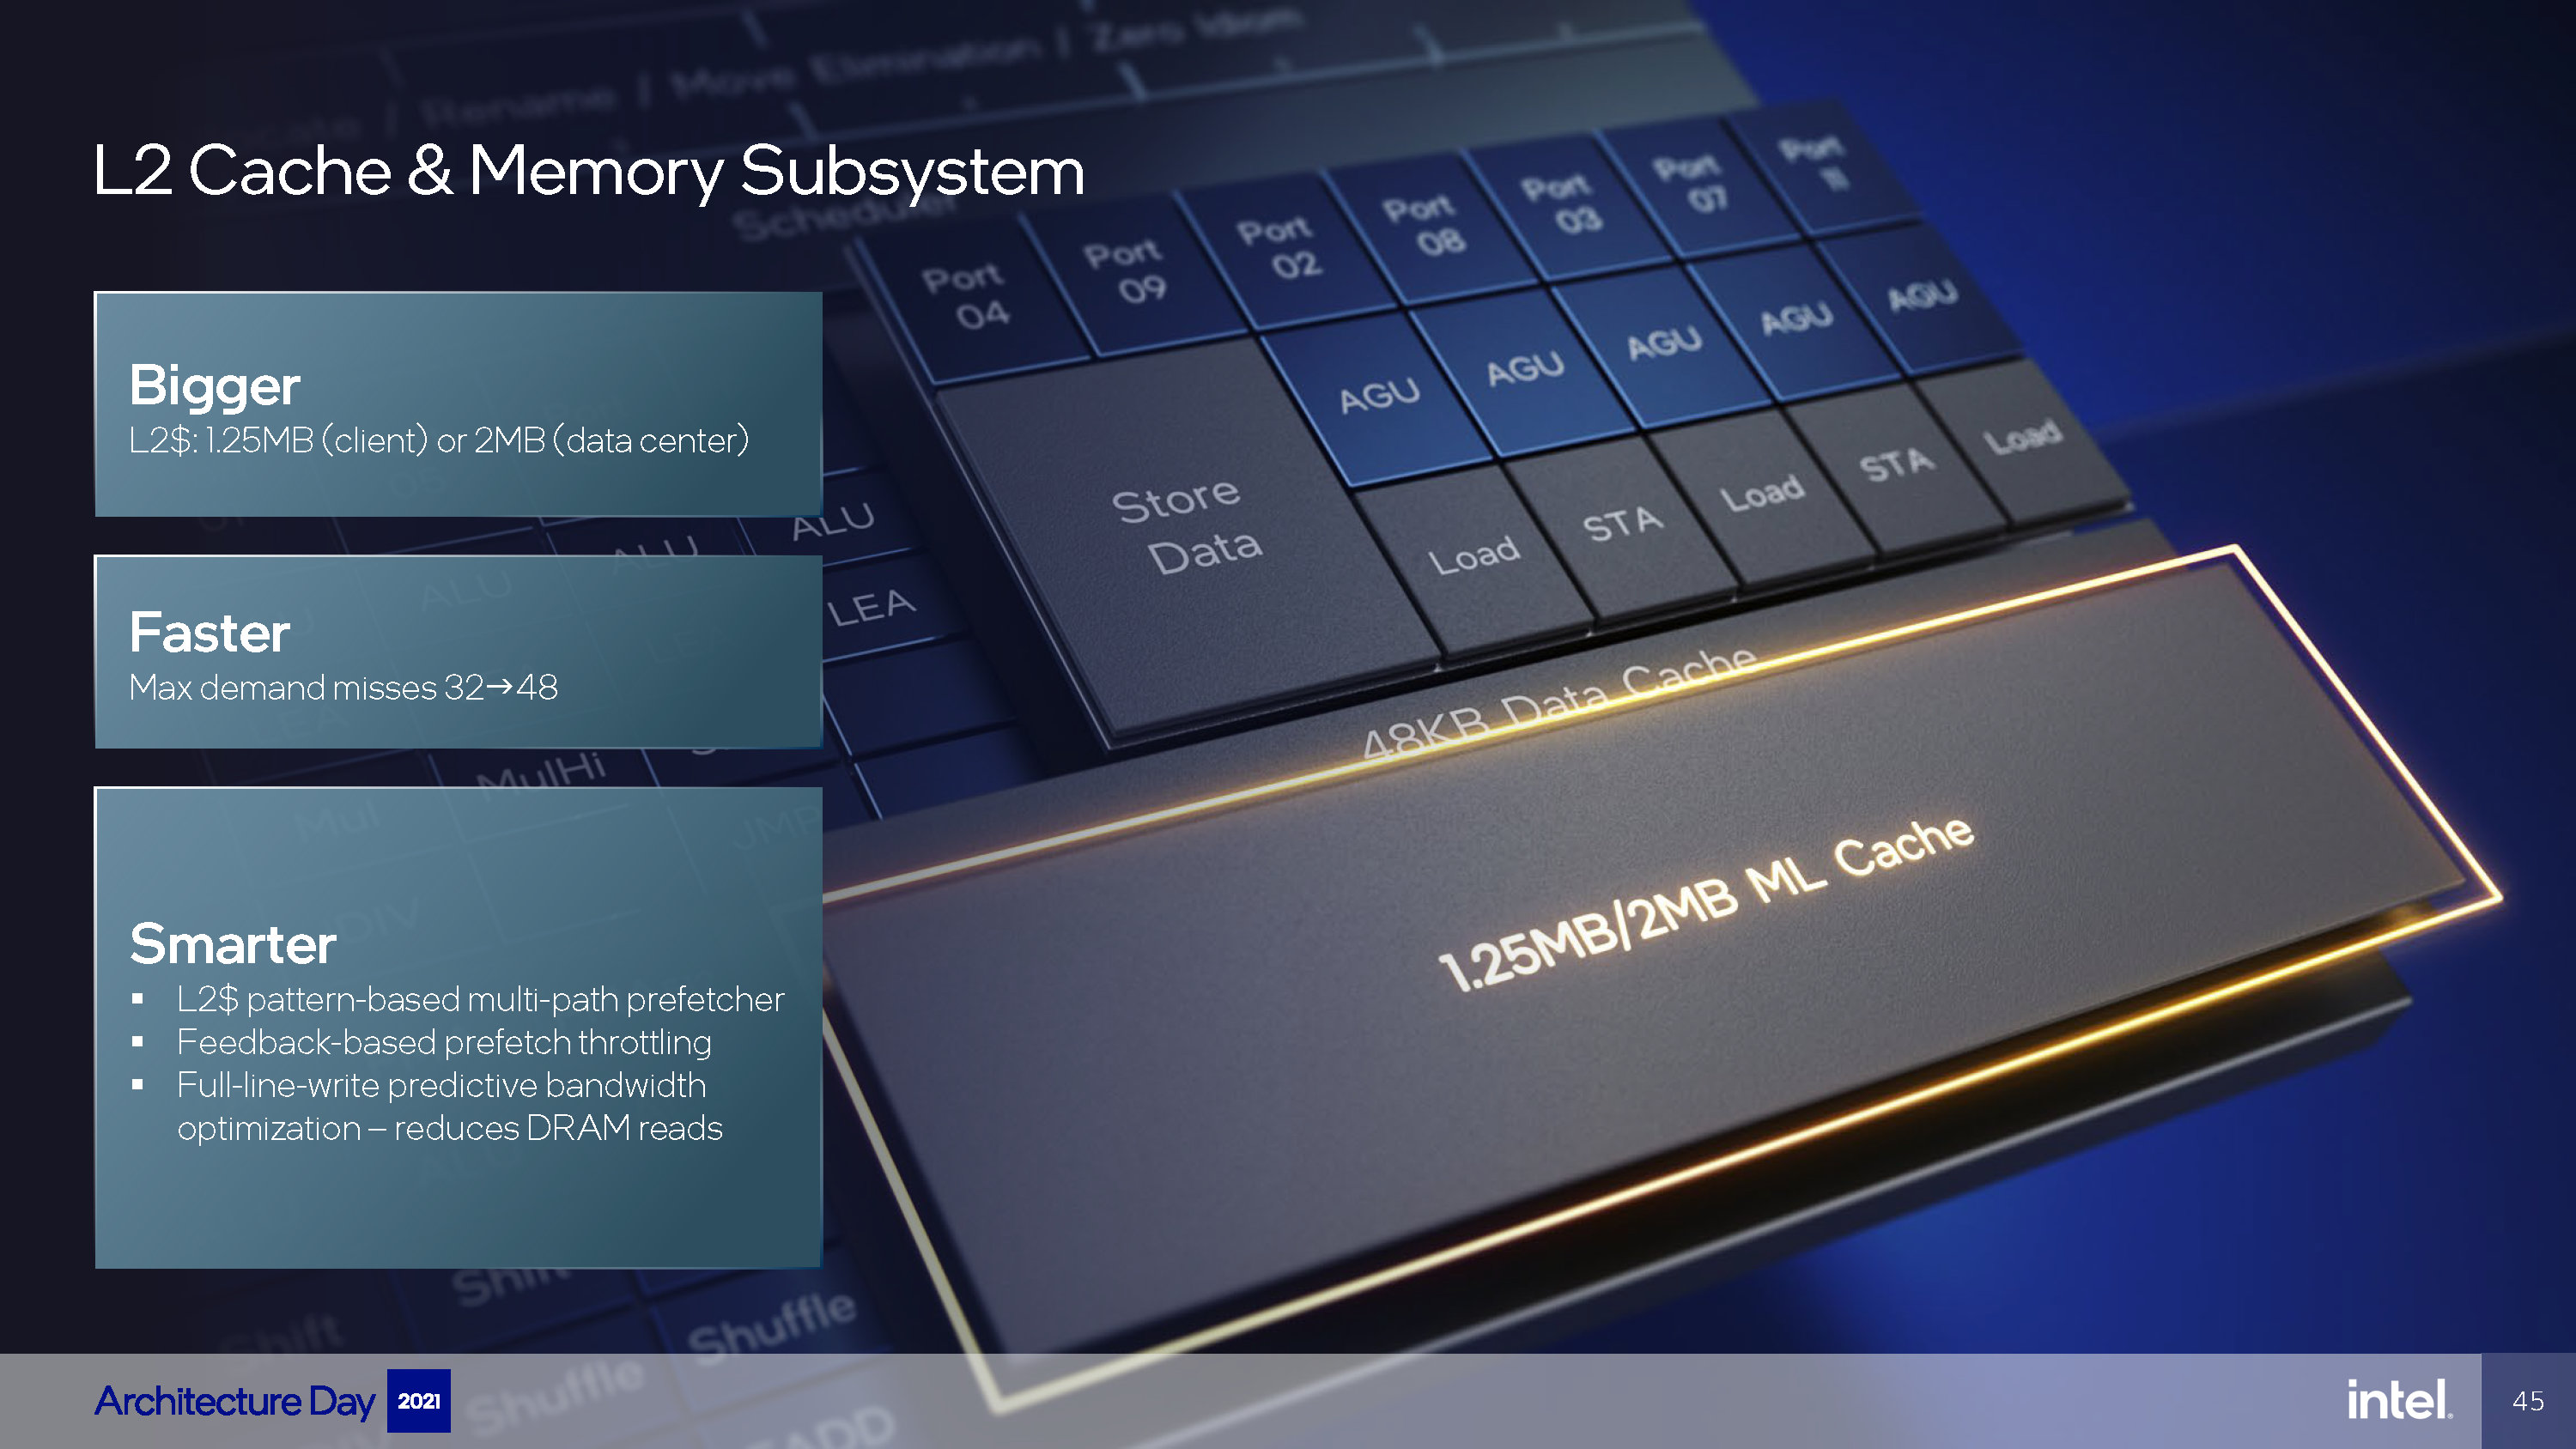
另一个新增的端口被用于缓存子系统,新增了一个Load AGU,这样每周期的Load带宽提升至3,和Zen 3持平。L2沿用Willow Cove的设计,仍然是非包含式设计,每核心具有1.25MB。不过加入了新的预取机制,降低了DRAM的读取次数。

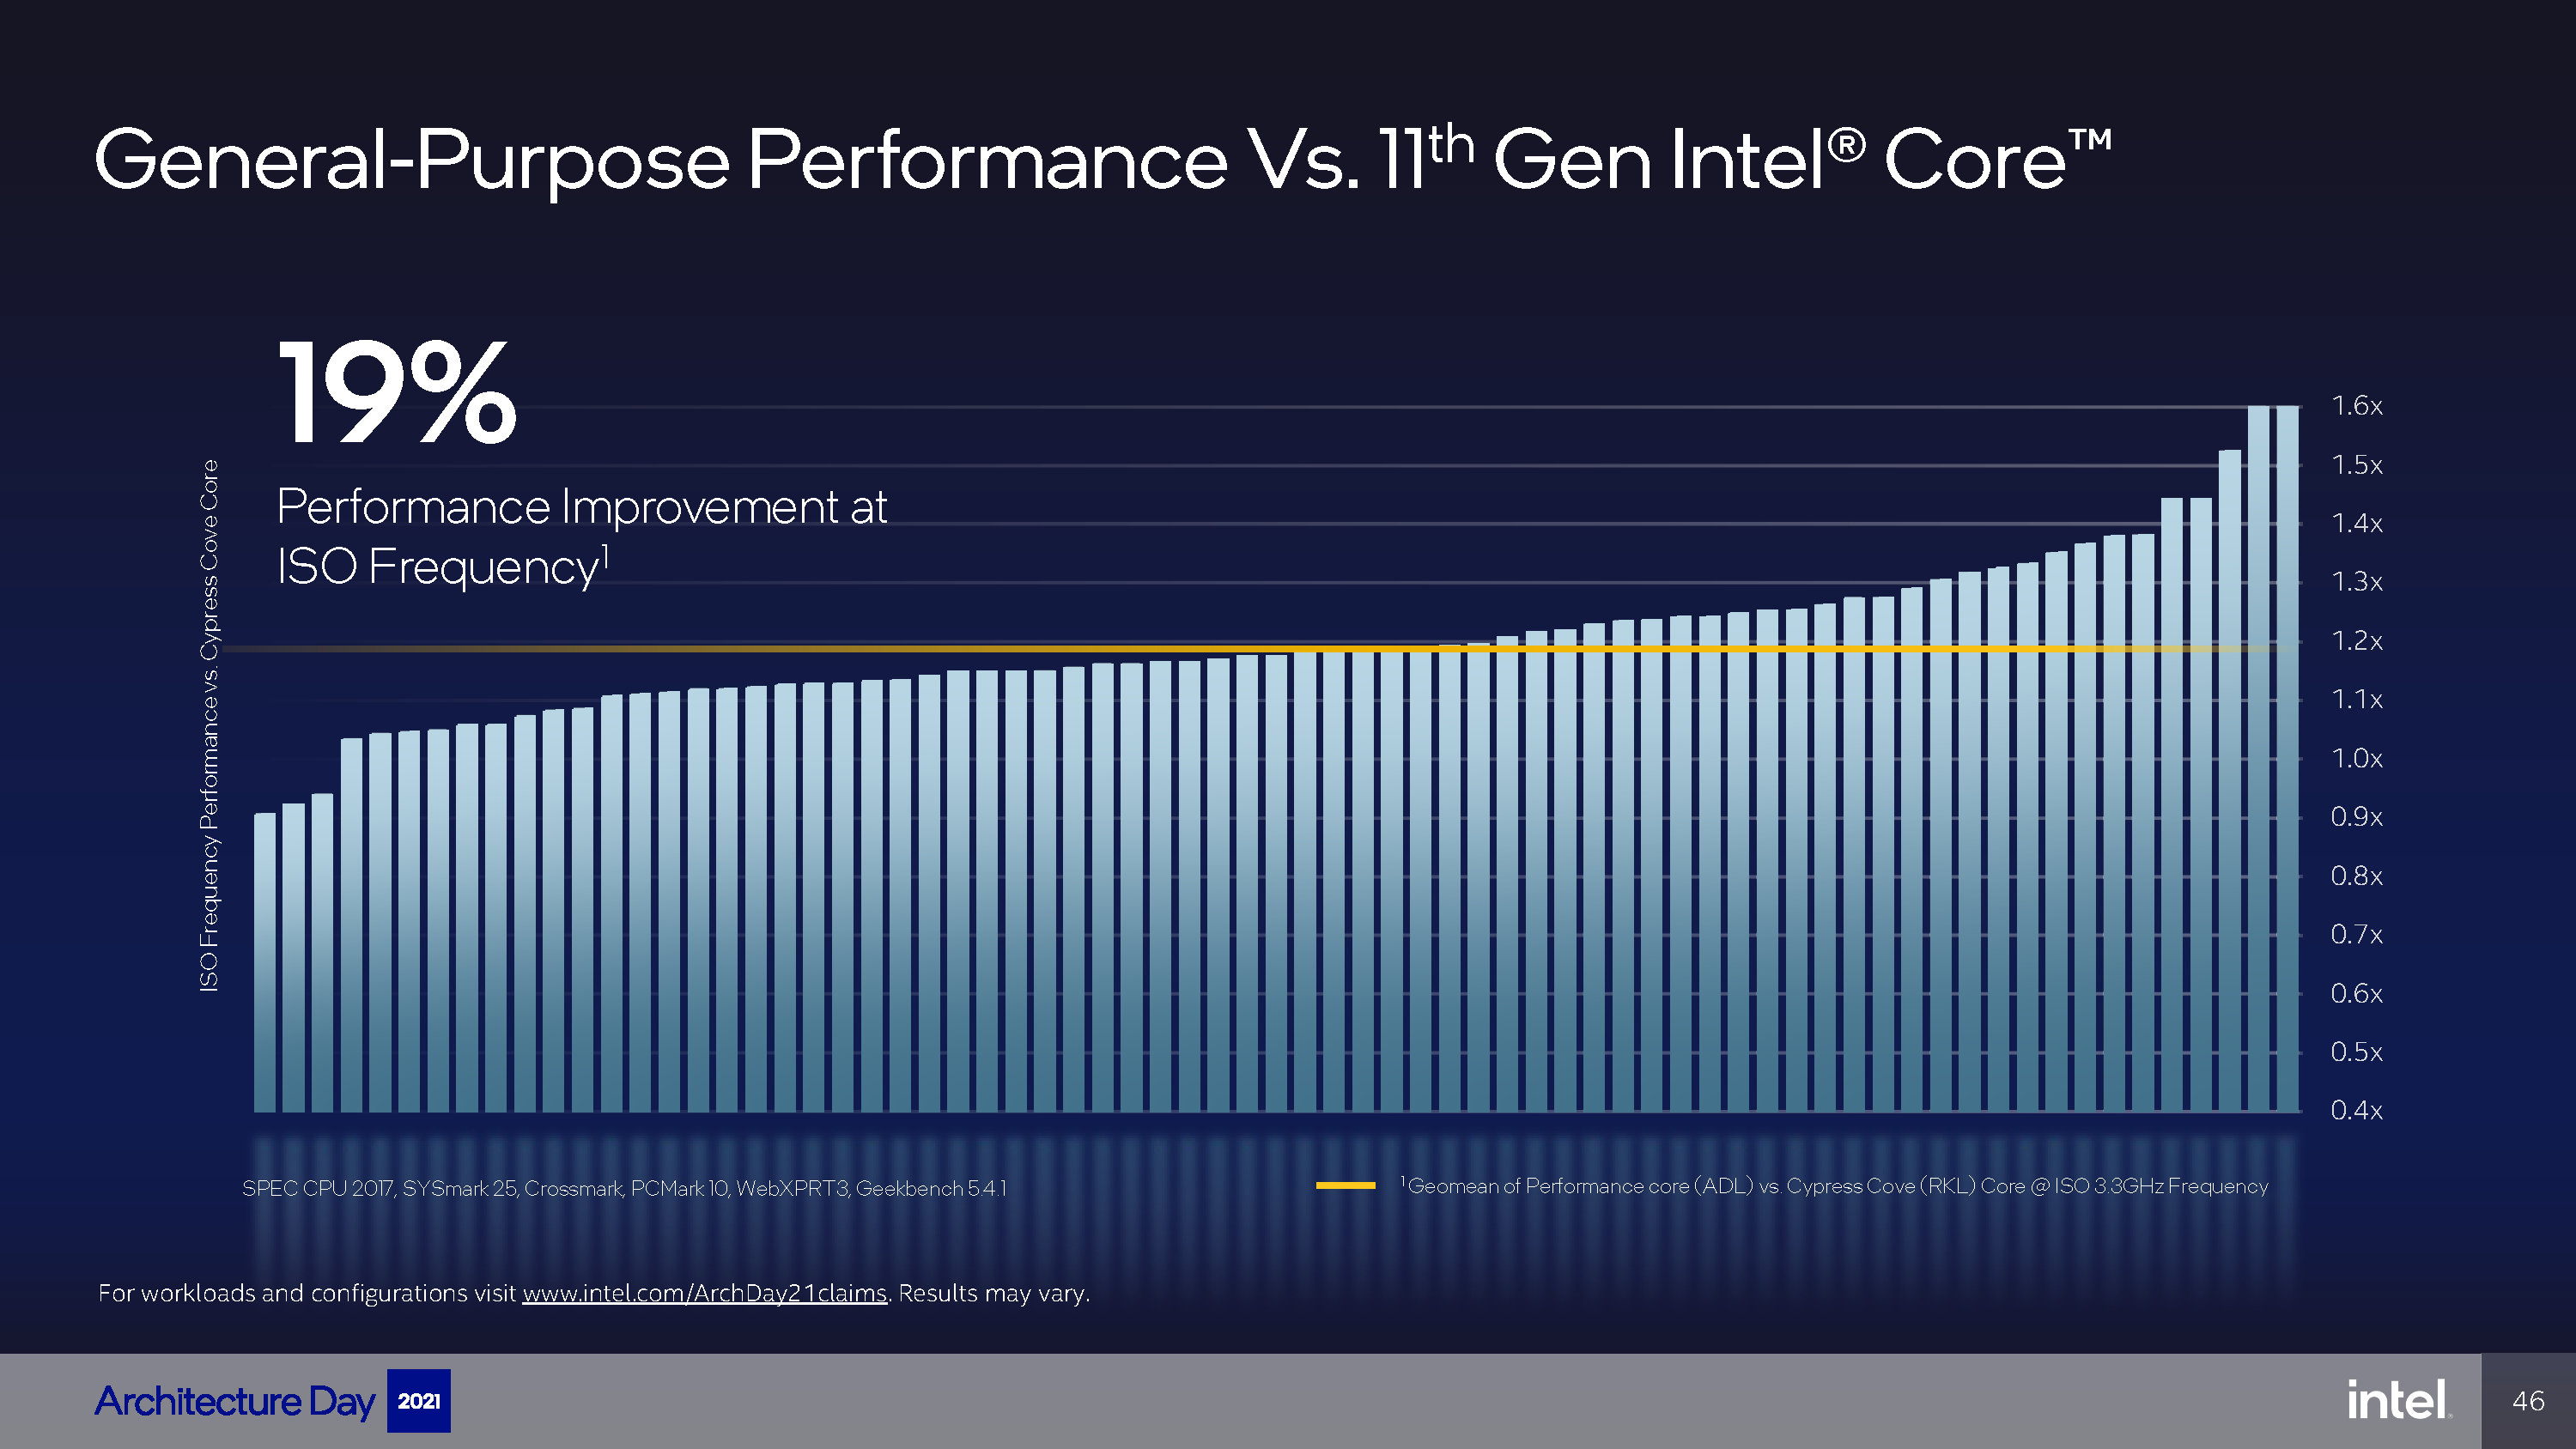
总的改进加起来让Golden Cove相比起Cypress Core有了平均约19%的同频性能提升,最高甚至能有60%左右的提升。不过比较奇怪的是,有几个项目的成绩出现了倒退。总的来说,Golden Cove是一次全面的大改,可能是自Skylake以来改动最大的一个内核微架构。

Intel Thread Director:调度大小核的关键角色

大小核心的性能提升都非常可观,但要如何调度它们,让它们充分发挥自己的长处呢?其实Arm已经替x86淌过浑水了,big.LITTLE架构发展至今已有十余年时间,主流的操作系统都添加了对大小核的调度支持,包括Windows。操作系统是知道处理器上多个性能不同的内核的。但之前在Lakefield上我们也看到了Windows在调度大小核x86处理器时候的糟糕表现了,该怎么解决这个要命的问题呢?Intel选择了一个软硬件结合的方案,称为线程总监(Thread Director,暂译,等官方中文名)。

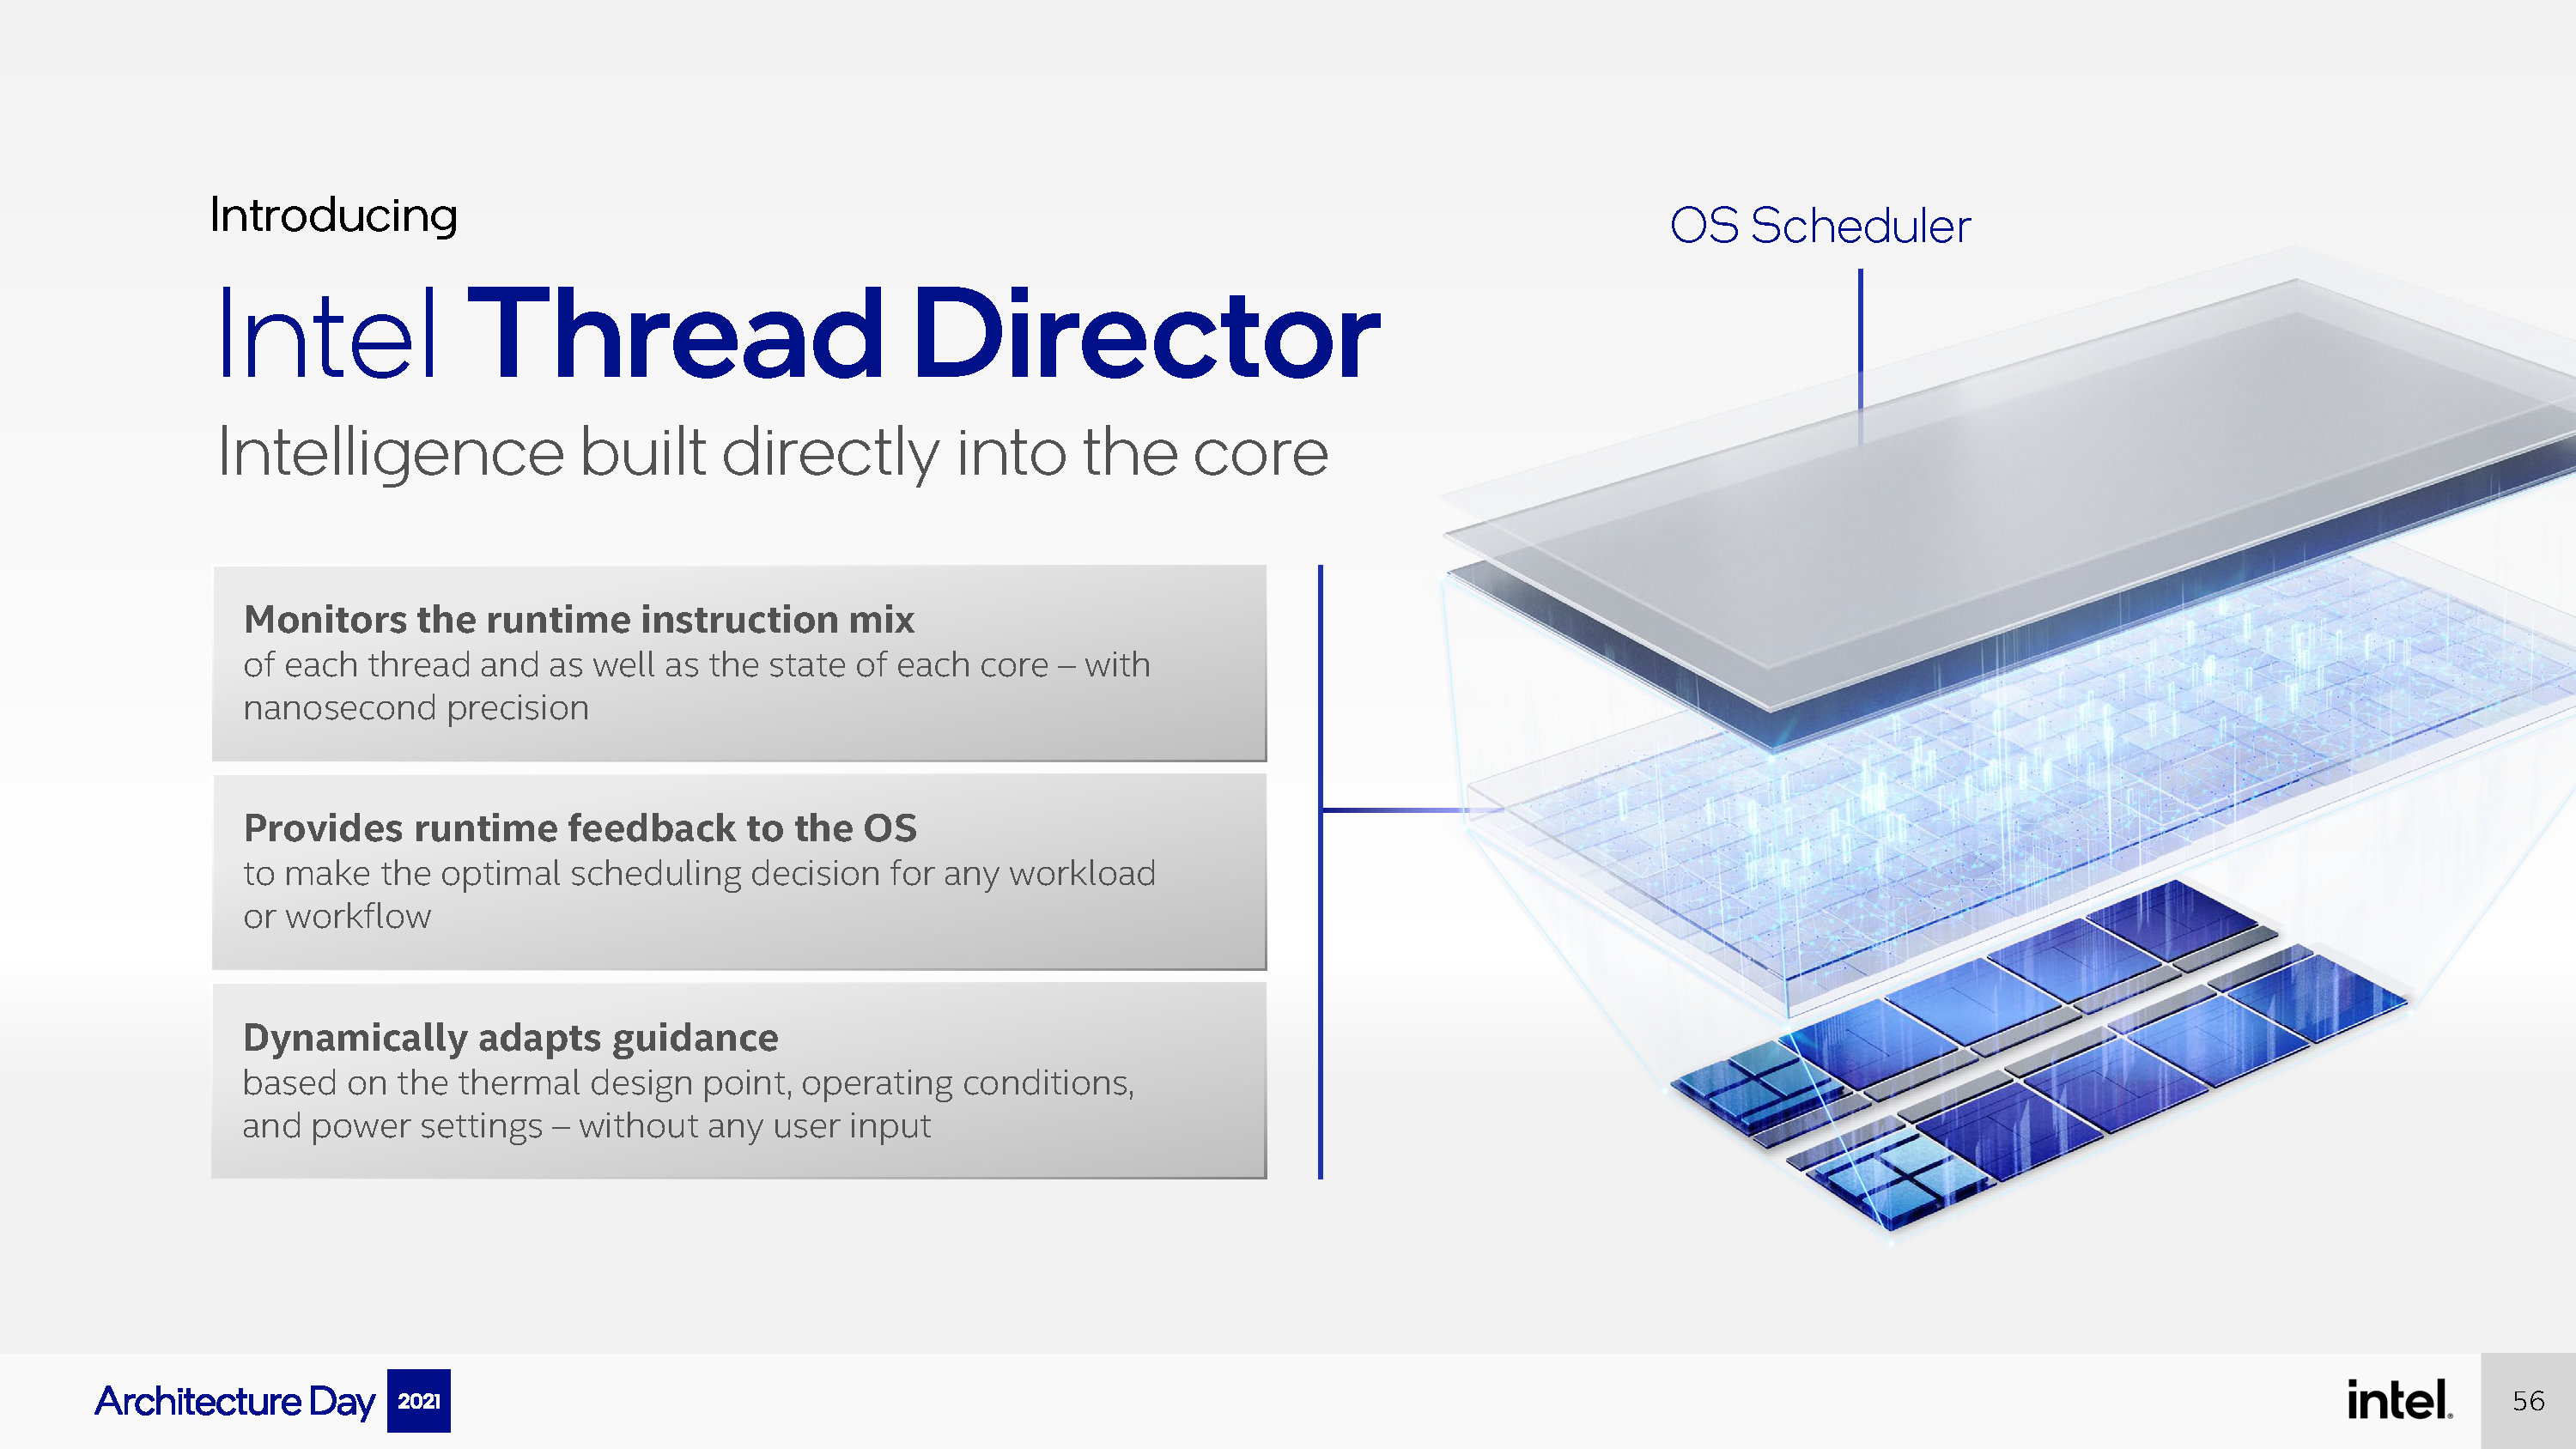
在操作系统层面上,Intel和微软合作改进了Windows的任务调度,从Windows 11开始,系统的任务调度器能够获取更多信息,用于判断当前正在运行的线程需要什么样的性能模式,它要调用哪些指令集,同时它还懂得让硬件为高优先级任务让位。

同时,Intel在Alder Lake处理器中集成了一个非常小的MCU,用来监控当前处理器内核的运行情况,能够监测到每个线程的特征,比如它运行什么样的指令集、它的性能需求如何等等。在收集完信息之后,它会将收集到的信息反馈给Windows 11,而后者将会把这些信息与自己收集到的信息相结合,判断是否应该将线程转移到别的核心上。这一切发生在短短30微秒以内,而传统的调度器可能需要100多毫秒才能判断出结论。

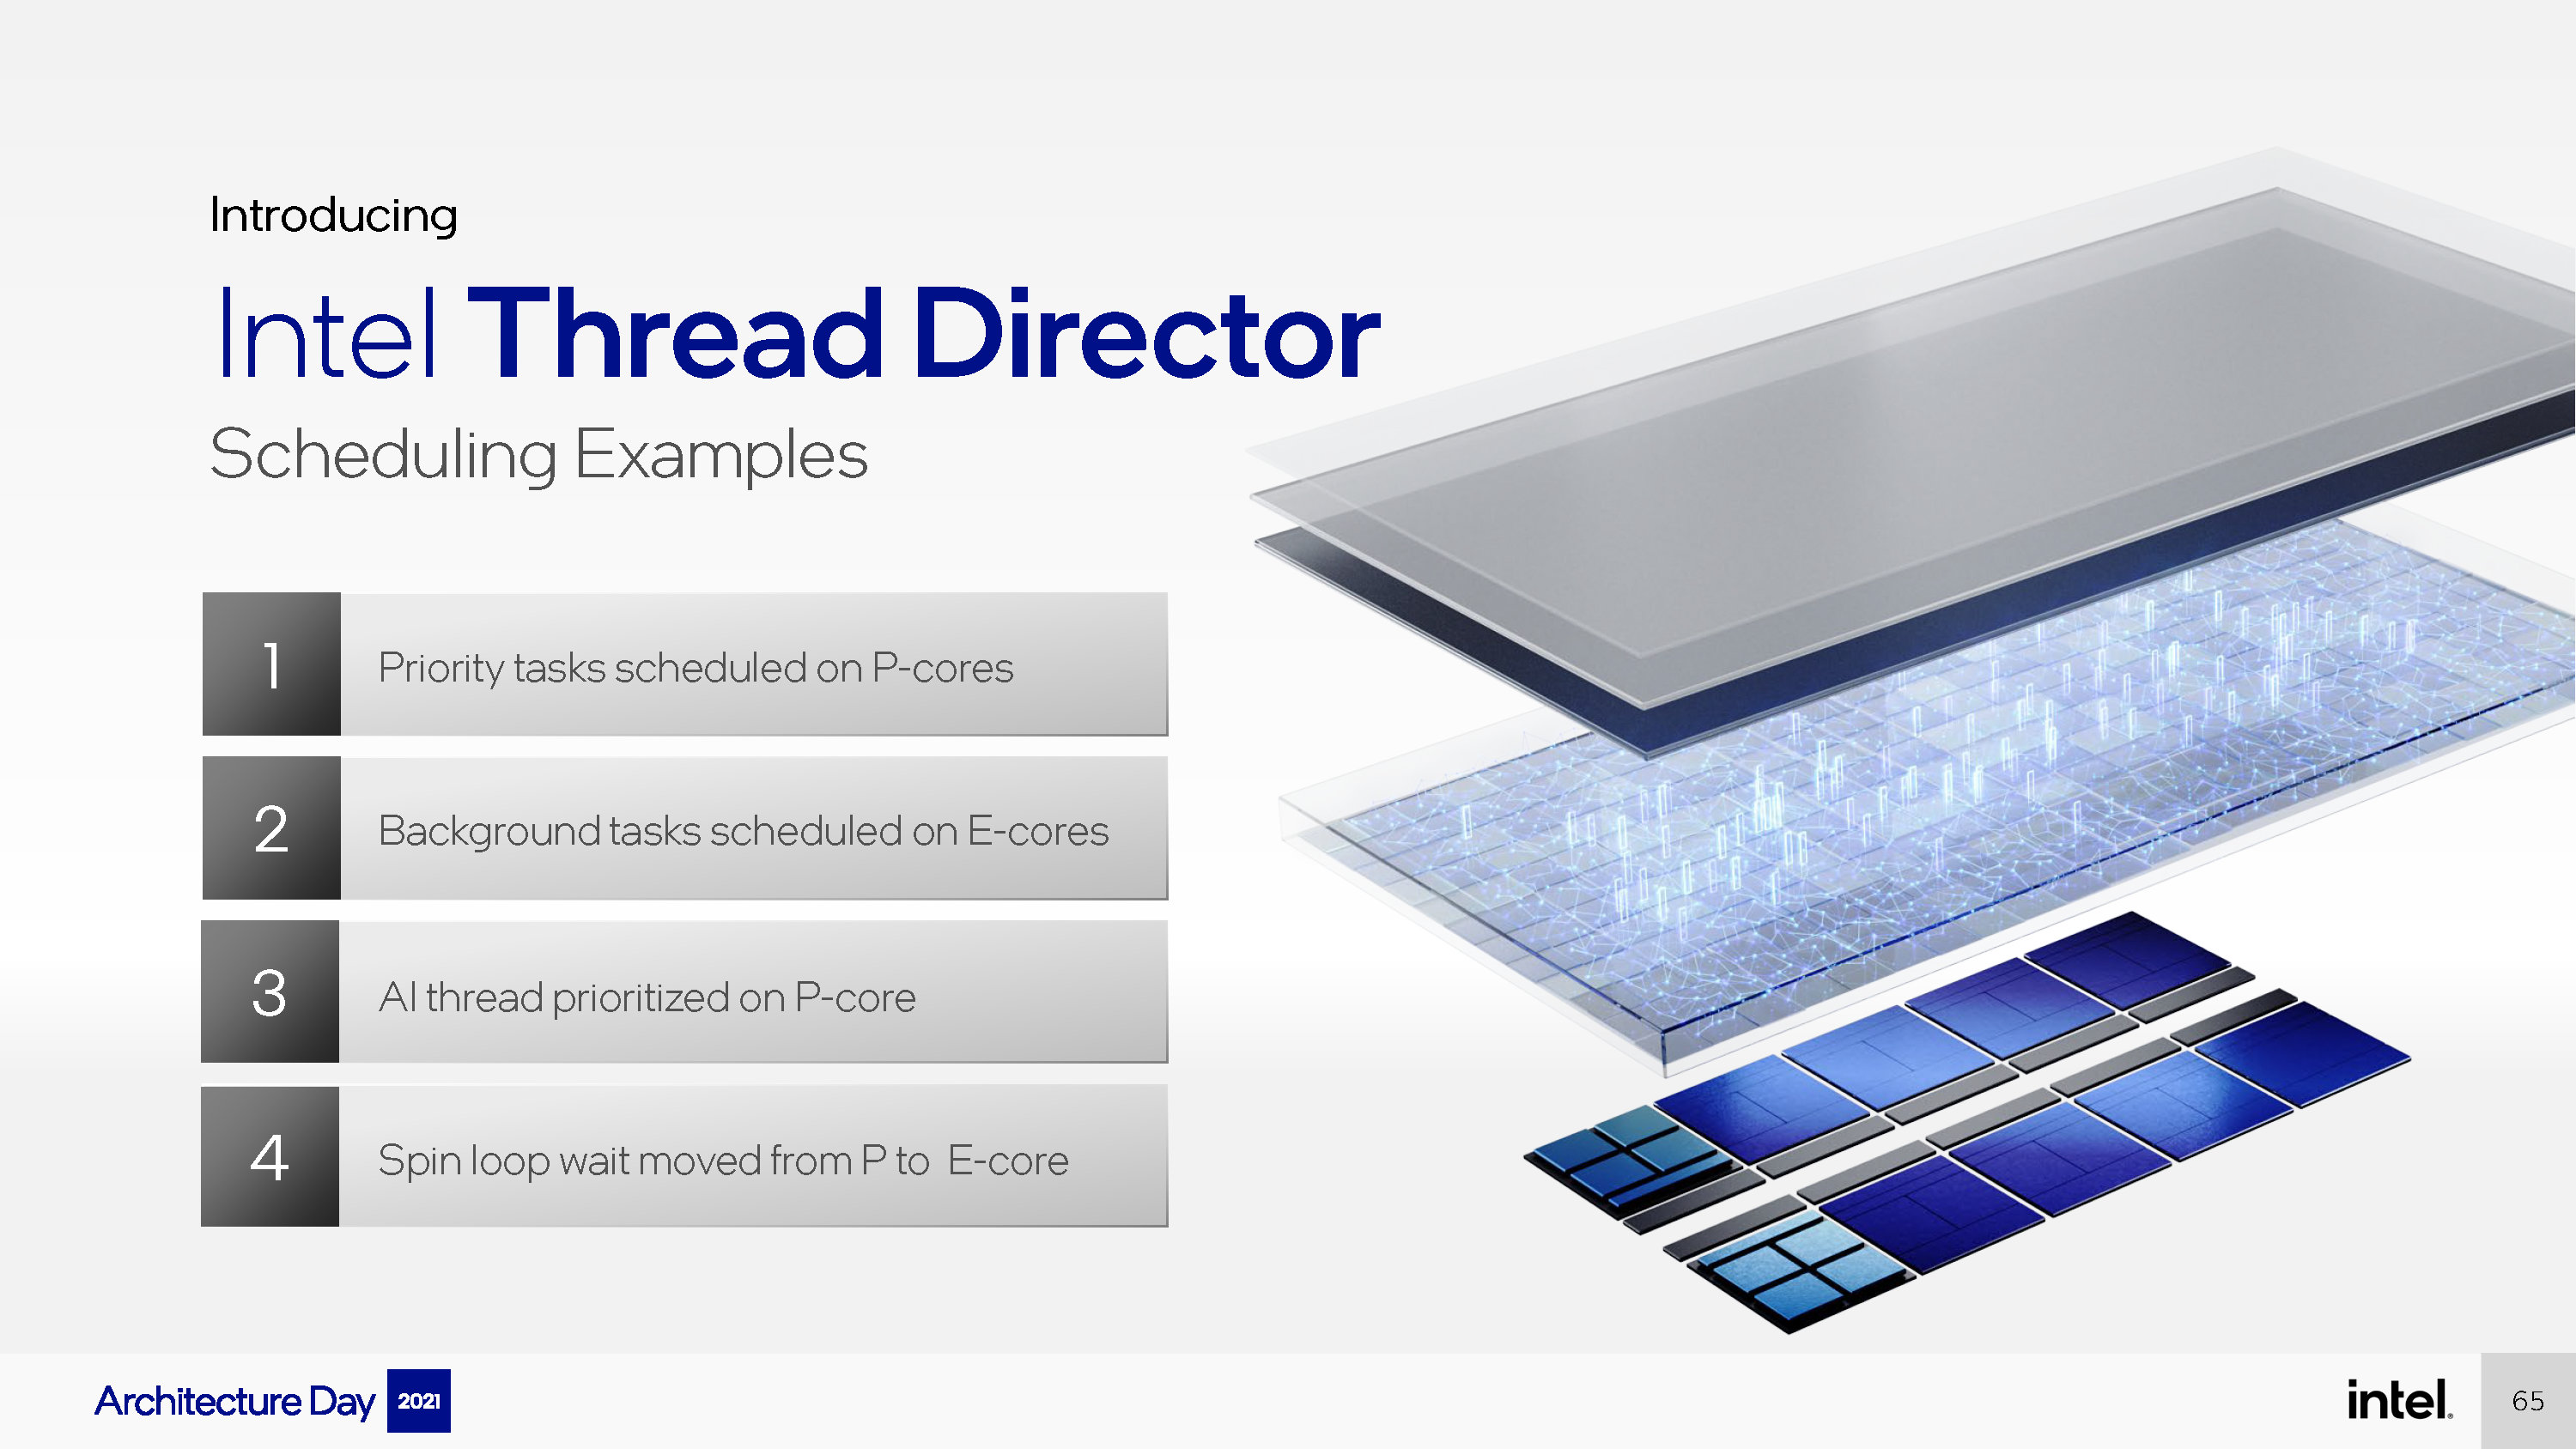
当然,Alder Lake默认还是会把线程安排在P-Core上,除非高性能核心上面都有任务在跑。Intel将Alder Lake分为以下三个性能层级:

  1. 每个P-Core上只跑1个线程
  2. E-Core上只跑1个线程(当然它也只能跑1个)
  3. 在P-Core的超线程上跑线程、

也就是说,在一般情况下,系统调度器会优先把线程安排到P-Core原生的线程上,8个原生P-Core线程被放完后,轮到的是E-Core,如果还不够用,它才会去利用P-Core超线程出来的线程(因为超线程出来的线程性能肯定是不如E-Core的好嘛)。比如一个20线程的任务,会利用上P-Core原生的8个线程+E-Core原生的8个线程外加4个P-Core超线程出来的4个线程。

当然,Windows 10也还是有大小核调度的能力的,但是说简单点就是不够智能。在Windows 11下Alder Lake应该会有更好的能效表现。

支持DDR5与LPDDR5内存,仍然兼容DDR4和LPDDR4

讲完内核部分,我们略过没有实质性变化的Xe GPU,直接来看其他的一些变化点,首先是内存控制器:

可以看到Alder Lake新增了对DDR5和LPDDR5内存的支持。默认情况下DDR5支持到4800MT/s,LPDDR5支持到5200MT/s,前者在今年晚些时候会开始出货,而后者在移动设备上已经被广泛应用,本来Tiger Lake是号称支持LPDDR5的,后来因为种种原因没能最终实现。而在Alder Lake正式推出之后,应该会有很多轻薄本用上LPDDR5内存。

支持PCIe 5.0的新IO

Alder Lake的PCIe支持非常激进,直接一步升级到最新的PCIe 5.0,带宽较PCIe 4再翻一番,x16下数据带宽高达64GB/s。当然因为功耗原因,这应该是桌面平台独有的。在Rocket Lake-S和Tiger Lake上新增的x4通道则仍然是PCIe 4.0规格的,可以用于连接SSD。虽然没有明说,但与PCH互联的总线应该是升级到DMI 4.0了,至少会是x4的宽度,而高端PCH应该会通过DMI 4.0 x8与CPU相连。PCH能够再导出12条PCIe 4.0和16条PCIe 3.0,扩展性比起以前来可谓是一个天上一个地下。

大一统的Alder Lake

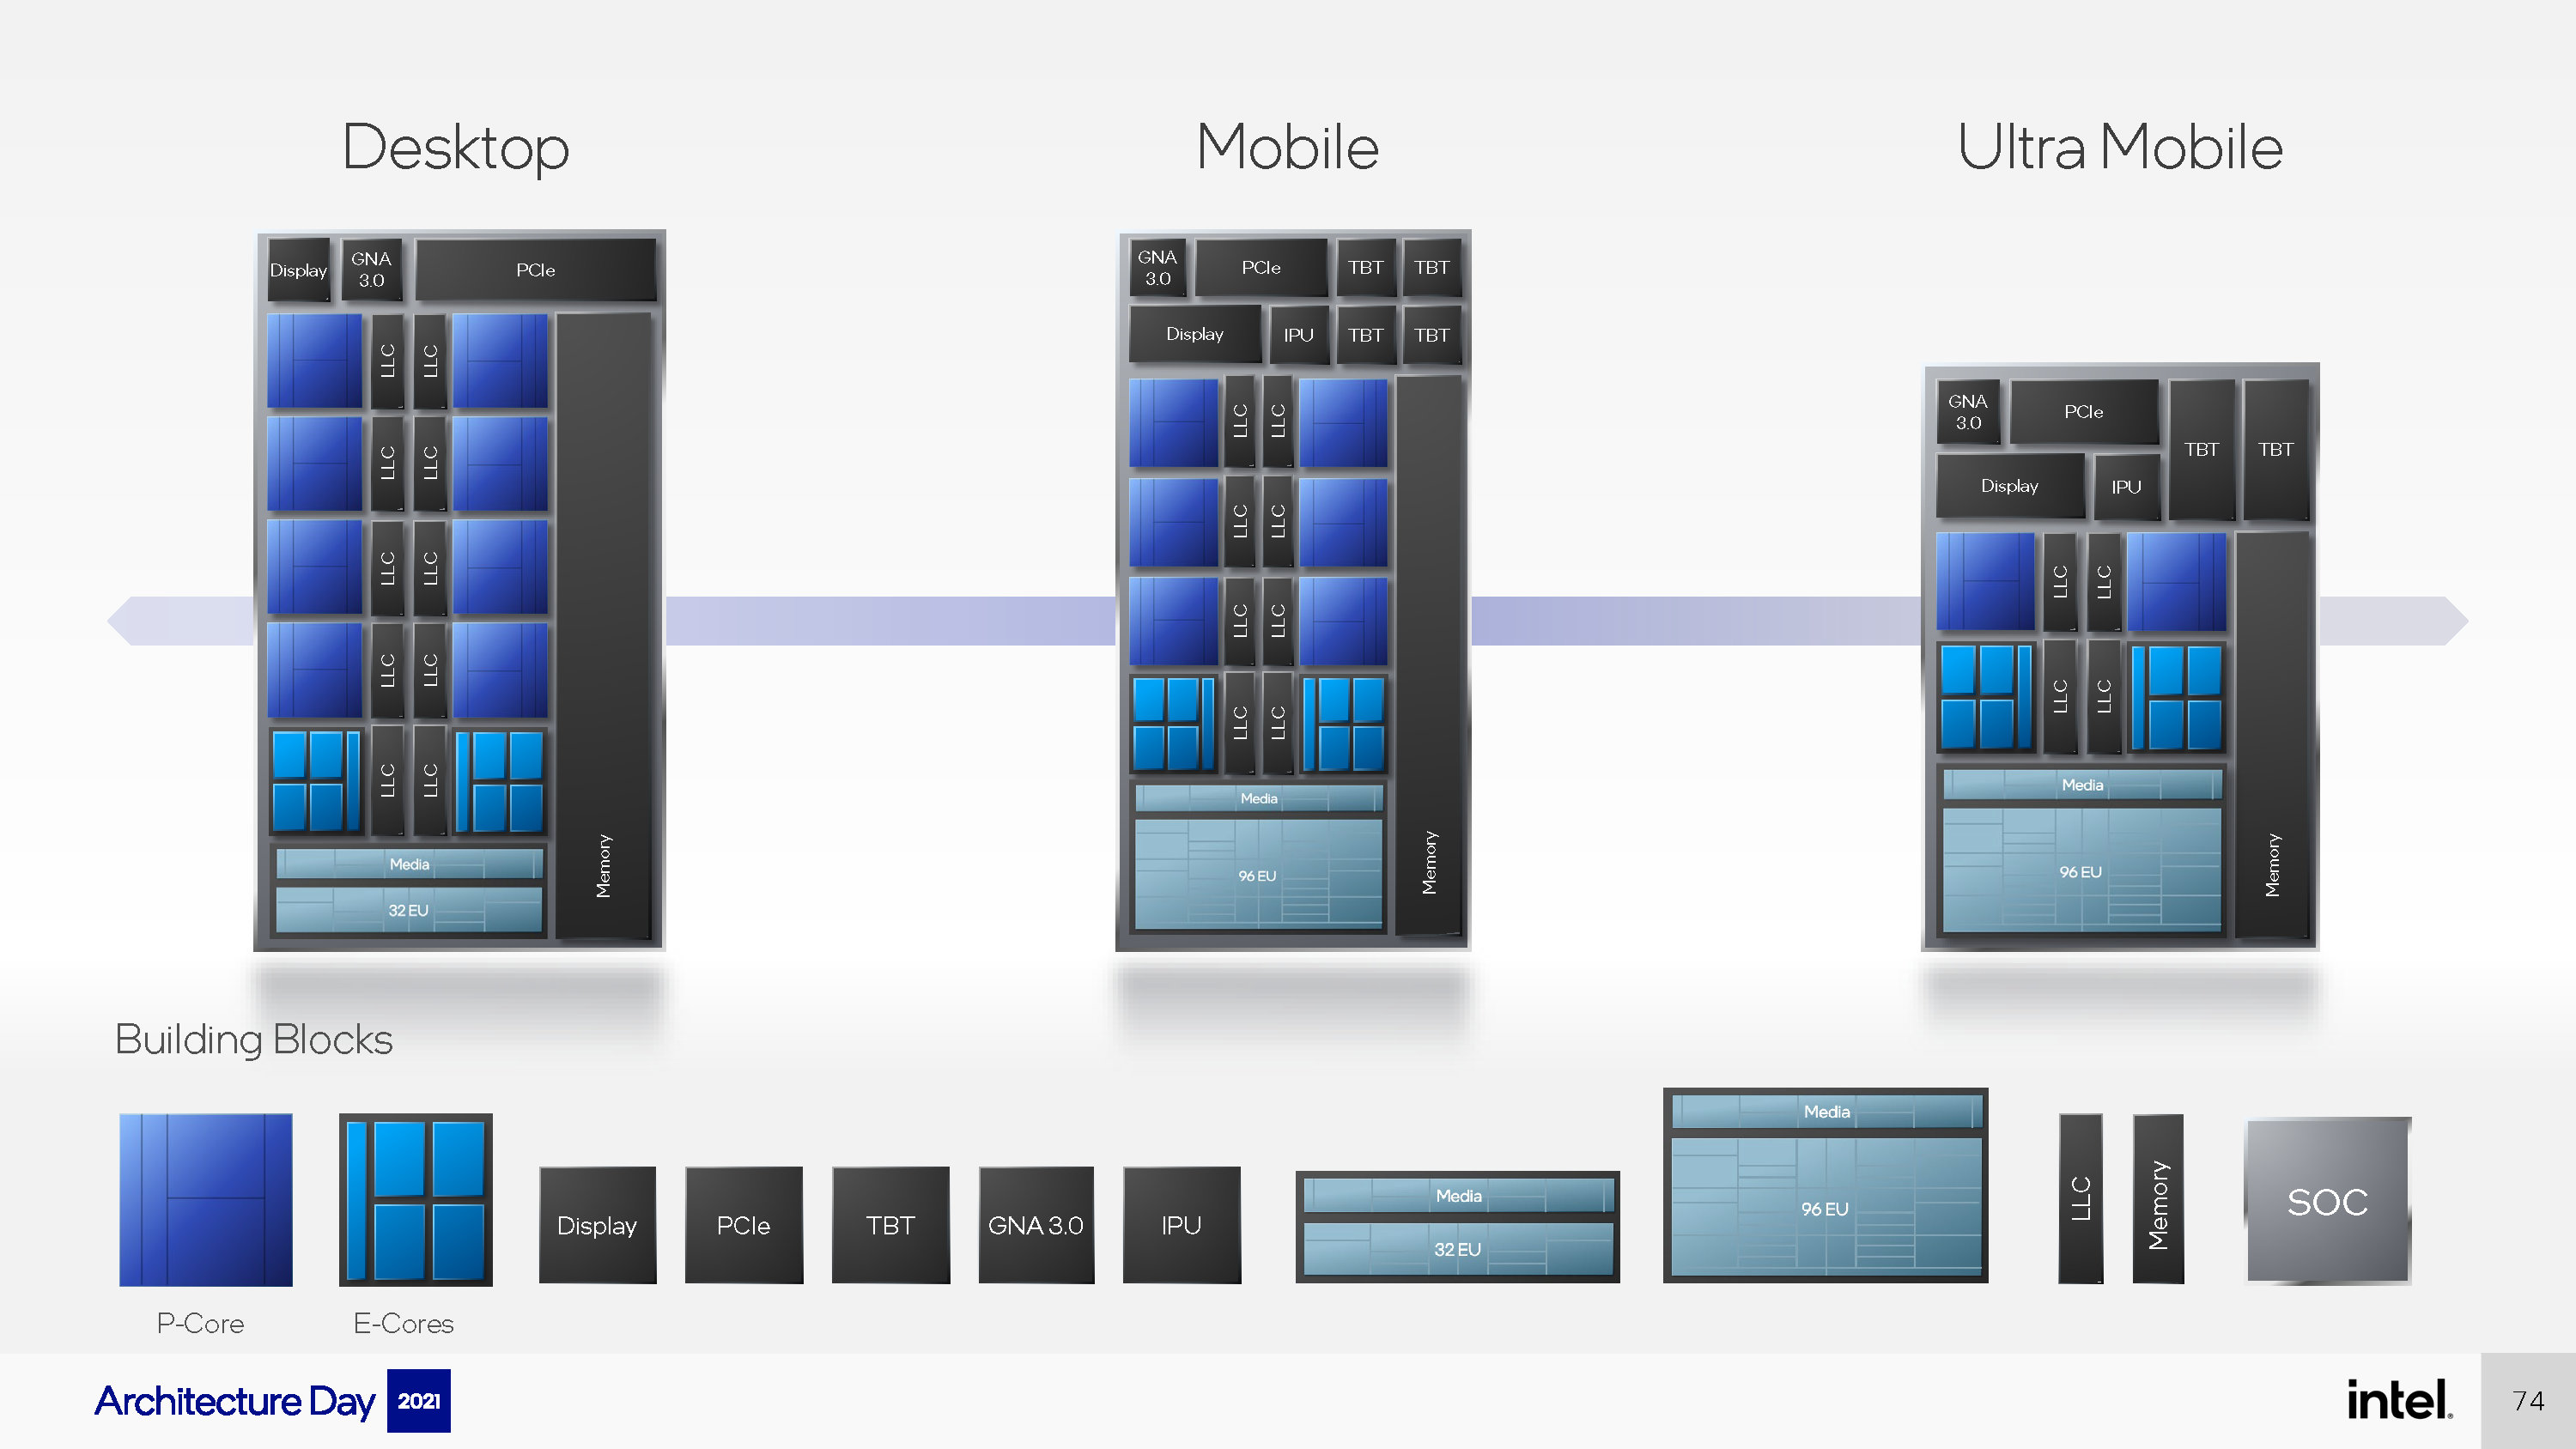
相比起11代酷睿在桌面和移动端的分裂,Alder Lake又重新统一了回来,当然不同平台还是会有不同的规格。

桌面端的Alder Lake最高会有8大核8小核,不过没有集成的Thunderbolt 4控制器,核显规格也仍然只有32EU。移动端最高则是会有6大核8小核,外加96EU和4个Thunderbolt控制器,当然还是会集成祖传的IPU。对功耗更为敏感的超轻薄端最高就只有2大核8小核了,Thunderbolt控制器数量也减少到2个。

Alder Lake是近些年来Intel推出的改变最大的一个架构,不管是计算内核本身的改动还是大小核的设计,可以说是非常激进的。很惊喜Intel能给我们带来这样一个很有创造性的新架构,Intel可能会在10月末的innovatiON活动上正式发布Alder Lake的产品,也就是第12代酷睿处理器,非常期待它的正式表现。

Intel是怎么失去自己的性能优势地位的?

要是有人在五年前跟我说,AMD的处理器性能逼近甚至超过Intel的,那我当时肯定会像看傻子一样看着对方,然后缓缓说出一句“你在搞笑吧?”来严肃回答对方。

然而,两年之后的现实就是,AMD用Zen 2架构的Ryzen 3000系列处理器在性能与口碑上都追上,甚至赶超了Intel,“AMD, Yes!”这句口号也是被喊得越来越响亮,甚至出现了什么状况呢?面对竞争对手的咄咄逼人,他们拿出了Comet Lake-S这种实质是Refresh的产品来应对,连已经被应用在移动端的新内核微架构都懒得换,加了两个核心,优化了下散热,提了点频率就拿出来卖了。

那么Intel是怎么一步一步走到今天这个局面的?我分析了从14年开始,Intel的产品布局还有他们的Roadmap,至少有一点可以明确的是,制程工艺,真的卡了Intel的脖子。从22nm到10nm的路上,每一次制程节点的升级都遇到了问题,结果就是Intel匆匆忙忙之间,不仅要为新制程的延期擦屁股,还要为竞争对手的突击来调整自己的产品布局。首先,我们要从14nm,这个可以说是一代经典的工艺说起,让我们把时间倒回到2014年。

14nm延期:Tick-Tock战略的终结

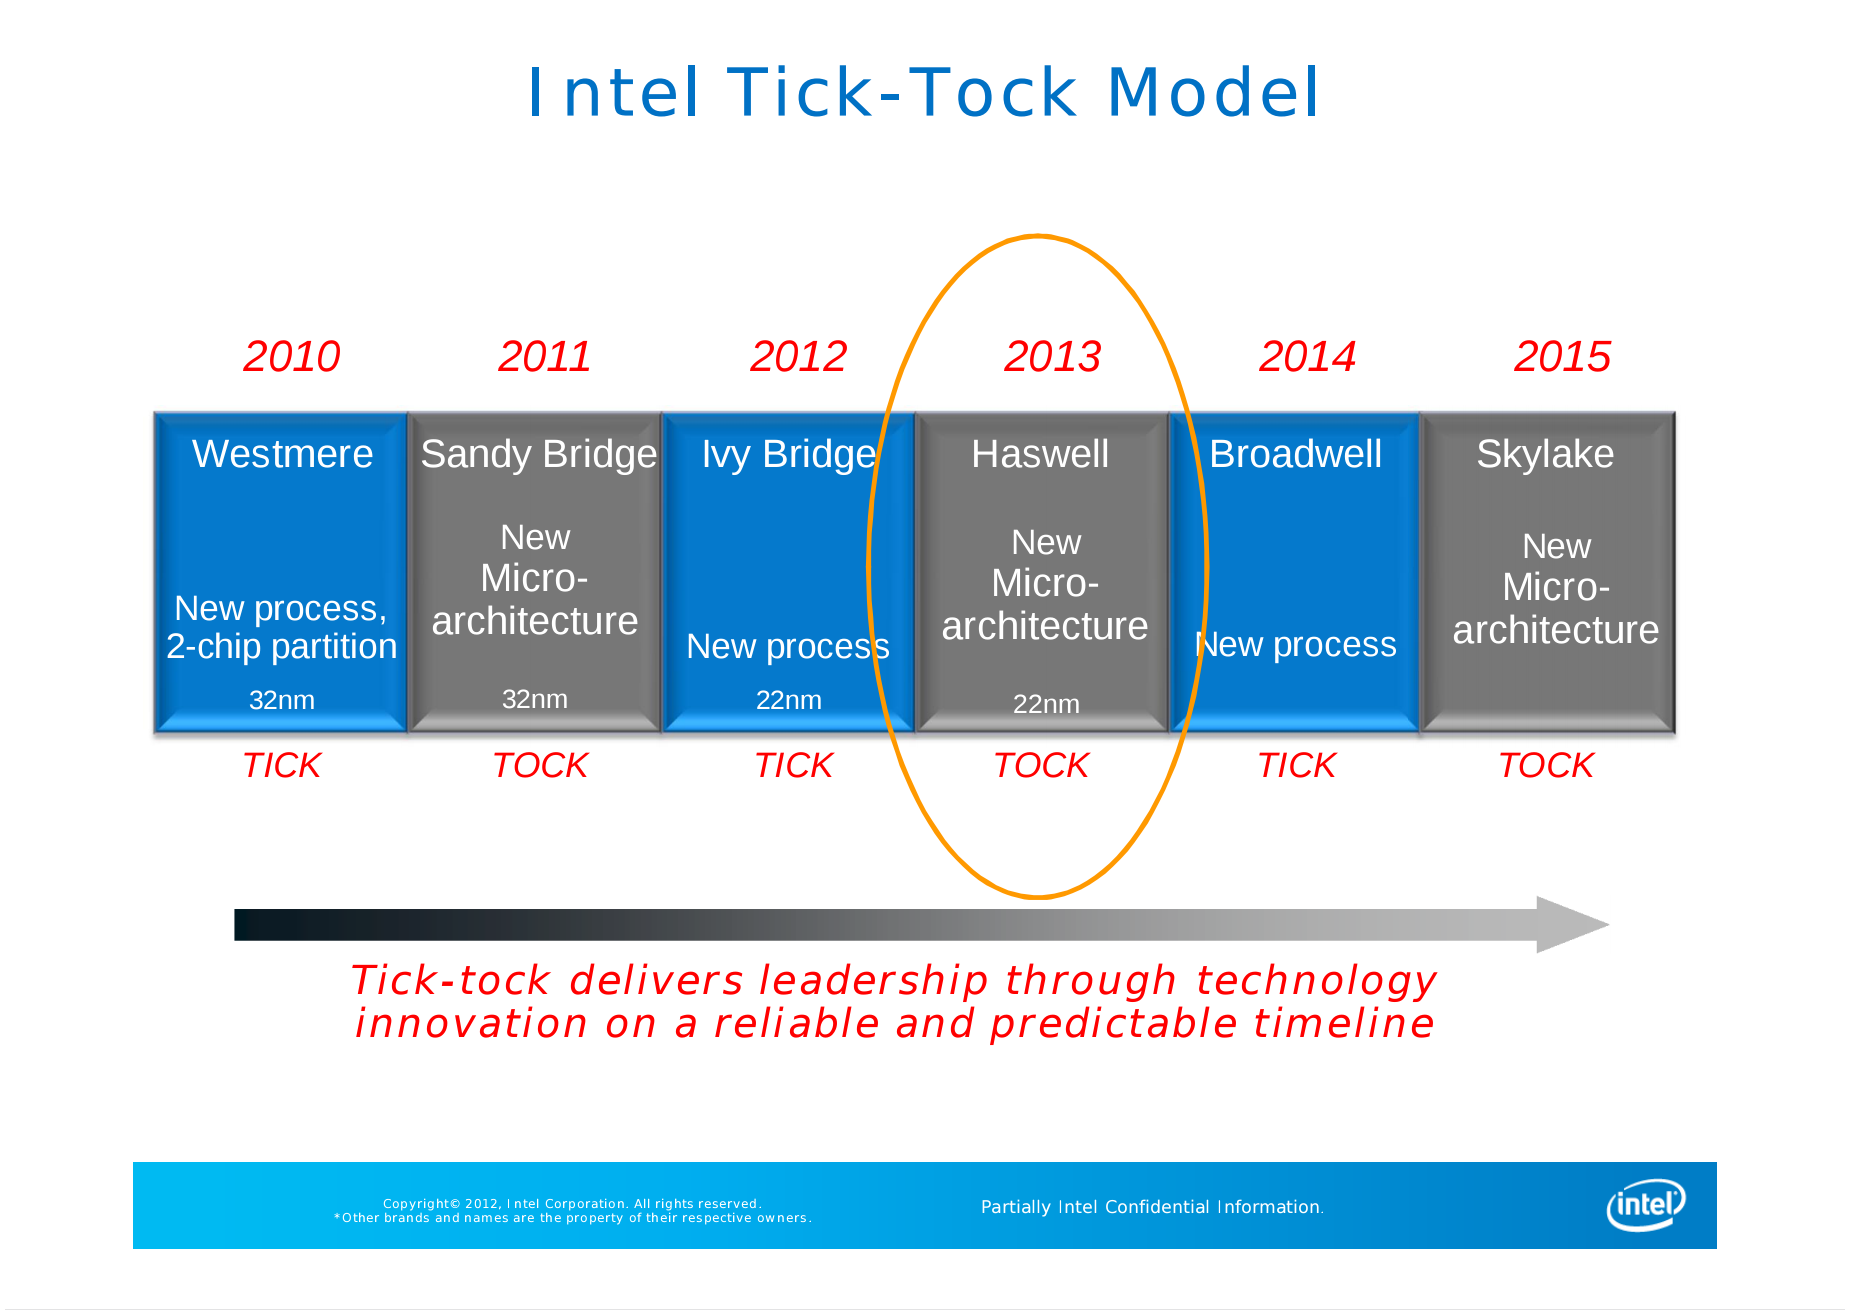
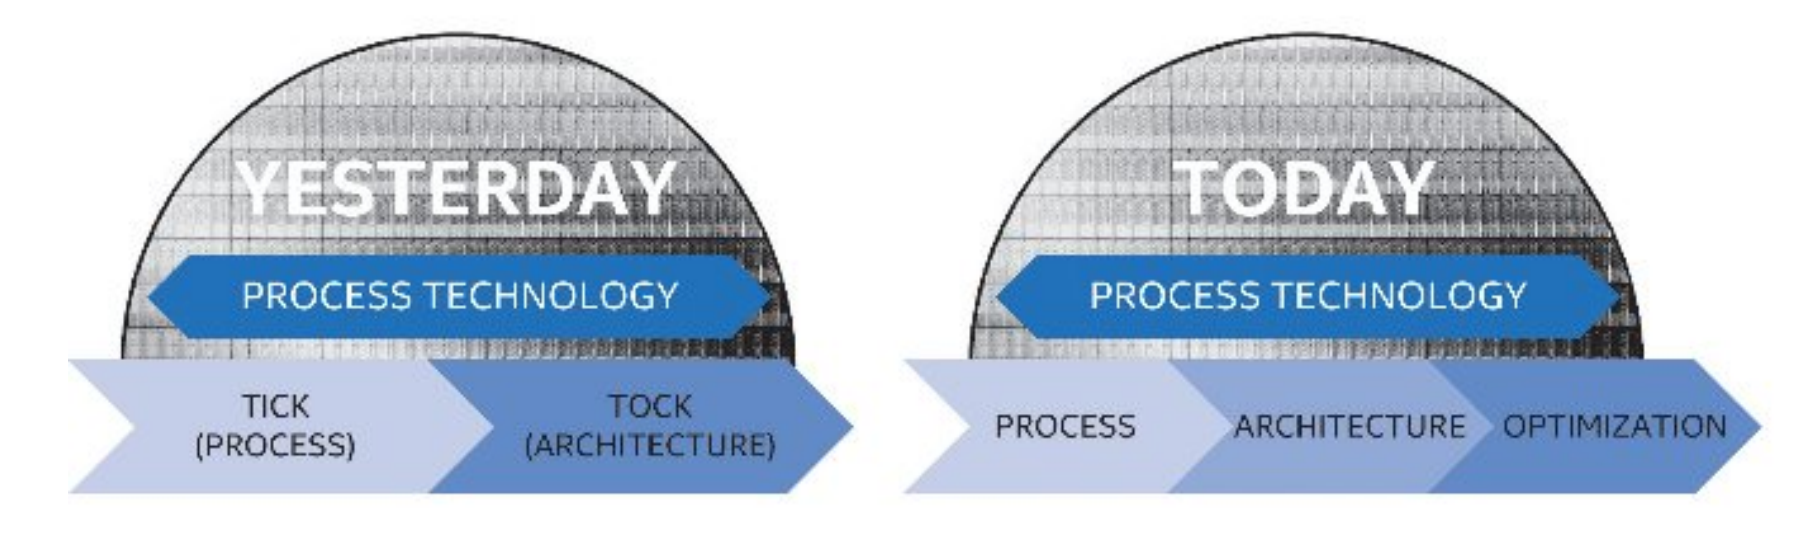
2014年的Intel,正在用着成功的Haswell和22nm制程称霸着x86处理器市场,他们原本计划在那年推出升级14nm制程的Broadwell,也就是Haswell的换制程版本,延续自己成功的Tick-Tock战略。

什么是Tick-Tock战略呢?这里为不清楚的朋友简单介绍一下。

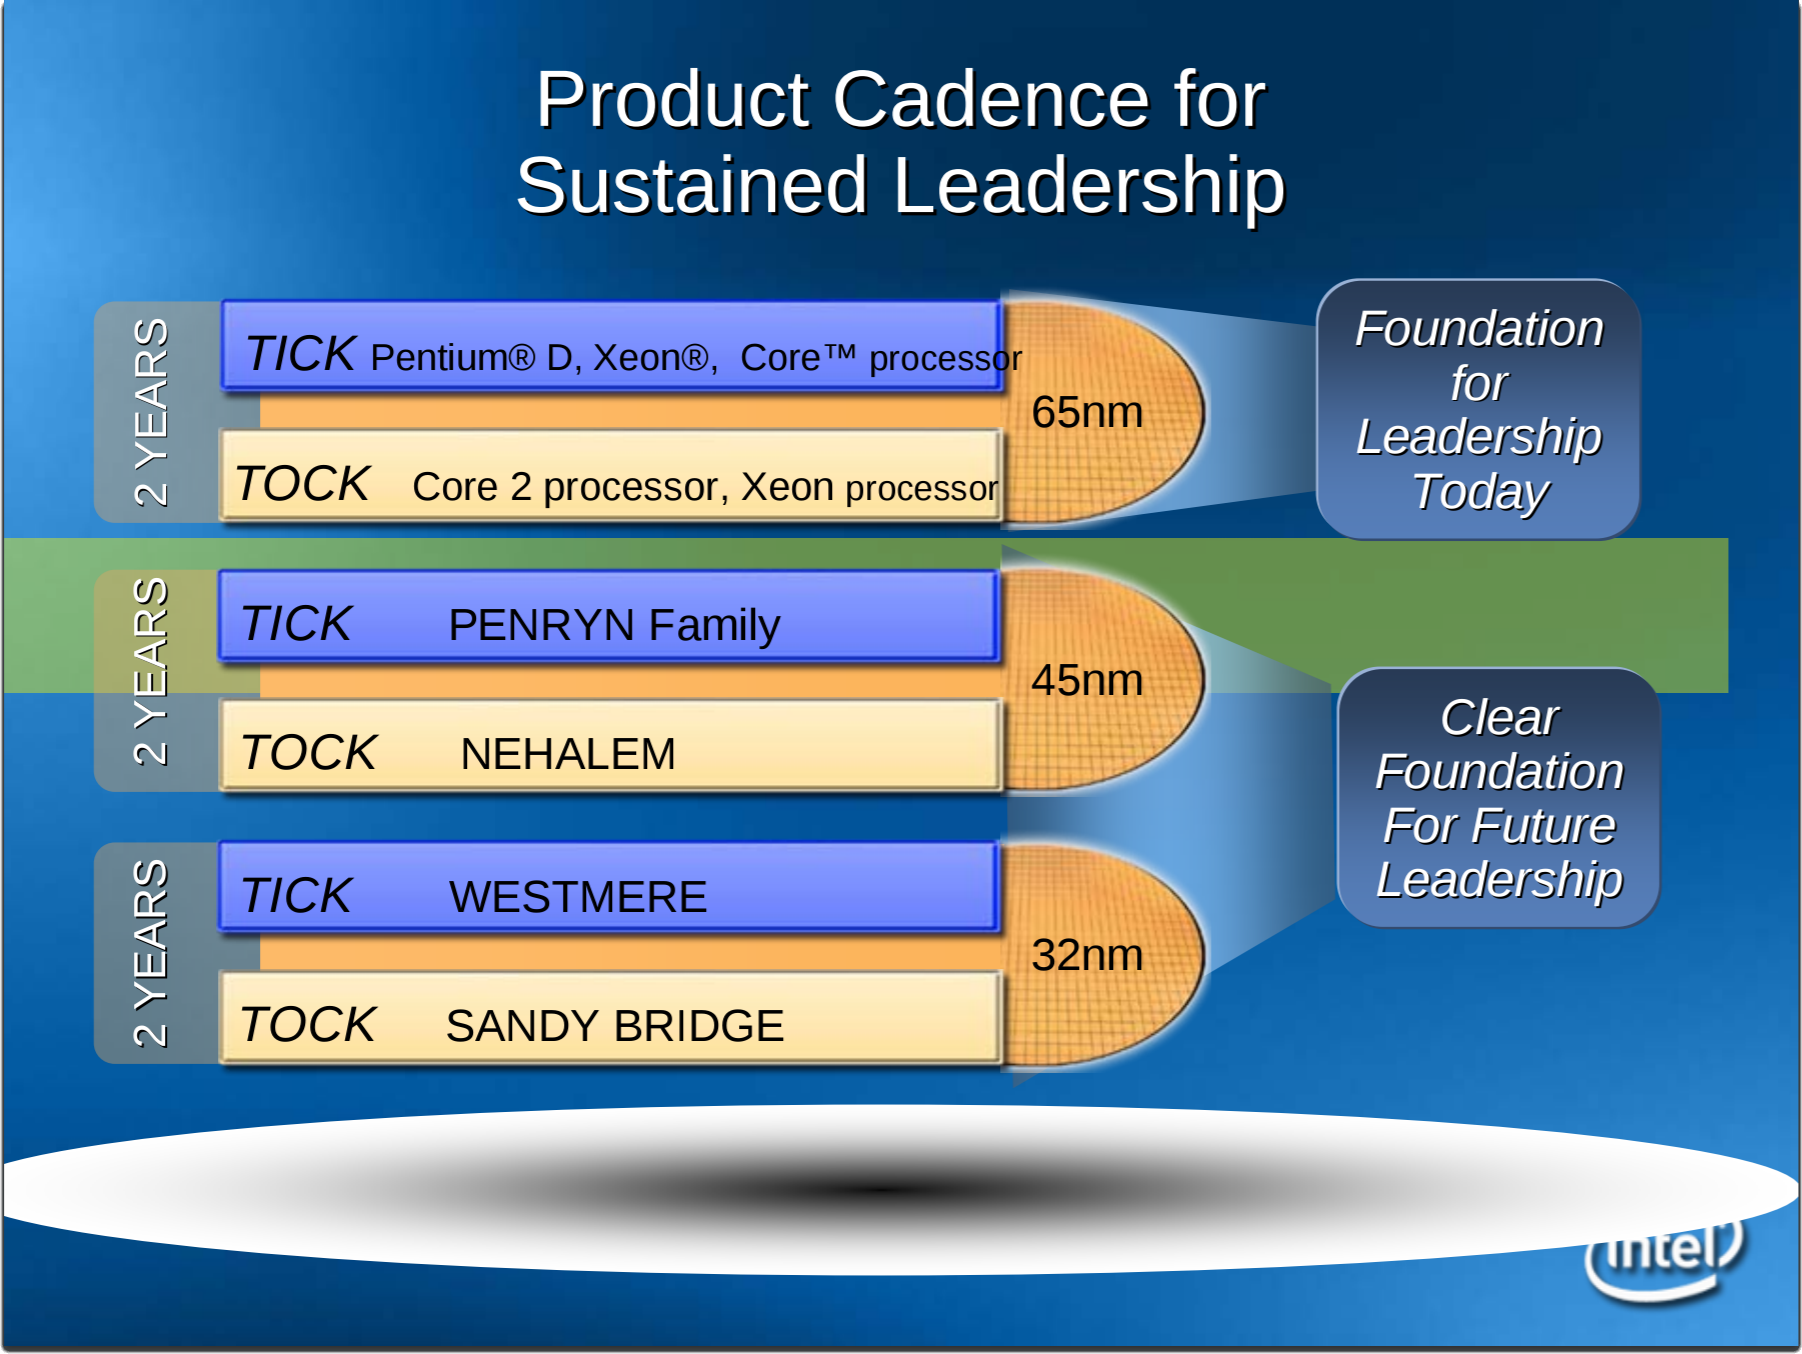
Tick-Tock战略是Intel在2007年提出的处理器更新战略,因其类似于钟摆运动而得名。在Tick年,Intel将会引入新的制程工艺,但不会对CPU微架构进行大幅改动;而在Tock年,Intel将会使用上年更新过后的工艺推出采用全新架构的CPU。这样,以两年为一个周期,Intel可以稳步推进自己的处理器更新换代,在市场上牢牢坐稳自己领导者的位置。

这套战略非常有效,Intel沿着Tick-Tock战略制定的轨迹,从2007年一路走到2013年,期间他们的制程工艺从65nm一路发展到22nm,而内核微架构也从Core 2 Duo时代的Conroe一路进化到2013年的Haswell。

Haswell,也就是现在仍然被人们津津乐道的四代酷睿,一经推出就成为了当时的装机首选。一方面,它相对于上代处理器有可观的性能增幅,另一方面,竞争对手还陷在推土机架构的泥沼中,一时半会儿没有还手的力气。看起来Tick-Tock战略非常成功,下一年就可以推出采用14nm制程的Broadwell系列处理器了,但就在这个当口,制程工艺的更新出了岔子,跟不上了。

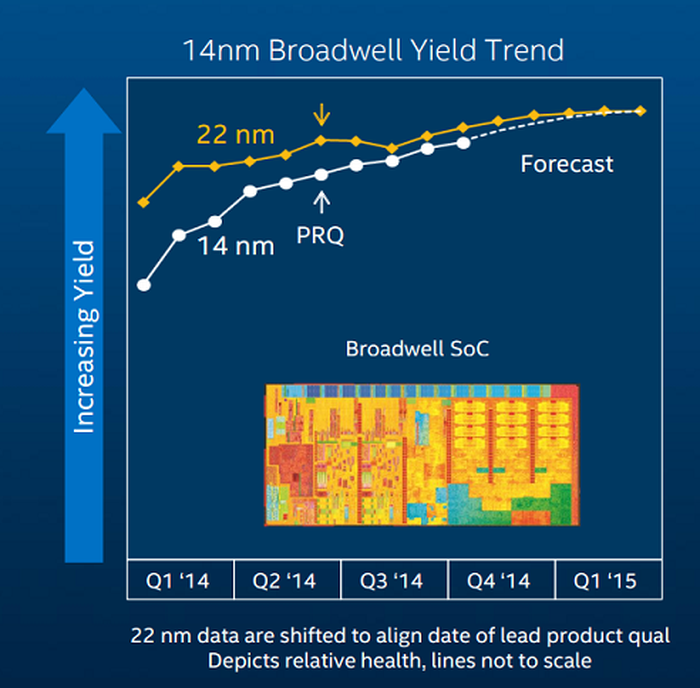
Intel为每一次的制程迭代都设定了相当高的目标,从22nm进化到14nm也不例外。但Intel再牛逼,也突破不了物理的极限,随着晶体管变得越来越小,单位面积内晶体管的数量越来越多,在没有对材料进行改进的前提下,漏电和发热情况会越来越明显,同时,新工艺早期的良率难以与老的成熟工艺相比,搞定这些问题需要时间。在2013年末的时候,14nm制程还没有成熟到能上正式产品的底部,在当时Intel期望能够在下一年的第一季度将其应用于量产,结果我们都知道了,预期没能实现。

在2014年年中的时候,Intel对外解释了他们14nm制程延期的一些原因,上图主要诉说的是14nm制程的良率还没有22nm那么高,才刚刚满足Intel的PRQ(能够用于正式生产的良率点)。那工艺才刚刚进入量产,产能还跟不上怎么办?Intel很聪明,他们选择对现有产品在不进行制程升级的情况下进行小幅更新,也就有了Haswell Refresh这一代处理器,代表产品有Core i7-4790K和Xeon E3-1231V3等。从这里开始,Tick-Tock战略在事实上已经被改良的Tick-Tock-Refresh战略所取代,不过Intel暂时还没有承认这一点,继续使用既有的路线图走了下去。

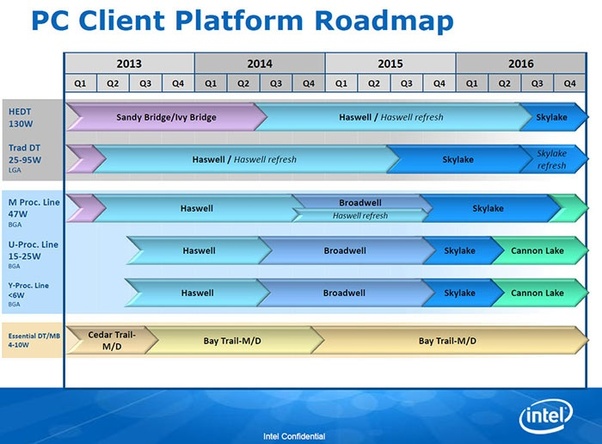
在既有的路线图上面,2014年是Tick年,Intel应该换新的工艺,也就是预定的14nm推出新产品。但因为工艺出现了延期,没能很好地实现Tick年的预定计划,而新的Tock年——2015年很快就到了,按照计划他们应该推出采用新架构的14nm处理器。为了赶上原本的路线图,Intel直接砍掉了Broadwell的桌面版(实际只有两款且出货很少),在2015年的夏季,直接推出了Skylake处理器,也就是我们熟知的第六代酷睿。

上图是Intel在2015年公布的官方路线图,可以看到的是,在桌面端,Broadwell完全消失了,接替Skylake的,是又一代的Refresh产品。而在移动端,Broadwell与Haswell Refresh并存,之后出现了一个需要注意的地方,那就是Cannon Lake,它将要在移动市场上接替Skylake,是Intel规划中的初代10nm处理器。按照这张路线图,Intel计划在2016年的第二季度将Cannon Lake带入市场,也就是说,在当时,Intel对2016年量产10nm处理器这件事情是非常自信的。

结果,在2016年,我们没有等来Cannon Lake和10nm制程,等来的却是Intel宣布将Tick-Tock战略由新的Process-Architecture-Optimization(制程-架构-优化,简称PAO)三步走战略替代的消息。

在新的PAO战略中,制程工艺仍然是开启一个周期轮回的首要因素。如果将14nm作为PAO战略的首个制程节点,那么Skylake处理器就是这一轮PAO中的架构改进点,正好是对应起来的,那么在Skylake之后带来的,就应该是Optimization,也就是原本的Refresh这一步,它将优化新架构和新制程的表现,提供一个PAO轮回中最好的综合表现。好了,Intel也就顺势公布了Skylake的下一代将会是Kaby Lake,而不是此前定下的Cannon Lake。

至此,Tick-Tock战略完全失效,被新的PAO战略所取代。但我们谁都没有想到,Intel的头一个PAO轮回就花了他们将近四年的时间。

10nm屡次延期:Cannon Lake夭折与不尽如人意的Ice Lake

上文说到,在Intel很早以前的路线图中,他们计划在2016年将10nm带到人们的眼前,结果事与愿违。不过Intel仍然没有放弃,因为他们深知,制程工艺的领先将会在竞争中给他们带来莫大的优势。于是在2017年伊始的CES展会上,Intel CEO在自家的发布会上面信誓旦旦地表示,他们的10nm处理器会在当年年末的时候出货。紧接着的投资者公开会上,Intel更是扔下了一枚炸弹,他们声称将会在数据中心产品上首先启用10nm制程,而不是像往常那样,首先在移动超低压产品上应用,但同时,他们还告知投资者,今年在消费级还会有一代14nm处理器。

这是为什么呢?我们把时间稍微倒回去一个月。

2016年12月13日,AMD在名为“新地平线”的峰会上面公布了自家传闻已久的全新Zen架构的正式产品——Ryzen系列处理器。在次年的3月初,初代Ryzen的首批三颗处理器正式开卖了,上来就是八核十六线程的规格,在多线程能力方面对Intel处理器造成了很大的威胁,这也被视为AMD走出推土机阴霾,重返高性能处理器市场的标志。

在接到蜇伏了多年的老对手突然出的一记重拳之后,Intel当然是要回应的,于是就有了上面的“今年在消费级还会有一代14nm处理器”,现在我们知道,Intel为了应对AMD的攻势,给桌面端沿用了多年的四核规格加了两个核心,推出了代号为Coffee Lake的八代酷睿,同时他们再次优化了在Kaby Lake上已经被优化过一次的14nm制程,命名为14nm++。

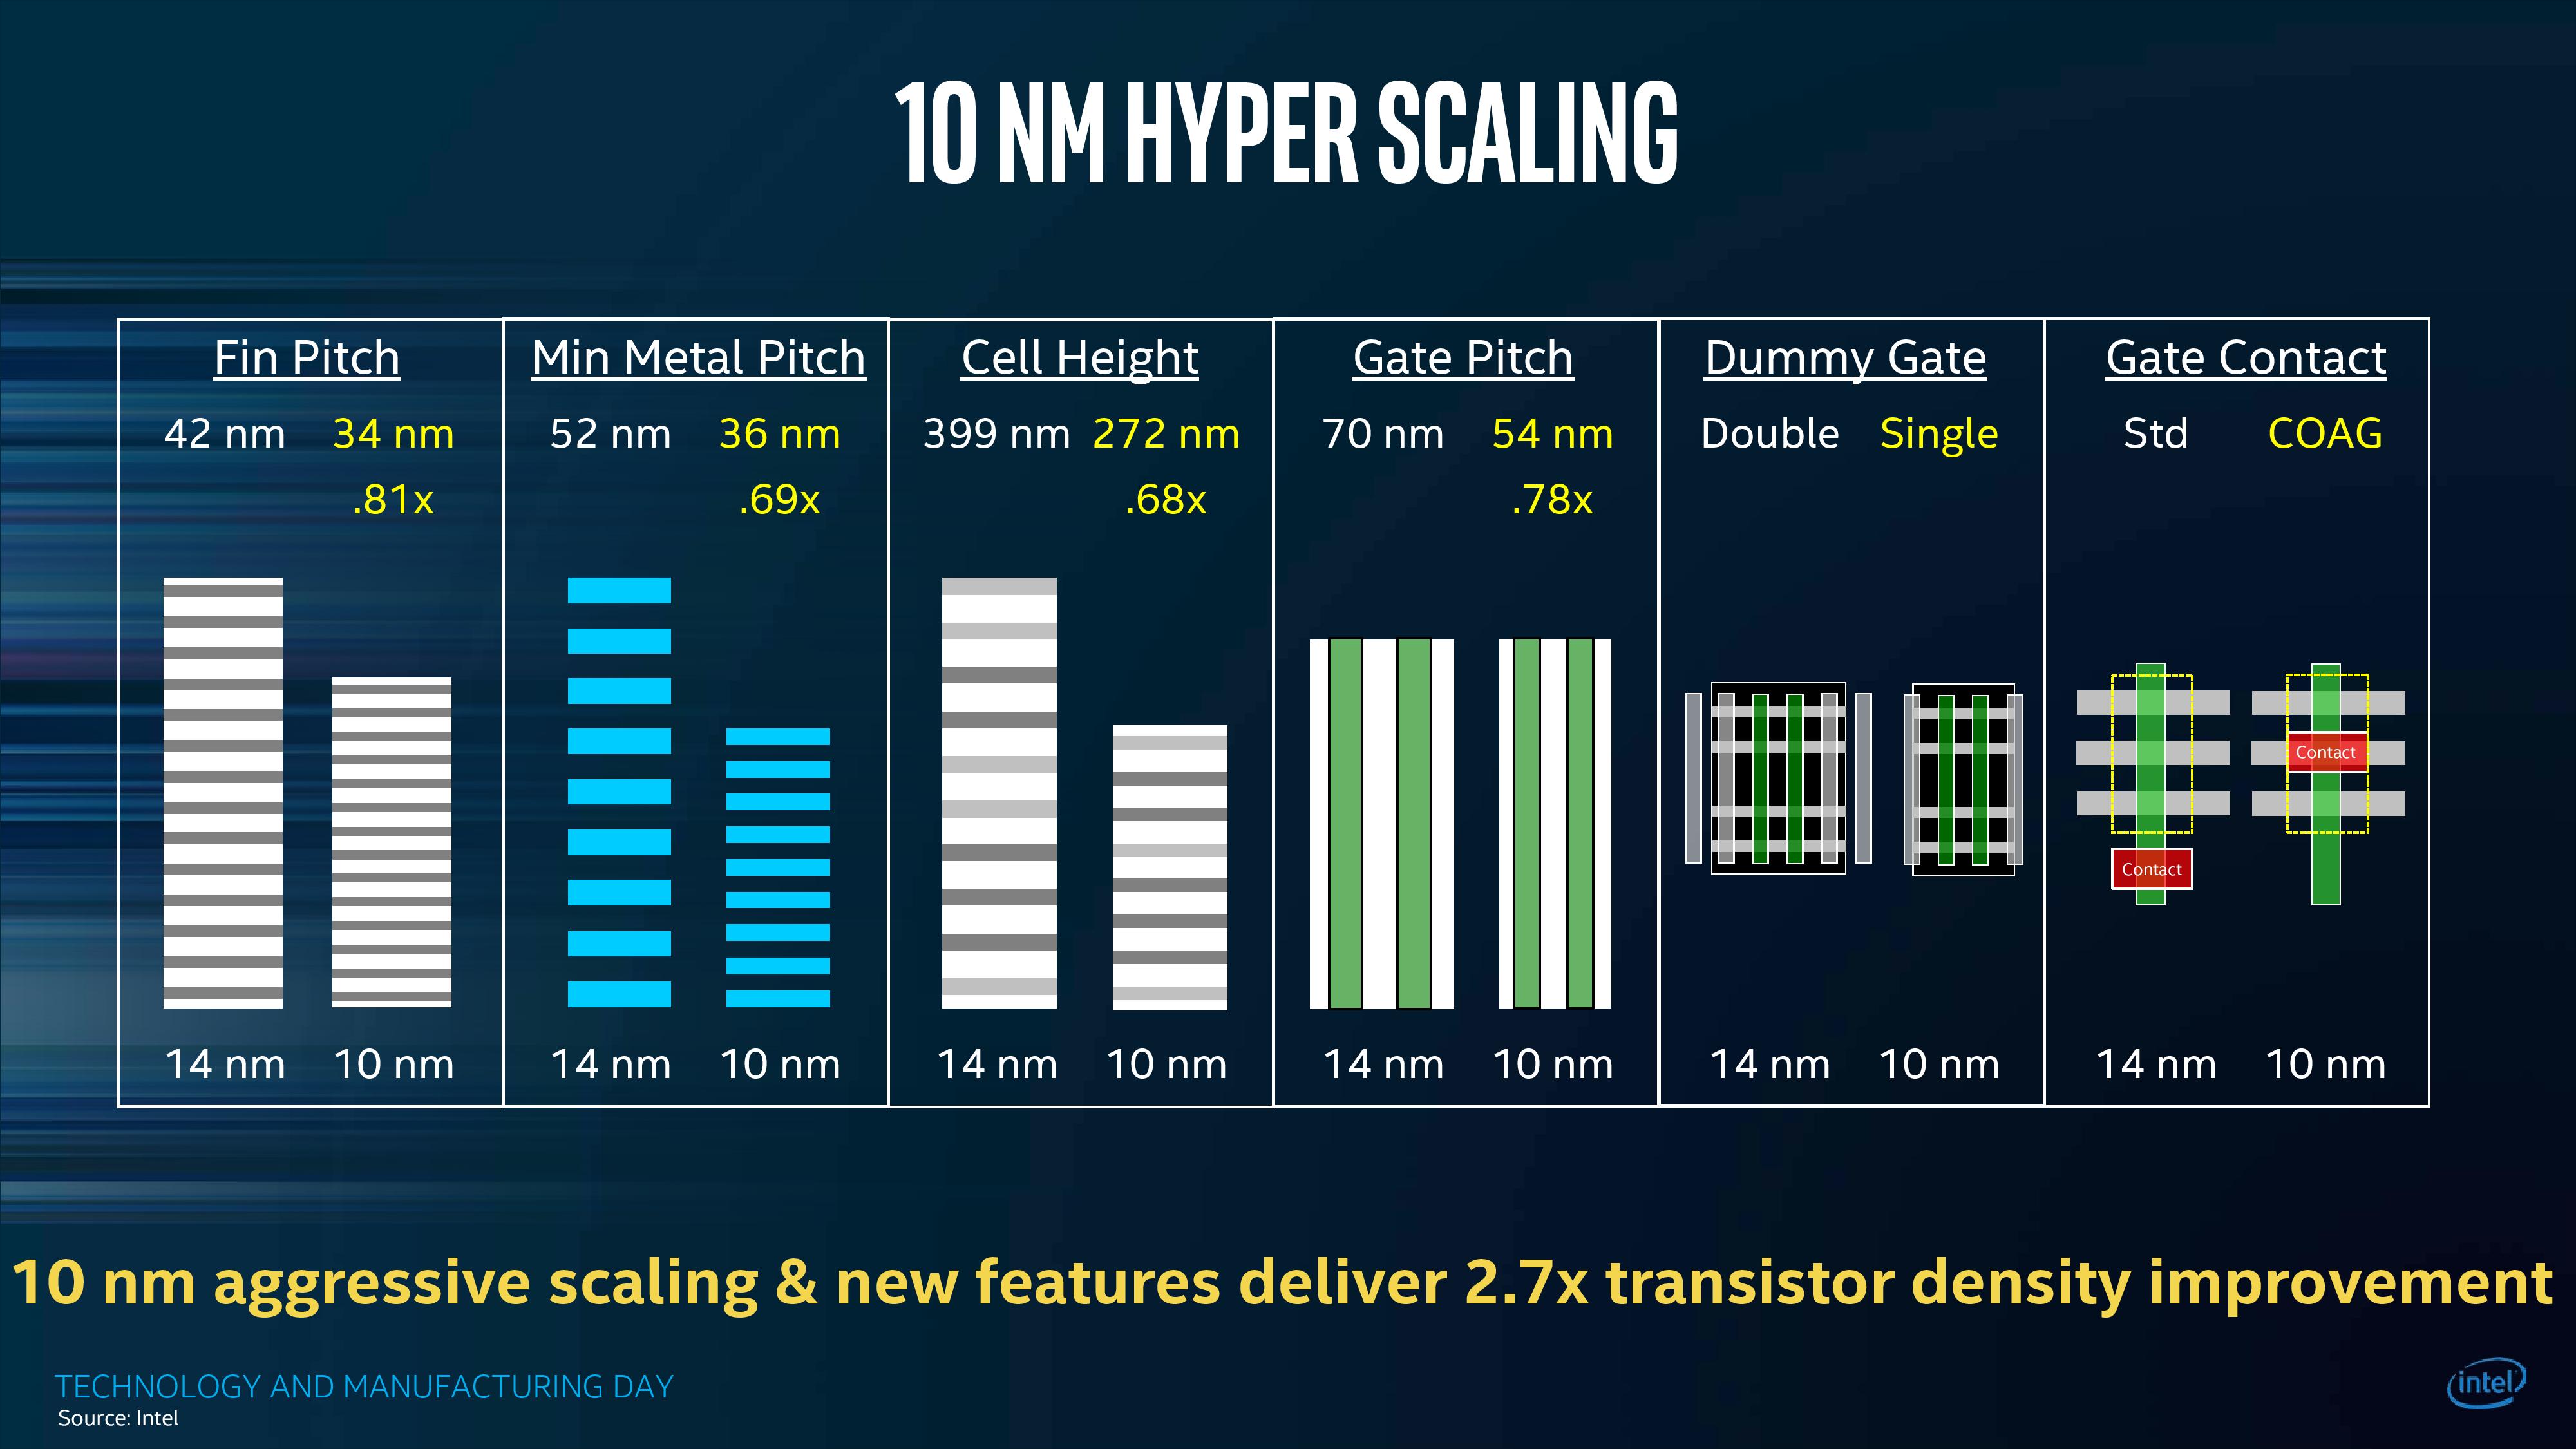
当然,Intel肯定是没忘记他们的10nm制程的,在当年三月份末的制造日(Manufacturing Day)活动上面,他们向各路媒体公开了10nm制程的细节和他们设定的目标,其中最为人印象深刻的是,他们要把晶体管密度提高约2.7倍,这样一来,Intel能够继续保持3.5年的制程领先,并且能够比台积电/三星/GF这几家的7nm工艺更加先进。

吹归吹,还是得拿出实际产品才能够让人信服。

整个2017年,Intel在10nm上再没了什么动静,甚至于在2018年的CES演讲上面,他们的CEO提都没提自家的x86 CPU,只有在演讲结束之后的一个面向媒体的短会上面,CCG(客户计算业务组)的高级副总裁在时长为10分钟的短暂演讲的末尾提了一句,称他们的10nm产品已经在2017年出货了。这种低调的声明对于Intel来说并不是什么常见的事情,在场的不少媒体意识到,Intel内部肯定有什么问题发生了。

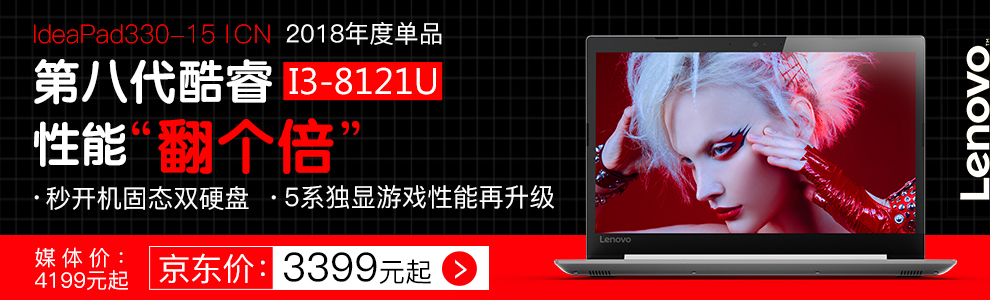
结果到了2018年5月份,除了Intel自己意外泄漏的一份文档中出现了Cannon Lake之外,其他地方根本就没这系列的影子,说好的出货出哪儿去了?答案最终浮现是在中国市场上一款出货量并不大的新笔记本中:

从上面的广告Banner中,我们可以发现这款处理器的型号为Core i3-8121U,而它就是最初和最末的Cannon Lake处理器,整个Cannon Lake系列中唯一一款正式进入市场的处理器。

为了研究Cannon Lake和10nm工艺,各路硬件媒体马上从中国购买了这台笔记本回来,比如AnandTech的Ian Cutress博士就行动了,很多媒体随后都发布了对这款处理器的评测,其评价基调都差不多:失望。这款处理器在默认情况下基本上打不过规格类似的Core i3-8130U,甚至在同样的频率下面,作为拥有更先进工艺的处理器,它的功耗比Core i3-8130U还要大。

Cannon Lake被初代10nm工艺所严重拖累,以至于该系列仅推出了一款处理器就被Intel给砍掉了。为它配套的300系芯片组被修修改改用在了Coffee Lake身上,这也就是为什么,300系芯片组的代号是Cannon Point的原因。

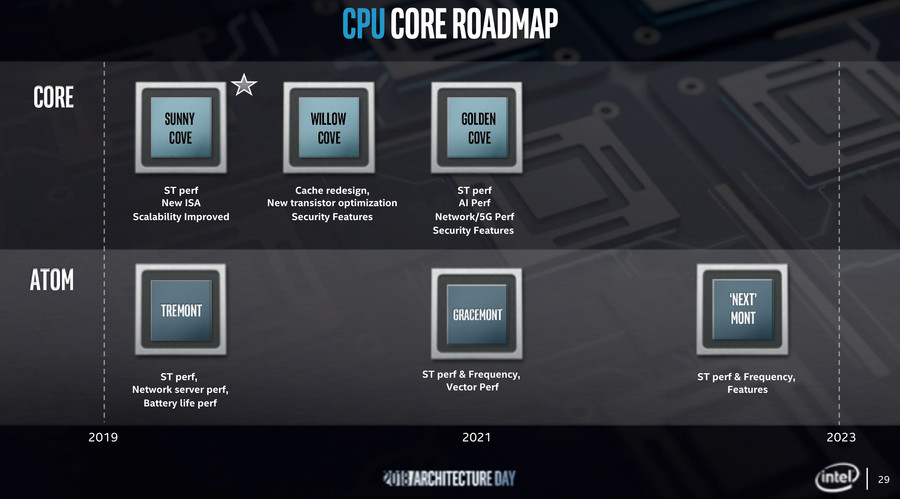
Cannon Lake虽然夭折了,但它对Intel仍然有着莫大的意义。首先,它是一个新PAO轮回的起点,正式引入了新的制程,其次,在Cannon Lake上面,Intel完成了其处理器平台与内核微架构的解耦,以往Intel处理器的内核与平台共同一个代号,而在Cannon Lake身上,两者分离了。Cannon Lake搭载了Skylake微架构的升级版——Palm Cove,而在2018年初期,Intel就正式公布了他们在内核微架构上的路线图:

但在整个2018年中,Intel都没有发布其PAO战略应该有的下一步,代号为Ice Lake的第二代10nm处理器,直到2019年年中,Intel终于在台北电脑展的发布会上面公开了该系列的具体详情,它可以说是Intel在2015年推出Skylake以来幅度最大的处理器升级,引入了诸多新特性。而在8月份,Intel正式宣布该系列处理器上市,在去年年末和今年年初一段时间,我们看到了大量搭载Ice Lake的处理器。但是尴尬的事情又再次发生了,Ice Lake系列的性能被发现打不过自家另外一系列的移动处理器,也就是代号为Comet Lake-U的14nm处理器。

上面两张图来自于Intel官方的宣传资料,他们拿AMD Ryzen 7 3700U分别对比了自家的Core i7-1065G7(Ice Lake)和Core i7-10710U(Comet Lake),后者同为TDP为15W的产品,但比前者要多两个核心,同时还有更高的睿频。从图上可以看到,Core i7-1065G7在不少场景下是比不过Core i7-10710U的。现在更有坊间的爱好者对Ice Lake进行了更为详尽的测试,其能耗比真的只能用失望两个字来形容。

看起来Intel解决了新制程生产良率的问题,却没有解决能耗比的问题,现在的10nm被卡在高发热量、频率上不去、上不了桌面端等等问题之中,实属非常尴尬。就在Intel被新工艺延期折腾的时候,竞争对手已经推出了第三代Ryzen处理器,并用上了经过大幅改良的Zen 2架构。

Zen 2与Renoir:AMD实现逆转的最后一块拼图

AMD在Zen架构获得一定成功后继续改良,推出了一代小改的Zen+,然后同样在2019年的台北电脑展上面,他们发布了基于Zen 2架构的第三代Ryzen处理器。Zen 2针对Zen架构单核性能不足的问题进行了针对性的加强,更为重要的是,AMD从内核微架构到内核互联到封装形式再到制程工艺上,全部都进行了脱胎换骨般的革新,这里我们不多谈细节,而是看到最终的成品上面去。桌面版Ryzen 3000处理器因为有优秀的性能表现和较为平实的价格而获得了广大消费者的认可,而基于同样架构、面向服务器市场的第二代EPYC处理器已经被Amazon和微软Azure等数据中心启用,而后推出的面向高端桌面及工作站的第三代线程撕裂者更是大幅度打破了Intel在这块领域的性能优势,甚至Linux之父Linus在上个礼拜也放弃了一直使用的Intel平台,换了颗Threadripper 3970x,还被这颗处理器的表现所折服了。

这也是自K8以来,AMD十余年时间首次在桌面端拥有了与Intel不分伯仲的实力,在企业级市场中的份额也有一定的上升。一片向好的情况下,移动市场成了Intel最后的遮羞布。然而……

在今年年初的CES上,AMD发布了代号为Renoir的Ryzen 4000系列APU,它将Zen 2内核与其他模块融合到了一块Die上面,最高提供8核16线程的配置,需要注意的是,就算是低压的15W版本,也有8核16线程的高配,这是以往在移动平台上从来没出现过的,此前Intel也就是把核心数推高到了6个而已,关键是,它凭借着工艺优势,在同样的TDP空间内提供了更好的性能。

Renoir的意义并不只限于给低压平台提供新的8核而已,它是AMD认真为移动平台打造的一代APU。为什么说是认真呢?前两代Ryzen APU的表现实际上还可以,也收获了一定的市场认可,诸如华为等新兴笔记本品牌都推出了基于这两代APU的廉价笔记本,甚至微软为自家的Surface Laptop还定制了一颗APU。但问题在于,由于核心调度、待机功耗等等地方没有做的很好,使用这两代APU的笔记本在续航表现上较为一般,性能只能说是将将够用,所以大的OEM并不是太买账。

而Renoir则是针对这些小毛病进行了认真的改进,尤其是在节能方面,配合上台积电优秀的制程工艺,Renoir在续航方面实现了突飞猛进般的提升,直追、甚至超过了Ice Lake平台的表现。在看到Renoir的改进之后,今年大的OEM纷纷开始大量采用Renoir APU,推出的产品有像联想小新系列的主流级学生本,有天选、R7000这样引发大量话题关注的高性价比游戏本,甚至AMD还和华硕合作搞出了幻14这样炫技的产品,这些都是对该系列的认可。

Renoir成功地将Intel的最后一块遮羞布给揭下了,几乎在全平台实现了逆转。那么Intel现在有给出什么应对手段吗?

Tiger Lake与Rocket Lake:Intel能否摆脱困境?

Intel的优势很大程度上来自于自家的制程工艺,原本他们的工艺平均领先其他代工厂约3.5年,但在14nm和10nm的两次延期之后,这种优势已经荡然无存了,台积电的N7在相当程度上接近、甚至超过了Intel的10nm工艺,而他们在N7之后的下一代制程——N5,已经被用于量产苹果今年的A14处理器了。

Intel面对着严峻的考验,当然他们有着这么大的家底,肯定是不会坐以待毙的。同样在年初的CES 2020上,Intel在自己的主题演讲末尾终于是提到了自己在移动端布局的新平台——Tiger Lake。

Tiger Lake可以说是Ice Lake的优化版本,不过优化力度有点强,主要有换用新的Willow Cove内核,换上Intel研发已久的Xe GPU架构,并且使用10nm+的工艺进行制造,在频率上面有所提升。从目前泄漏的各种跑分成绩来看,Tiger Lake在一定程度上走回了性能增长的正轨,有望在移动端与Renoir进行对抗,不过,它最多应该只有四核版本。

Tiger Lake仅会在移动端露面,而对于竞争乏力的桌面端,Intel规划了名为Rocket Lake的平台,它仍将会使用14nm++制程,不过它终于摆脱了使用多年的Skylake内核,换上新的Sunny Cove/Willow Cove内核,在IPC上面有较大进步。配合上14nm++能够提供的较高频率,有望提供一次较大的性能提升。

但问题在于,竞争对手并不是静止的。AMD方面仍然在按他们既定的路线图走着,明年的CPU市场仍然是风云变换的一年,Intel能否摆脱当前的困境,很大程度在于明年这些新东西的表现。

总结:受制程拖累是大头,但战略跟不上变化也存问题

在文章的结尾,我们还是回归本文的标题,分析一下Intel是怎么失去自己的性能优势地位的。在前文谈及Intel两次受到制程拖累时,其实已经谈到了Intel在战略上反映过慢、处于被动的迹象,这也是除开制程之外的另一个拖累Intel处理器性能发展的问题。

我们经常戏称Intel、佳能等一些厂商为“牙膏厂”,原因在于,他们产品的代际性能提升相当有限,就像挤牙膏一般,明明有这么一大管,每次挤却总是那么一丢丢。作为半导体芯片行业的领头羊,Intel的技术储备方面是很丰厚的,他们也完全有能力在制程受限的情况下对架构进行更新实现更大幅度的性能增长,结果他们并没有选择这条成本较高的发展路线,而是通过一手“拖”字决,靠着加核心提频率的“秘诀”,让自己的产品不至于很难看,但端上来的Coffee Lake、Coffee Lake Refresh和Comet Lake这三代产品实在难以说是有诚意,一次又一次的挤牙膏消费的是自己品牌的形象,也让竞争对手得以缓缓接近自己,甚至大有弯道超车的趋势。

虽然Intel处理器的游戏表现依旧优异,但其实这部分的优势很大程度上来自于它的Ringbus总线和超高的频率,而不是内核架构。在将核心数和频率提升到极限之后,Intel终于才开始规划内核上的升级,但此时又被制程给限制住了,在下一代Rocket Lake处理器上我们很有可能会看到最大核心数量倒退的情况。

在这里说如果已经是马后炮,只能看向未来。从目前在各种渠道中得知的情况来看,Intel在未来的一两年中面对的挑战相当严峻,Tiger Lake早期工程样片的表现仍然不尽如人意、Rocket Lake的功耗被继续推高,更远的Alder Lake甚至将引入还没有正式表现的8+8大小核设计,用现在的眼光来看,这几个都不是什么好消息。不过传奇人物Jim Keller已经被Intel招至麾下,挑起技术部门的大梁,他将带给Intel什么样的变化现在还不得而知,但从他的传奇经历来看,总体是偏向好的。

很多人说,Intel的收入大头不在消费级,而是在企业级,其实这种说法并不准确。Intel的主要收入来自于CCG与DCG这两个部门,前者面向消费级市场,产品就是我们日常见到的这些消费级CPU;DCG部门面向数据中心市场,产品是服务器级别的CPU(和其他AI方面的产品)。在最近几个财年中,CCG与DCG的收入基本持平,CCG稍多几个百分点,但消费级产品的颓势已经明显影响到了部门的收入,上个财年CCG的收入增长几乎停滞,只有0.1%。而DCG的发展情况仍然大好。

总而言之,14nm和10nm的两次延期让Intel将自己工艺上平均领先3.5年的优势给消磨殆尽,而战略上的迟缓应对让他们逐渐处于被动地位。未来一到两年之内,他们相对弱势的情况不会有很大的改变,如果不对目前“挤牙膏”的现状做出改变,那“AMD,Yes”的口号,真的会越来越深入人心了。

远离Sony产品,珍惜财产安全

人呐,是不能有闲钱的,一旦有钱了呢,就想消费。

那天用着买了快有两年的QC30,开着最高强度降噪,没半天电量就从100%跌到50%了。这办公室呢,总归有几个喜欢大声交谈的同事,不挂个主动降噪,光靠用海绵套隔绝声音是远远不够的。想着Sony不是掏了个二代狗圈出来吗,正好自己好久没买Sony的东西了,思索了一下,该是时候体验一下Sony的产品了。正好身边有不少购买了一代狗圈的朋友,都对这款产品挺满意的,想着二代总不能比一代还差吧,就下单购买了WI-1000XM2。

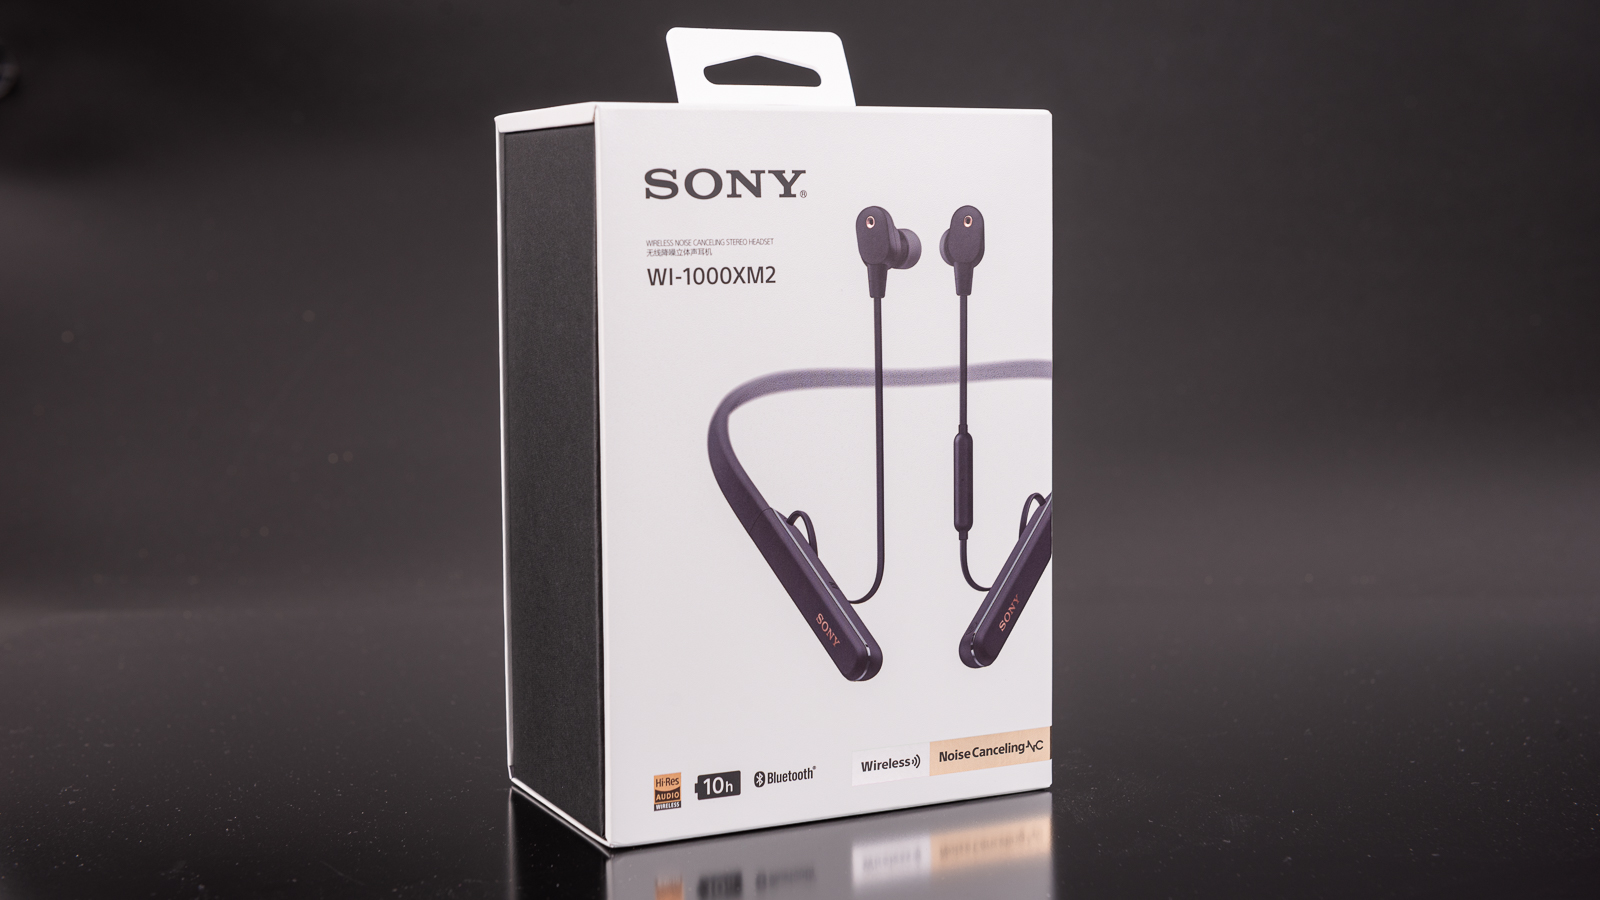
由于是淘宝卖家,下单时间在凌晨的货也是下午五点之后才会发快递,还好是同城顺丰,今天中午前就拿到了。简单做个开箱:

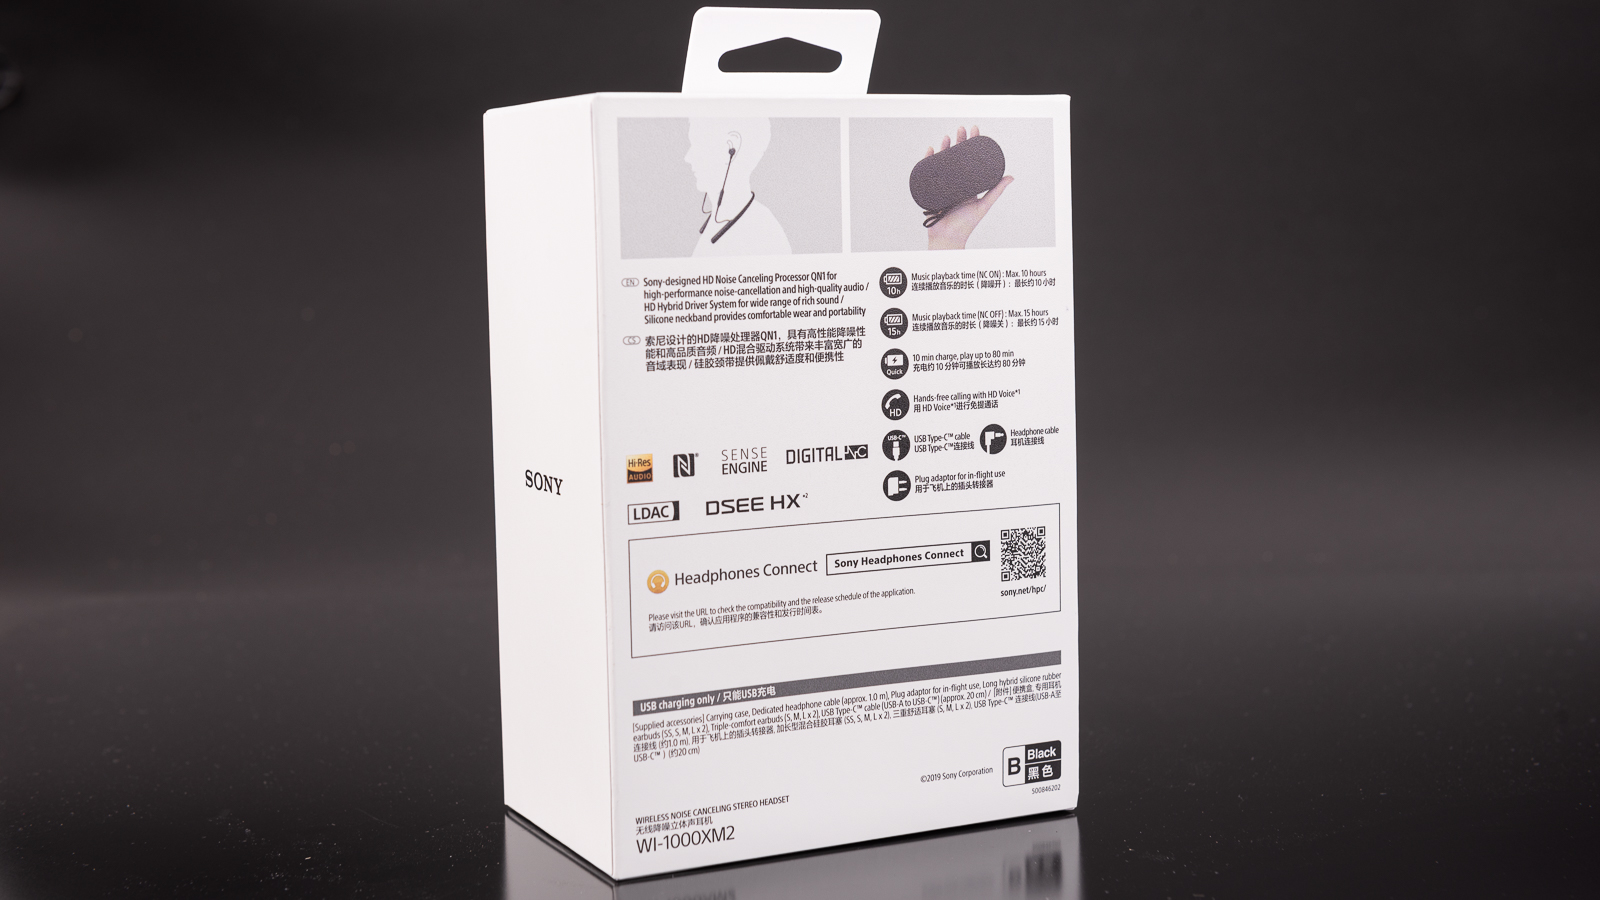
由于这代将原本的硬质项圈改成了软质硅胶环,所以包装也变小了很多。当然该有的Logo还是一个不少的,像什么小金标、NFC,索尼自家的DSEE HX技术等等,能写上两排。

打开包装,拿出内容物,先是一张提醒我要用Sony自家的App进行连接的挡卡。

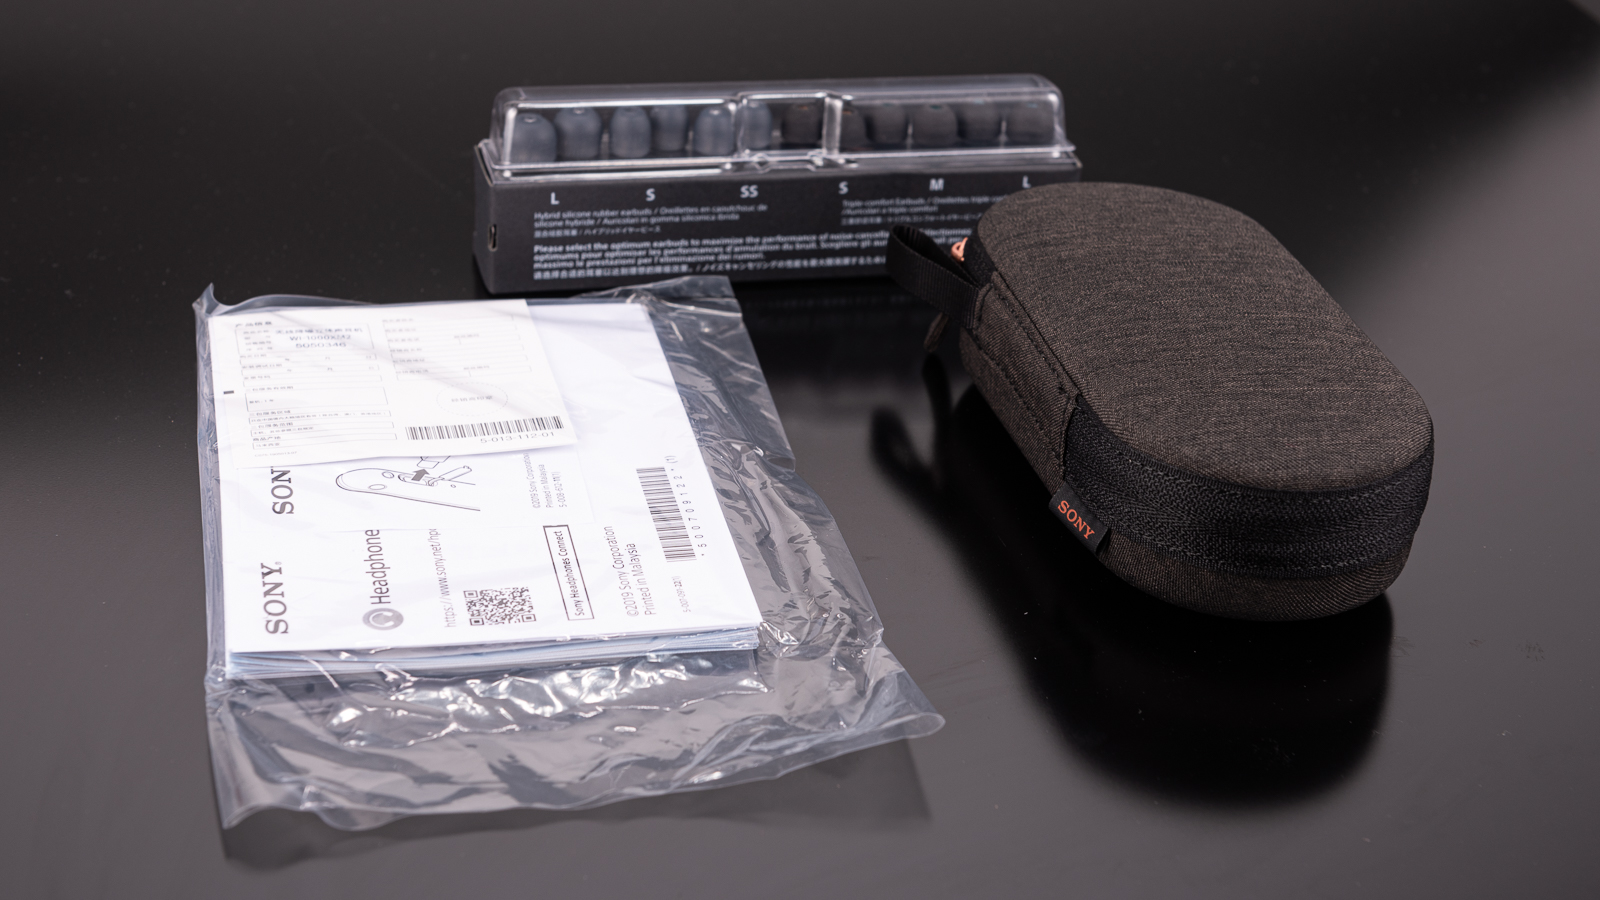
盒子里面的东西也被包装起来了,分成收纳包、附件盒和纸质文档三类。

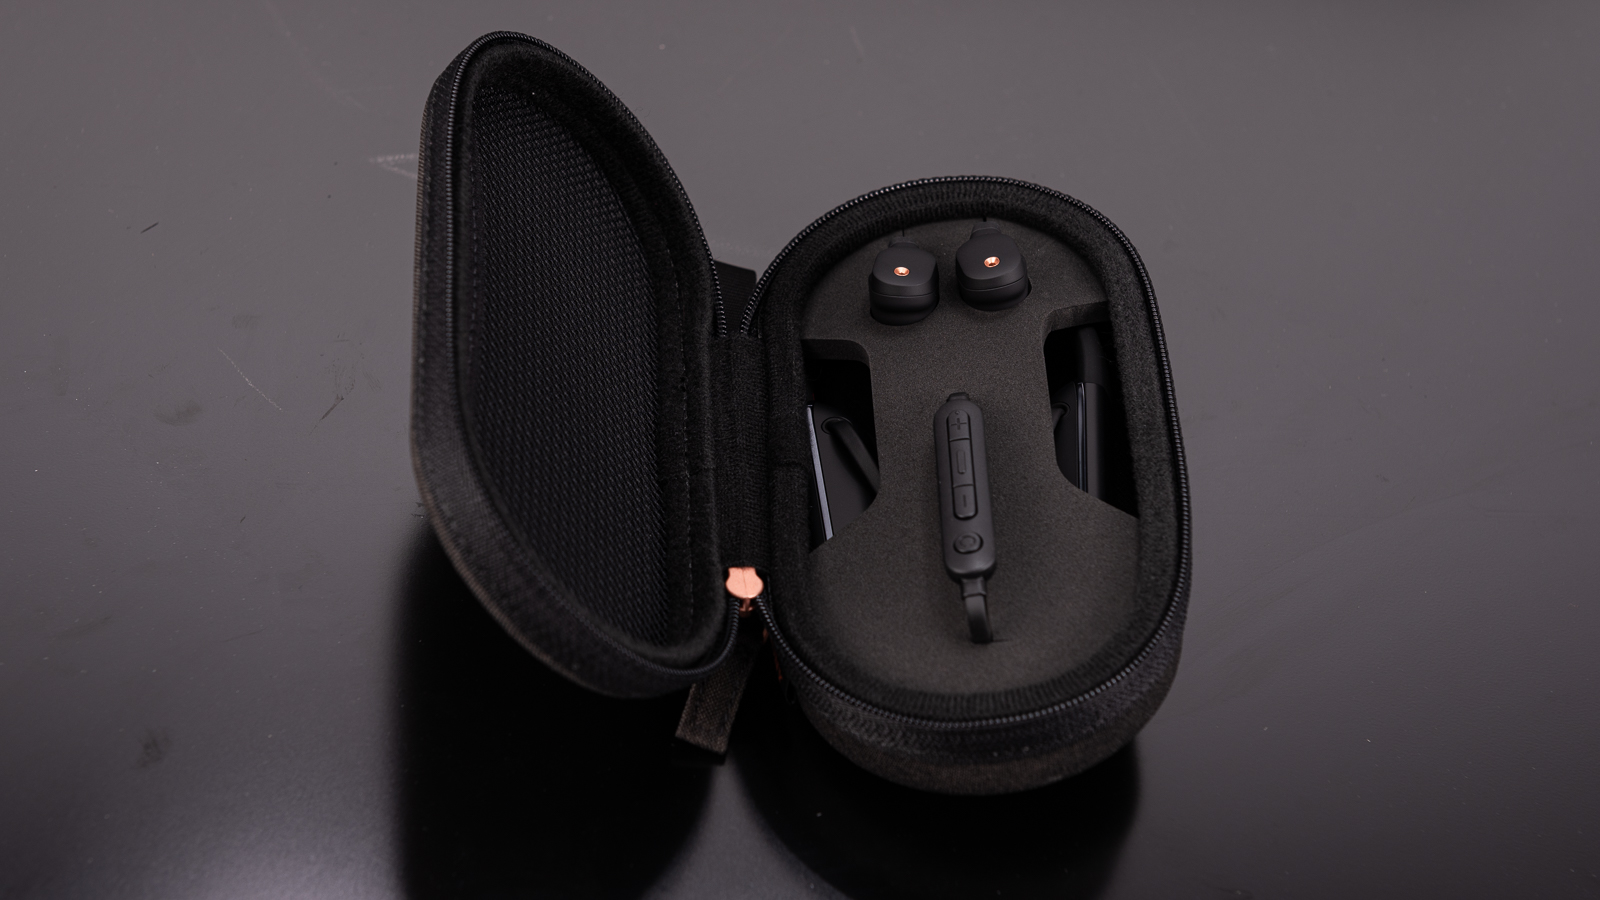
收纳包中自然就有本体。

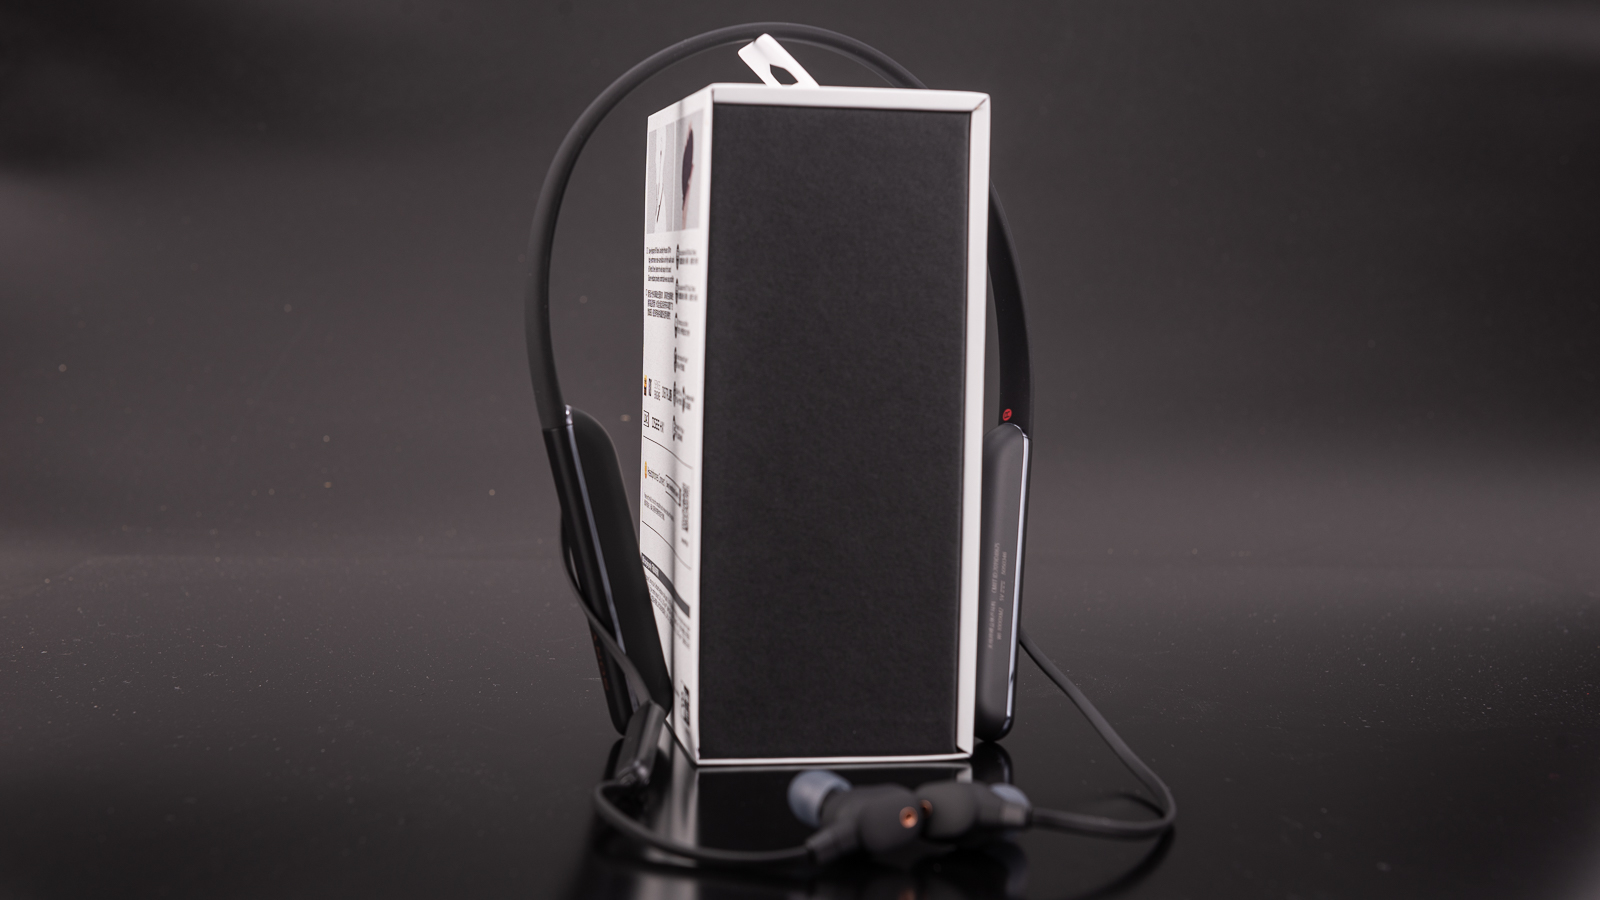
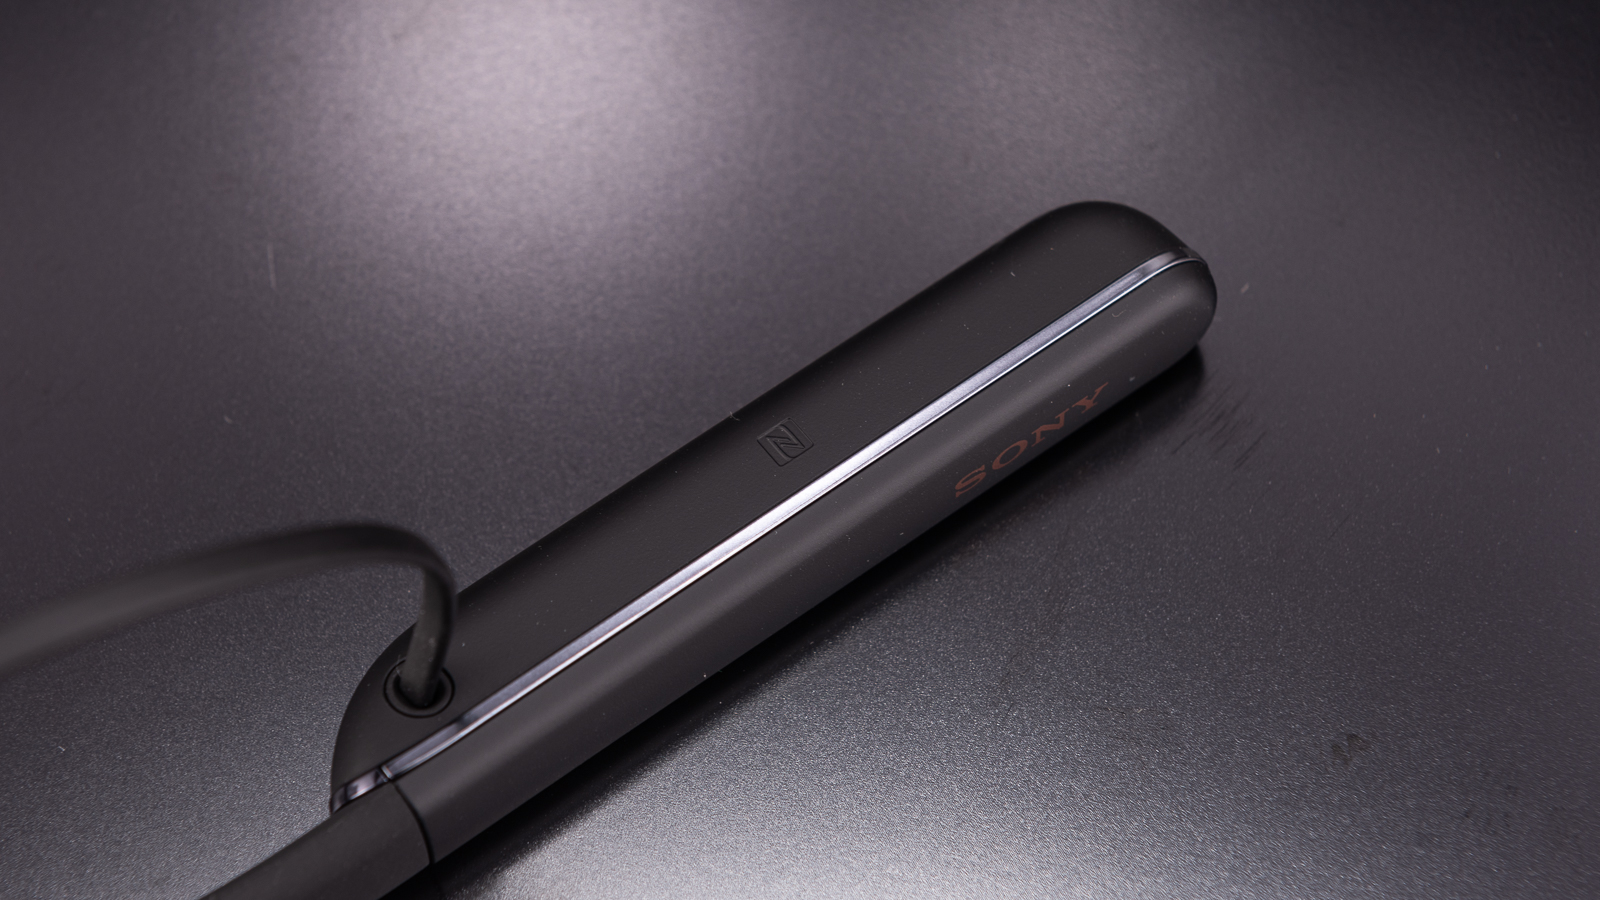
这代悬挂起来是这个样子的,电池和核心电路都位于左右两边的悬挂体中。

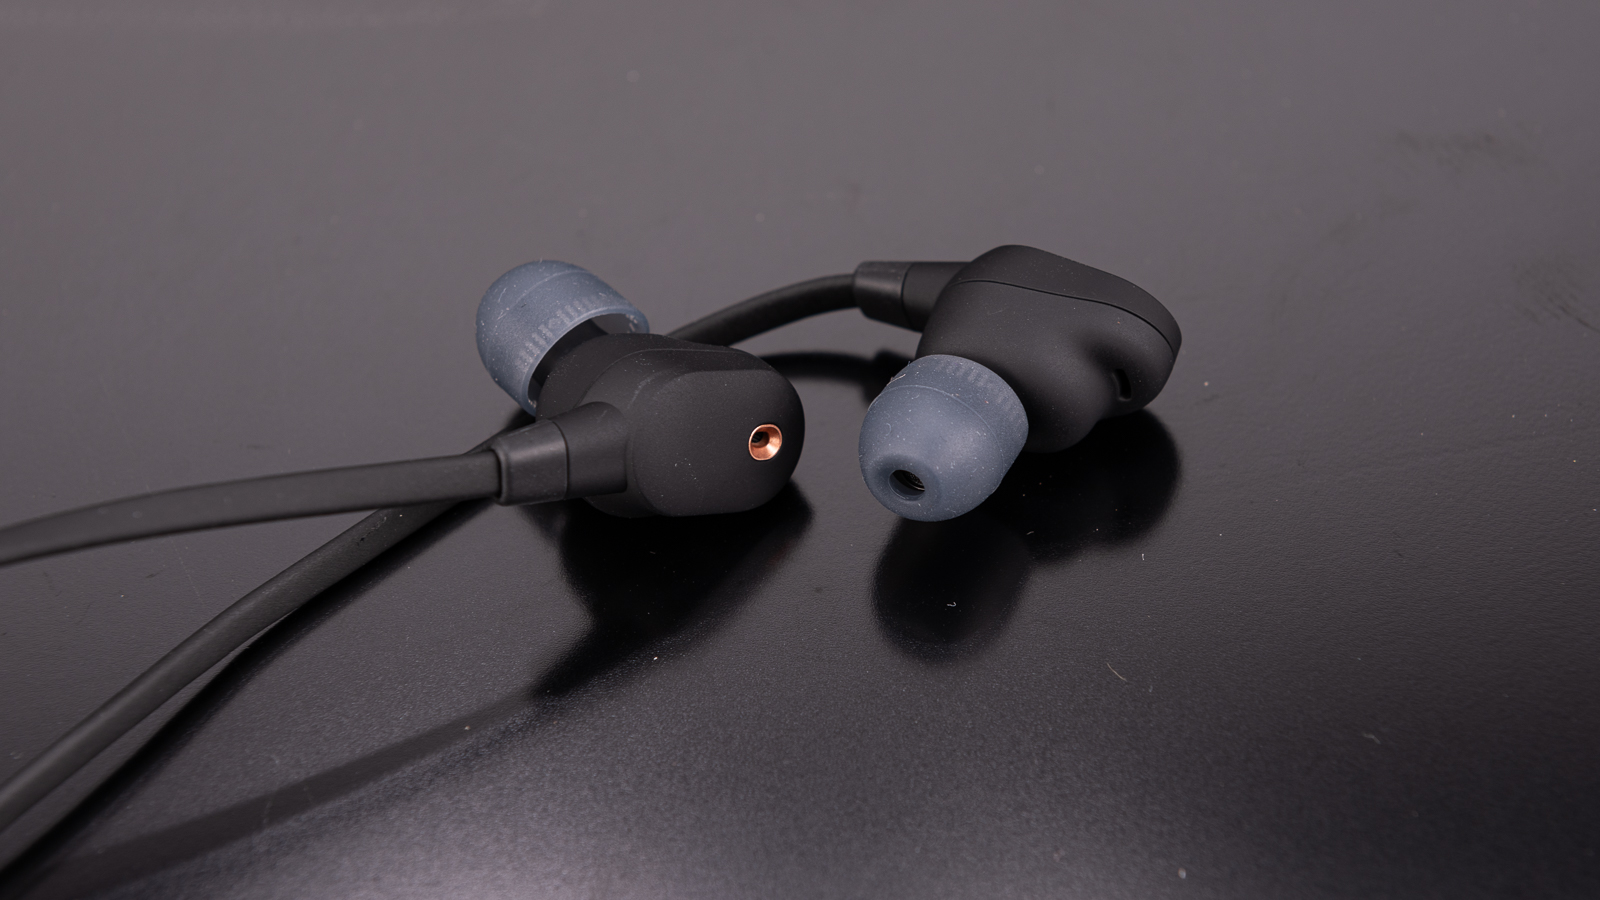
Sony的附件还是管够的,除了收纳盒之外,他们还提供了两种类型三种大小总计六对的替换用耳塞,算上耳机上自带的那一对,一共就是七对耳塞。两种不同的类型指的是在常见的普通硅胶耳塞外,Sony还提供了三对拥有加厚内壁的“舒适”耳塞。另外,必须有的USB连接线和耳机特色功能的3.5mm对录线也一并提供,甚至还有一个用于飞行的航空音频插头。

东西看上去很不错,那么用起来呢?

我首先在自己的Android手机上安装了Sony的Headphone Connect应用,并直接用手机触碰了位于右边的NFC标识进行连接。


NFC位于右侧悬挂

连接很顺利,手机也识别到设备支持LDAC编码,自动使用起它来。

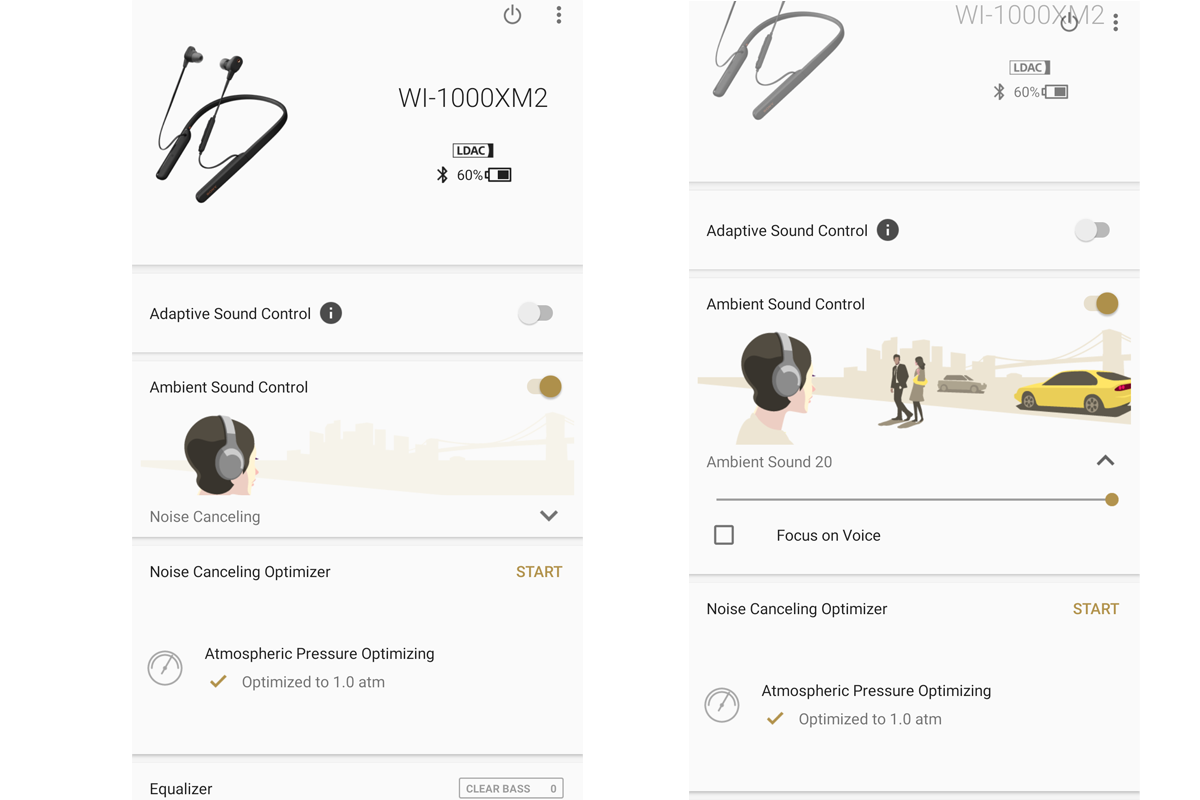
不过首次使用还是要打开App进行一番简单的设置:

降噪功能位于“环境声音控制”中,它有完全降噪、特殊的风噪降低模式和20档环境声音可选,就降噪来说,功能性算是比较丰富的。而其他附带的功能有自适应声音控制——耳机通过传感器数据来检测人的动作与姿态,自行采用最适合的模式。另外像是DSEE HX这个音效增强功能还是需要在应用中手动开启,不过我肯定是不会去用的。

不知道是不是Sony全家蓝牙设备都这样,它不能改名,让我这个有给设备统一命名习惯的人很难受。

难受归难受,新东西还是要好好感受一下的,取下脖子上挂的QC30,用新设备听会儿歌。WI-1000XM2用了一个动铁单元+动圈单元的组合,硬素质上相比只有动圈单元的QC30是要好上一些的。但实际上在刚开声的时候,它会让你深刻怀疑这钱花的不值,因为确实糊。不过在短暂煲机七八小时后,糊的情况有了改善,起码听某首中型编制Live时声场终于是散开来而不是一团了。调音上,相比起QC30的偏下盘走量,Sony还是有些不同,低频量控制的还不错,中高频给个及格分吧,人声并不远,偏流行的取向还是比较讨好耳朵的。

再来谈谈降噪表现,这也是降噪耳机最应该做好的地方。Sony在这方面应该算是追随者,尽管很多人都说他们已经追上了前辈Bose的脚步,但从实际使用来看,还是有差距。WI-1000XM2对人声的消除做的不如QC30,在降噪模式下音量开得不够大,外界人声是可以准确穿透进来的,而在同样位置,差不多音量的情况下,QC30也会让人声穿透进来,但是更为模糊。戴着WI-1000XM2还能听清楚别人在说什么,但是QC30就不行,这让我严重怀疑起之前看的各种评测文章来。不过WI-1000XM2的降噪模式是可以完全关闭的,关闭之后,它跟普通的蓝牙耳机就没啥区别了。


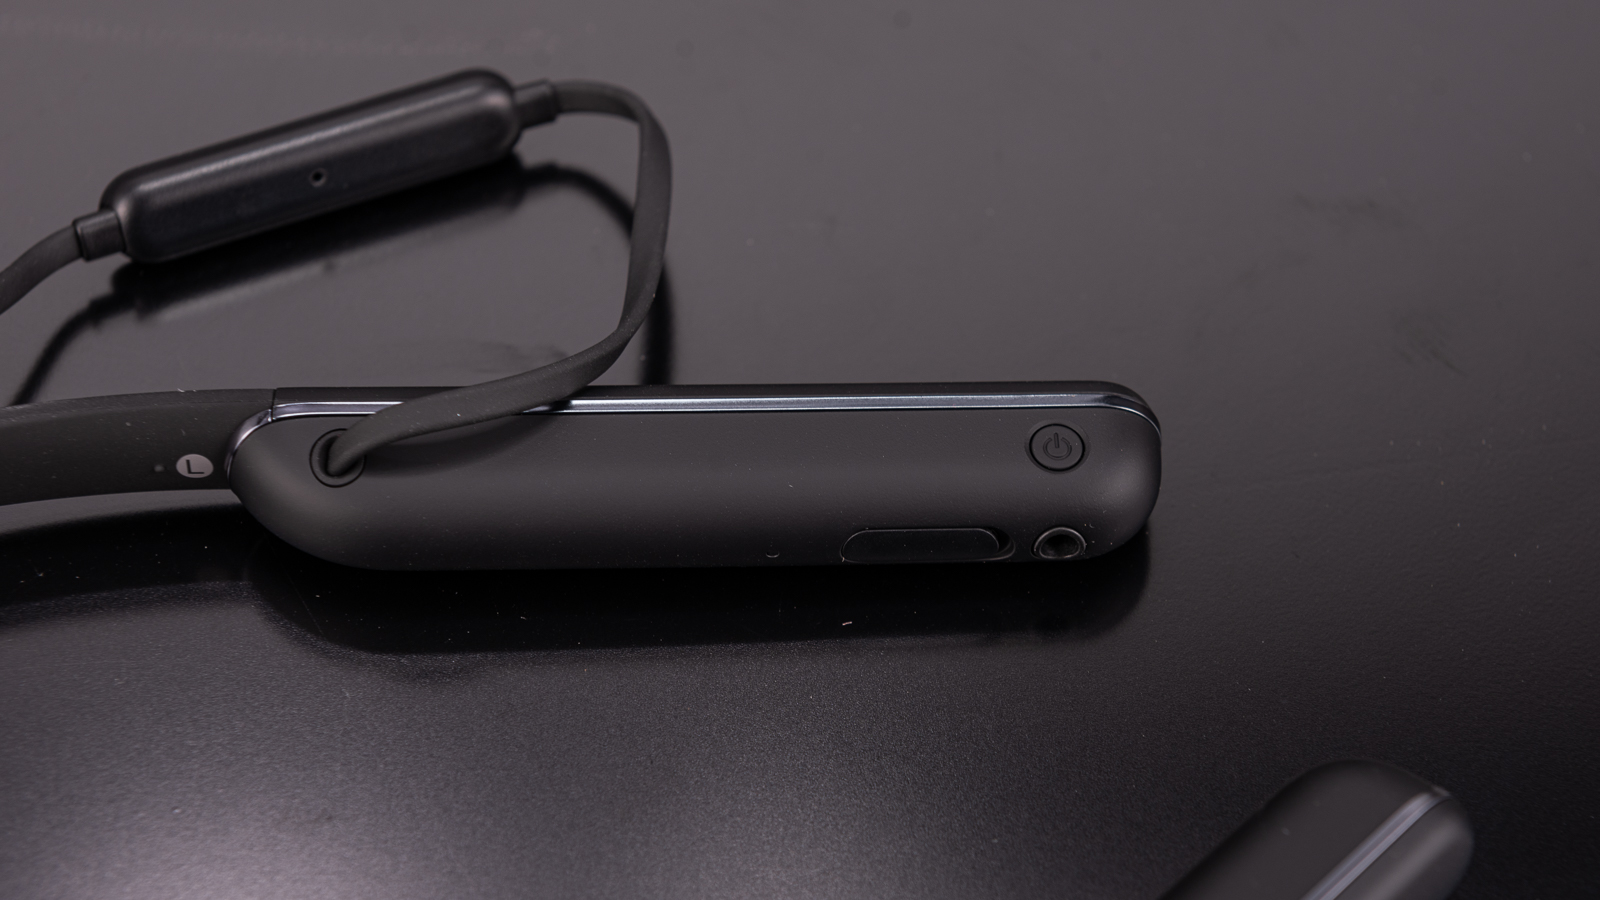
左侧悬挂有电源按钮、3.5mm插孔和USB-C充电口

佩戴方面WI-1000XM2是给到了不错的体验的,后颈接触到的不再是偏硬的项圈,而是较软的硅胶环,异物感要小很多。但有一点要说的是,Sony那用了一万年的扁面条线又立功了,过长的耳机线让听诊器效应重新出现了,只好手动绕耳一圈以减少线材与衣物的摩擦,进而降低听诊器效应。另外还要吐槽下它的线控,WI-1000XM2的线控是正面四个按钮,从上到下为音量+、播放/暂停、音量-和“C按钮”,上部三个常用按键之间没有大的间隔,并且音量+上面还设计了一个小突触以定位,但一般情况下,用户是以面积最大的按键做定位,所以很容易摸错按键位置,比如说想摸音量-却摸到了尾端的“C按钮”然后一按就把降噪等级给改了,幸好中间的播放/暂停键上面有一条长凸起可以帮助定位。另外,线控按键的触发力度过小了,容易误操作。麦克风录音时降噪会关闭,使用的是线控上面的麦,收音效果尚可。


左侧设计了一个用于盲认LR的小凸起,线控上也有类似的设计

最后,总结一下这次消费,两个字:不值。首先,如果是一代或者QC30用户想换新,那么WI-1000XM2并不会在体验上给你惊喜,甚至可以说基本没有区别,甚至从QC30转过来还会发现它只能够连接一个设备了。不过如果是还没有主动降噪相关产品,想入手一款颈挂式主动降噪耳机的话,本着买新不买旧的原则,WI-1000XM2是目前较好的选择。

结尾处还是说一说Sony吧,我真的不明白为什么会有这么多Sony的粉丝,尤其是1000系列,这系列的三种类型产品,实际用下来的感觉都只是中规中矩,不太出众,也有小问题,难怪会变成跳水之王。在这次冲动消费之后,我应该会在较长一段时间内不会碰Sony的产品了。

数字视频编码的发展历程

大家久等了,这是多媒体文件格式系列课堂文章的第三篇,前面已经讲过了容器与音频编码,现在我们要看到最为复杂的视频编码了,人们一直在想尽办法提高视频编码的效率,让它在尽可能小的体积内提供最好的画面质量,从而满足人们对于视频传输、存储的需求。和前两篇文章中介绍的容器与音频编码不同的是,视频编码有一条较为清晰的发展脉络,比种类繁多且不统一的音频编码要容易理顺,目前国际通行的视频编码标准基本上都是由MPEG(动态图像专家组)和ITU-T(国际电信联盟电信标准化部门)等组织牵头开发的,另外还有一些零星的编码,它们可能在一段短暂的时间内占据主流地位,不过最终还是让位于国际通行标准。

国际上主要通行的编码标准为ITU-T组织的H.26x系列视频编码和MPEG组织制定的部分编码标准,有一点需要说明的是,同样的一个标准在不同组织那儿可能会叫成不同名字,比如最典型的就是AVC(高级视频编码),大家可能更熟悉它的另一个名字——H.264,AVC是MPEG组织在标准中给它起的名字,MPEG组织从属于国际标准化组织(ISO)和国际电工委员会(IEC),所以在ISO标准中,它的正式名字是“MPEG-4 Part 10, Advanced Video Coding”。这种情况多见于H.26x系列编码,下文会注出。

而在这条主要脉络中,基本上囊括了接近半个世纪以来,视频编码的技术发展,我们将主要沿着H.26x以及MPEG这条主要脉络,为各位读者简单梳理出一条视频编码的发展历程。

为什么我们需要对视频进行压缩编码?

很简单,就是为了减小视频占用的容量大小。

数字视频实质上就是一帧帧连续的图像,虽然一帧图像的大小并不大,但每秒至少得有24帧图像(一般情况),它们累计起来就会占据非常大的空间,我们没有那么多的地方存储原始数据,那么只有一条路可以走,对它进行压缩。而视频的编码过程就是这个压缩过程,但与音频一样,在传统数据压缩算法来看视频文件里面基本上是没有什么冗余信息的,所以人们就有必要去开发针对视频的压缩算法,把实际存在的冗余信息给去掉,从而减少它的数据量,达到减小占用容量的目的。因此,目前的视频编码基本上都是有损的,意味着编码过后的视频在画面质量上会有损失。

前蓝光时代的视频编码发展之路

让我们首先沿着国际标准,按时间顺序来看看视频编码是怎么一步一步“现代化”的。
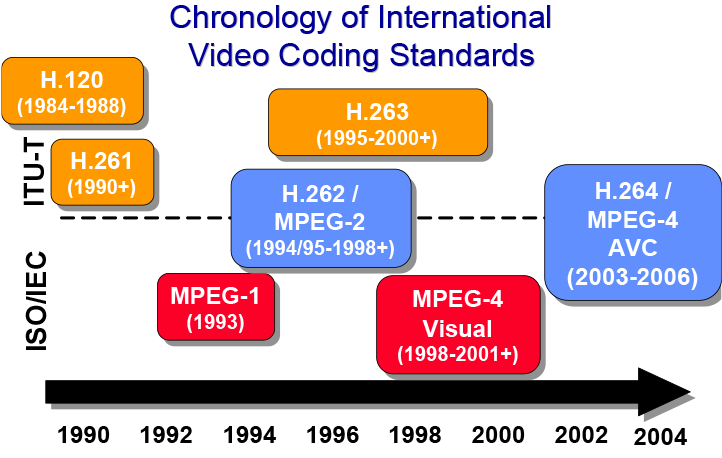
在模拟电视和胶片电影时代,我们看到的内容都是模拟信号还原出来的。但随着人们的需求不断提高,和计算机、网络的蓬勃发展,我们需要新的、能够承载视频内容的数字编码,用来支持视频内容在互联网上的传输,或是将其存储在数字化的存储设备中。

在上世纪七十年代末八十年代初的时候,人们已经研究出了不少新的针对图像等多媒体内容的压缩算法,此时开发数字视频编码的条件已经基本成熟,而第一个开发出实际编码的,就是后来在数字视频编码领域中起领头作用的视频编码专家组(Video Coding Experts Group),他们是当时名字还是“国际电报和电话咨询委员会(CCITT)”的ITU-T(国际电信联盟电信标准化部门)组织下面的专家组。这个编码被命名为H.120,它诞生于1984年,是一种偏向于实验性质的早期编码,主要基于差分PCM编码,用来保存电视内容,但是它并没有大规模的实际运用。

H.261:引入各种特性,奠定现代视频编码基础

在制定完H.120过后几年,VCEG并没有停止他们在视频编码上面的研究。此时很多跨国公司已经使用网络进行视频会议的需求了,在互联网带宽尚不充裕的年代里,人们需要新的视频编码来实现流畅而优质的实时视频通信,H.261就应运而生了。

H.261与首个数字视频编码标准H.120并没有直接的继承关系,它可以说是完全另起炉灶的一种编码。在针对图像的压缩算法上,H.261使用了我们现在比较熟悉的离散余弦变换(DCT)算法, 它在后来的JPEG编码中起主要作用。但不止于此,它引入了一系列针对视频的特性,奠定了现代视频编码的基础,其中主要有宏块(Macroblock)和基于宏块的运动补偿(Motion Compensation)。

宏块与基于运动补偿的帧间预测

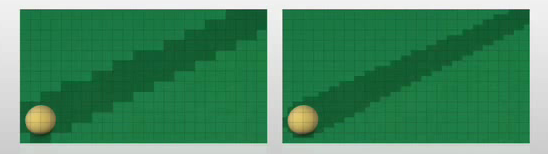
我们知道,视频是由一帧一帧的图像组成的组合,一般情况下一秒钟的视频中会包含24、25、30、60或更多张图片,它们按照一定的时间间隔播放出来,基于视觉残留原理形成了流畅、会动的画面。在连续的几帧之间,实际上存在着大量重复的画面,比如说下面这个例子:
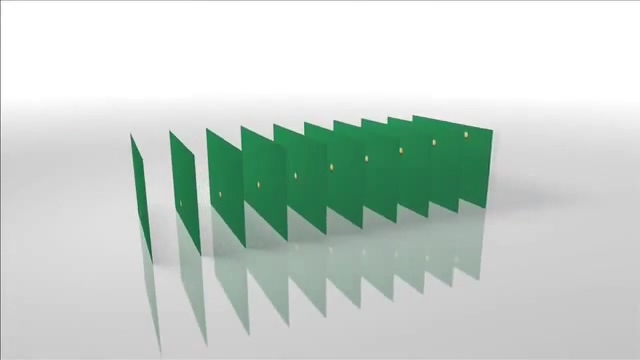
一个白色台球在绿色桌面上面运动
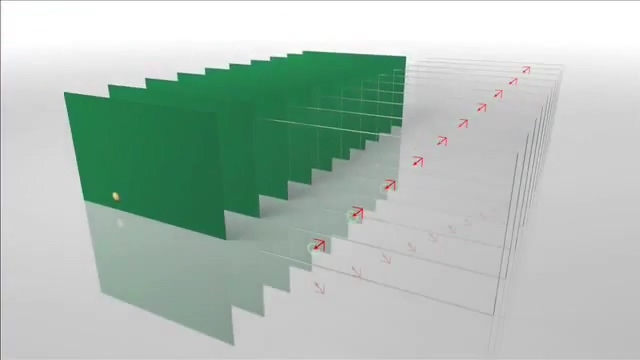

用小球运动的方向和距离来描述图像的变化

如果是以传统的思路对每一帧图像做压缩的话,显然整个视频在压缩过后仍存在大量的冗余。那么怎么办呢?H.261标准引入了宏块的思维,它将整个画面切分为许多小块,然后再引入基于运动补偿的帧间预测——画面的大部分都是不动的,那么我们将不动部分的区块沿用之前的压缩结果,动的部分用运动方向加距离这样一个矢量来描述不就可以节省出大量的存储空间了吗?

DCT算法
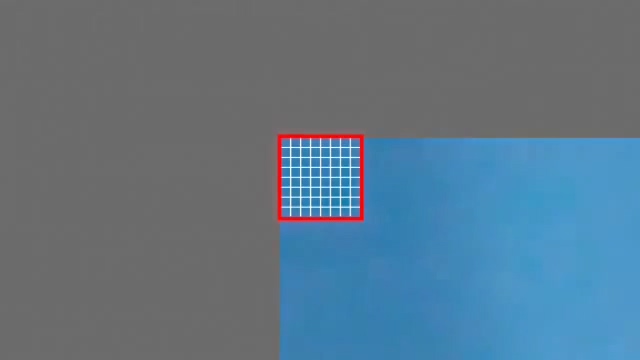
将8x8个像素分成一个块
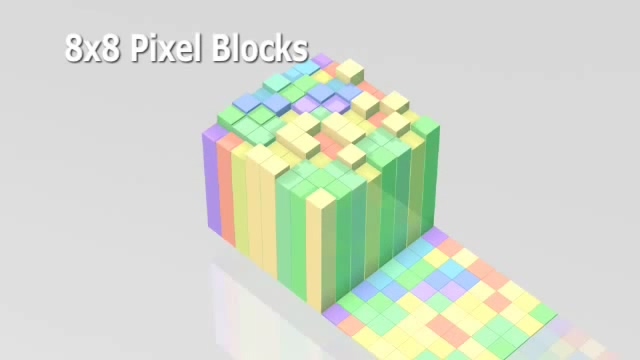
DCT算法起源于上世纪70年代,到了80年代中后期,有研究者开始将其用于图像压缩。这种算法可以将图像从空间域转换到频率域,然后做量化——减少人眼敏感程度较低的高频信息,保留绝大部分低频信息,从而减少图像的体积。最后再用高效的数据编码方式将处理过后的数据进一步压缩,这里使用了Zig-Zag扫描和可变长编码。

注:图像的高频部分存有很多细节信息,而低频部分则存有轮廓等覆盖范围较大的信息。
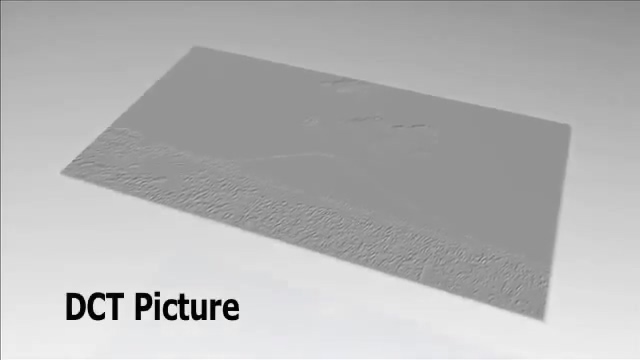
亮度通道做DCT变换后的图像,可以看到上方颜色连续部分非常平坦,而下方则拥有诸多细节

在H.261及之后基于H.261框架的视频编码中,DCT算法主要针对的是关键帧的压缩,所谓关键帧,就是在运动补偿中作为基准参考的一帧。打个比方,就像Flash动画中的关键帧一样,它定义了一个起点,后续的几帧都是基于这个关键帧演算出来的。因为它只做帧内压缩,不涉及其他帧,又被称为Intra-frame(帧内编码帧),简称I帧。

小结:创立混合编码框架,有里程碑意义

H.261设计的目标是编码出比特率在64~2048kbps范围内的视频,以用于实时的视频电话等应用。它首次确立了帧内预测与帧间预测同时使用的编码框架,在消除每一帧本身存有的冗余外,消除了帧与帧之间的冗余信息,从而大幅度降低了码率,成为了实际可用性相当高的一种视频编码。而它的编码框架也影响到了之后几乎所有的视频编码,尤其是H.26x和MPEG家族。

需要说明的是,H.261只是规定了该如何解码,只需要编码器最终产生的视频流可以被所有H.261解码器顺利解码即可。至于你前面怎么编码的,具体用的算法如何不同都没有关系,这点适用于之后几乎所有的视频编码。

MPEG-1 Part 2:引入帧类型概念,成为VCD标准

几乎在H.261开发的同时间,1988年,ISO和IEC两大国际标准化组织建立了MPEG(动态图像专家组,Moving Picture Experts Group)以开发国际标准化的音视频压缩编码。他们在1992年11月份完成了MPEG-1整套标准的制定,其中的第二部分标准化了一个新的视频压缩编码,它受到H.261的深刻影响,继承和发展了分块、运动补偿、DCT算法等思想,并做出了自己的改进,比如引入新的双向预测帧、亚像素精度的运动补偿等新技术。

引入双向预测帧(B帧)

H.261引入基于运动补偿的帧间预测算法之后,视频中的帧其实就已经分成两类了,一类是完整的,称为关键帧(Intra-frame),它就是一张完整的静态图像,可以直接被解码出来。另外的帧则是通过运动补偿算法在关键帧之上计算得到的。
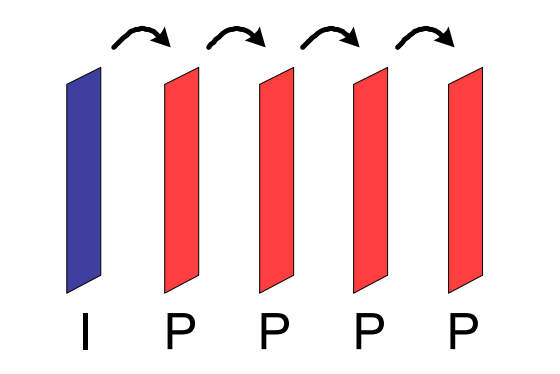
MPEG-1 Part 2引入了帧类别的概念,原来的关键帧被称为“I帧”,基于帧间预测计算得到的帧为P帧。在这两种H.261已有的帧类型外,它引入了一种新的帧:双向预测帧,也叫作B帧。
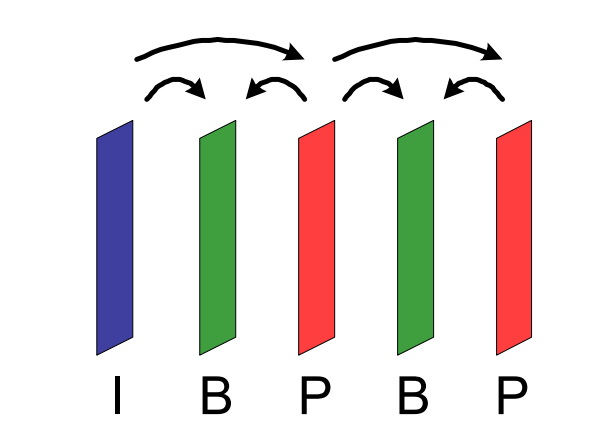
原本的P帧只能够前向预测,也就是说,它只能够基于前一帧计算得到。双向预测,顾名思义,它可以用前面的一帧作为自己的参考,也可以用后面那帧来进行预测。由于参考了更多的信息,B帧自身就可以包含更少的信息量,其压缩比自然就要比只能做单向预测的P帧还要高了。但是,B帧的引入带来了一个新的问题,即编解码难度上升了。

引入帧序列(Group of Pictures)

帧序列是一些按顺序排列的图像帧的组合,简称为GOP。一个GOP的头部是一个I帧,也只会有一个I帧,它包含了该GOP的基准参考图像信息,其后是数个P帧、B帧,它们都是以开头的I帧为基础,经过计算得到的。
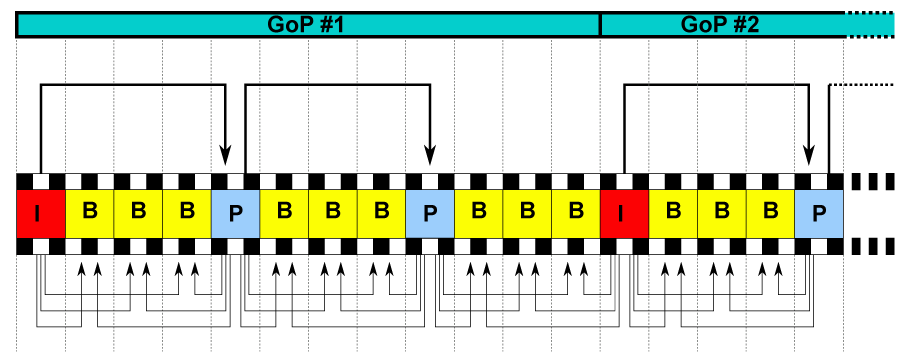
上面的图片就描述了一个完整的GOP,可以看到一个I和P帧之间隔了三个B帧。实际应用中,B帧确实是数量最多的帧类型。

亚像素精度的运动补偿

H.261中引入的帧间预测精度为像素级的,对很多分块的运动瞄准是不精确的,这点在MPEG-1上得到了有效改进。他们引入了亚像素级别的运动补偿,可以以1/2像素级别描述像素块的运动。
小结:成功接棒

MPEG-1成功地继承了H.261的技术框架,并对其进行了有效的补充,从而达成了不错的压缩比。在那个人们普遍还在用VHS录像带的年代里,MPEG-1已经能够以1~2Mbps的码率提供类似于VHS录像带的画质了。这也使得它被选用为VCD的标准,在世界范围,尤其是在我国风行十余年。

不过MPEG-1主要面向低码率应用,但实际上它在高码率下的表现也不差,于是,MPEG很快推出了它的升级版本,也就是MPEG-2。

MPEG-2 Part 2/H.262:DVD与(前)数字电视标准

1994年推出的MPEG-2中标准化了一种新的视频编码,它在1995年被ITU-T接纳为H.262,在这里我们简单称它为MPEG-2。相对于1993年推出的MPEG-1,它并没有太大的改动,主要是针对DVD应用和数字时代进行了改良。

支持隔行扫描

隔行扫描放在今天也并不是过时的概念,在九十年代初期,这种扫描方式有效降低了视频传输所需的数据带宽。平常我们看到的视频画面大部分都是逐行扫描(Progressive scan)的,比如说视频的垂直分辨率为1080像素,那么每帧画面的垂直分辨率就是1080像素。

而隔行扫描,顾名思义就是隔一行扫一次,它将每一帧画面拆分成两个场,每个场保留原有帧一半的信息。这种扫描方式在保证画面流畅度的同时降低了对传输带宽的需求,被各国的电视广播系统采纳使用。MPEG-2在制定时充分考虑到了数字电视系统的需求,加入了对隔行扫描的支持。

面向高码率和标清、高清晰度

从上世纪90年代开始,数字电视系统逐渐开始普及,它带来了更大的传输带宽。同时,DVD标准也快要尘埃落定,它提供了比CD大几倍的容量,能够承载更为清晰的画面。因此,MPEG-2提升了自己的目标码率范围,从MPEG-1时代的12Mbps实际豪爽地倍增到610Mbps,甚至在高清时代,它能够用20Mbps左右的码率传输高清画面。

小结:曾经最为通用的视频编码

MPEG-2虽然没有加入太多新的特性,在压缩率方面实际没有太大的提升,但由于它被选中成为DVD-Video、数字电视、DV等等一系列应用的标准编码,顺利地成为了世界范围内通行的视频编码格式,时至今日,它仍然被大量地应用在数字电视等系统中。

H.263:FLV与3GP的好搭档

原先的H.261和MPEG-1都是偏向于低码率应用的,随着互联网和通讯技术的飞速发展,人们对网络视频的需求在提高,在低码率下追求更高质量的视频成为了新的目标,而作为通信业的一大标准制定者,ITU-T在1995年推出了H.261的直接继承者——H.263。

H.263有多个版本,在1995年推出的初版中,它主要引入了在MPEG-1上开始应用的亚像素精度运动补偿,同样支持到1/2像素的精度。另外它改进了使用的DCT算法,加入了新的运动向量中值预测法,在编码效率上相比H.261有较为明显的提升。

需要注意的是,以上特性仅仅是它的基础部分,只需要实现这些新东西就算是支持H.263了,但它还给出了一系列额外的、用于增强压缩率的特性,比如说,在MPEG-1中新增的B帧,到了H.263中成了额外的PB帧。

H.263是一个被不断升级的编码,在初版之后还存在H.263+和H.263++两个官方升级版。在H.263+中,它着重提升了压缩率,相对初版有15~25%的总体提升。同时在2001年的修订中,它还引入了“Profile”的概念,将各种特性分成几个级别,完整支持某一级别的特性即为支持此Profile,比如说,初版H.263的基础部分是它的“Baseline”Profile。

H.263在互联网和通信业中得到了广泛的应用,它一度活跃在各种视频网站上面,和Flash播放器一起撑起了互联网在线视频的一片天,而在通信业中,被3GPP组织采纳成为多种通信标准中的标准视频编码,比如说MMS——也就是彩信。

另外它还被MPEG组织参考,作为MPEG-4 Part 2的基础。

MPEG-4 Part 2:特性很多,实现很多

在MPEG-2之后,MPEG组织有了新的目标——开发一套压缩率更高的编码框架,但同时保留对低复杂性的支持。1998年,MPEG-4标准正式诞生,其中第二部分定义了一套新的视觉编码体系,是的,它并不是仅仅针对于视频应用,而是广泛意义上的视觉(Visual),故也被称为MPEG-4 “Visual”。

它的核心设计实际上与H.263趋同,但是包含了更多关于编码效率的增强。它定义了复杂度不同的多种Profile,从最基本的Simple Profile到非常复杂的Simple Studio Profile,前者不支持B帧,而后者甚至支持到4K分辨率和12-bit、4:4:4采样的编码。

尽管MPEG-4 Visual是一个野心勃勃的编码,但它遭到了业界的冷待和批评。一个是它的压缩率相比起MPEG-2并没有重大提升,而因为授权和专利费用问题,很多厂商选择自己去实现一套兼容MP EG-4 Visual的编码,而不是直接采用标准,这其中就有经典的DivX和Xvid两兄弟,微软也拿它作为Windows Media Video的基础,一点点升级到WMV9。

其他编码

时间已经来到二十一世纪,高清视频和高清电视开始普及,新的应用带来了更高的需求,迫使业界开始研究新的更高效的视频编码,我们熟知的AVC即将登场,不过在介绍它之前,我们先来看看其他几个有较多应用的视频编码。

MJPEG

JPEG想必大家都很熟悉,这个MJPEG跟JPEG之间有着千丝万缕的关系。视频不是一帧一帧的吗?那每一帧都用JPEG进行压缩,然后组合起来不就行了吗?是的,MJPEG就是一个JPEG图像组合,每一帧包含了完整的图像信息,正因为如此,它的压缩率并不高,但是实现起来简单的特点让很多数码相机厂商将它作为相机的视频编码,实际上它得到了相当广泛的利用。

RealMedia

对于国人来说,RealMedia绝对是一个带有情怀的词语。他们家的RM系列编码在十多年前在国内网络上曾有相当的覆盖度。实际上它的实现基本上都是参考同时期的国际标准而来的,比如说清晰度和压缩比都很高,压过同时期DivX一头的rv40是参考了H.264而形成的。

RM最大的问题还是支持范围不广,在浏览器中播放RM需要插件,基于Flash播放器的视频网站的兴起也让它的用途逐渐变得狭隘,最终在正版H.264的冲击下,RM慢慢的销声匿迹了。

WMV

微软有自己的客厅梦想,除了Xbox以外,他们想让PC走进客厅,当然这都与Windows Media Video无关。微软基于MPEG-4 Part 2创造出了一系列新的编码,起初它们都被称为Microsoft MPEG-4或是Microsoft ISO MPEG-4,但很快,微软将其归入了Windows Media家族,首个版本是WMV7。

接下来微软在WMV7的基础上面不断加入自家的东西,使得它能够适应更高分辨率的视频,最后,他们在WMV9中加入了新的Profile,产生了新的VC-1编码。

蓝光时代标准之争

在DVD普及之后,高清视频的时代很快就到来了。人们很快发现,就算是双层DVD,其容量对1080p视频来说,也是完全不够用的。很快,大公司开发出了两种新的以蓝光为激光束的光盘,一种是以DVD论坛为首开发的HD DVD,另一种是Sony牵头另起炉灶的Blu-ray。两种光盘格式的战争我们按下不表,这里要讲的是,伴随着新光盘制式一起出现的全新视频编码标准——VC-1和H.264。

AVC/H.264:集大成者一统江湖

HD DVD和Blu-ray的标准里一共支持了三种视频编码,其一是古老的MPEG-2,其二是微软主推的VC-1,最后一种就是全新的AVC。别看它的名字很简单,其实它大有来头,是MPEG和ITU-T两个组织联合推出的新一代国际标准,在MPEG那儿被规范为MPEG-4 Part 10 Advanced Video Codec,在ITU-R那儿它又被标准化为H.264。

对于H.264这个名字,我想大家应该都不会耳熟。但就是这个现在我们每天都能够接触到的视频编码格式,曾在十多年前引发了一场软解危机,将当时很多主流CPU挑落马下,也使得ANI三家都在自己的产品中加入了辅助解码的硬件加速单元,不过这与我们的主题没什么关系,暂且按下不表。这里要讲的,还是H.264的厉害之处,究竟它用了什么手段能够在编码质量上面实现飞跃,从而独占市场十余年时间还没呈现衰退迹象。

总结下来主要有如下的几点:更灵活的宏块划分方法、数量更多的参考帧、更先进的帧内预测和压缩比更高的数据压缩算法。

更灵活的宏块划分方法

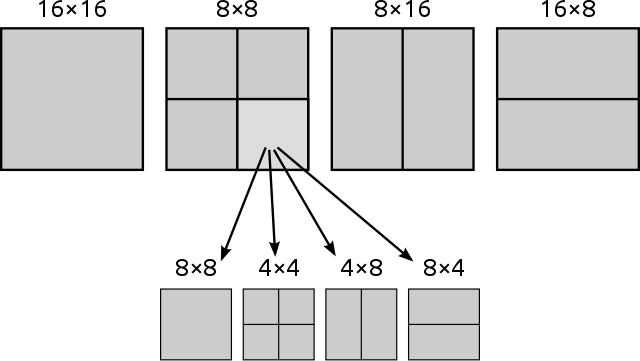
之前的标准中,宏块的划分方法是固定的,以16x16个像素为一个宏块。不过在新时代,这种粗放的划分方法不够灵活,于是H.264同时允许16x8、8x16、8x8、8x4、4x8和4x4这些精细度更高的划分方式。同时H.264将亚像素精度的运动补偿描述从1/2像素精度细化到了1/4的程度。这样一来,在帧间预测中新的编码拥有更高的精准度,但实际的数据量并不会增加太多,提高了压缩率。
数量更多的参考帧

在以前的标准中,每个B或P帧可参考的帧数是有限且数量过少的,H.264一举将限制放松到了16帧的程度,在大部分应用场景中,每帧的可参考帧数量至少都有4~5个,而在之前的标准中,P帧仅能参考1帧,B帧则是2。这一特性可以提高大多数场景的画面质量,或是降低体积。

更先进的帧内压缩
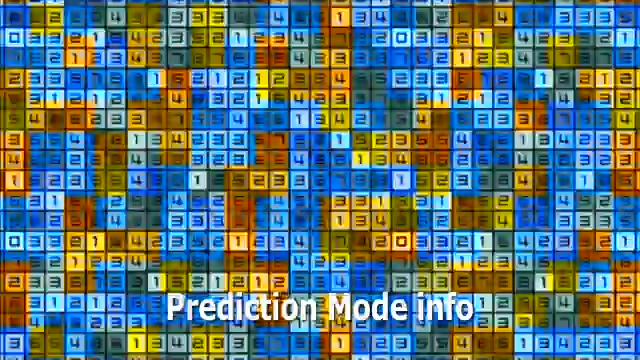
每个宏块包含的预测模式信息

对于I帧,H.264也引入了新的压缩方式。一般来说,对于图像中的某一像素点,它与附近相邻的像素的颜色是差距不大的,所以我们就可以利用这个特性进一步缩小单帧图像的大小,怎么利用呢?H.264将单个宏块内的像素颜色变化规律规范成了公式,编码时只要写此处应用哪个公式就行了。当然这里我表述的较为简单,完整的帧内预测还是非常复杂的,H.264对4x4的宏块规定了9种预测模式,对16x16的亮度平面宏块规定了4种可用模式。大大减少了单帧图像的数据量,同时保持了很高的图像质量。
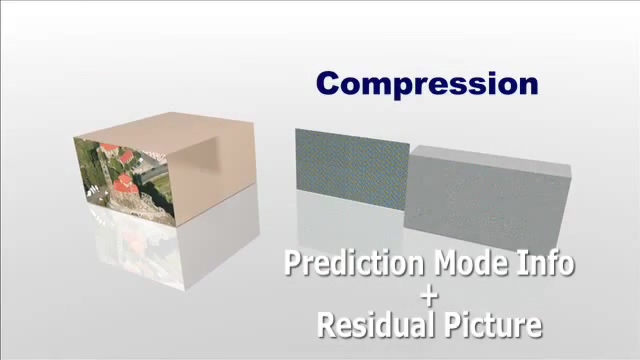
差分图像加上预测信息可以还原出原始图像

CABAC

在编码的最后阶段,对数据进行无损压缩时,H.264除了支持在H.261中就存在的VLC编码外,新增加了两种无损数据压缩编码,一种是VLC的升级版——CAVLC,另一种是复杂程度更高的CABAC(前文参考之适应性二元算术编码,Context-based Adaptive Binary Arithmetic Coding)。
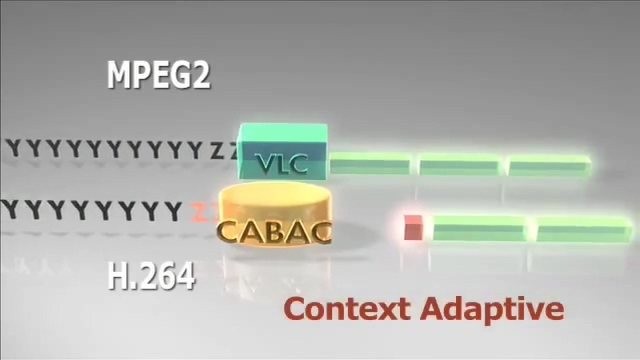
CABAC也是一种熵编码,主要原理也是用长编码替换掉出现频率少的数据,而用短编码替换出现频率高的数据,但它引入了更多统计学优化,并且具有动态适应能力。虽然在解码时需要更多计算,但它能够比CAVLC节省更多的数据量,通常能有10%。

小结:巨大的改变带来的是巨大的成功

除了以上介绍的几点外,H.264还有非常多的新特性,与MPEG-4 Visual不同的是,这些新特性有效地帮助H.264在节省容量方面取得了重大进展。这里我举一个有强烈对比的例子,DVD Video标准的视频,采用的是MPEG-2编码,码率约在9Mbps左右,但它的分辨率仅为720x480,而且在某些场景下我们可以很明显看到有损压缩产生的破坏;而同样的码率,放在H.264上面,已经可以承载起1080p的视频,并且拥有良好的质量。

除了在编码效率上有重大提升外,H.264针对网络传输的特性对编码组织方式进行了优化,让它更能够抗丢包,抗干扰。在种种手段之下,它成为了近十年来统治视频领域的编码,并且可以说它已经成为了HTML 5中的事实标准,现在你很难看到一件不支持H.264编码的设备,从手机到摄像机,从流视频到蓝光光盘,它的应用范围广,效能强,即使在新编码已经出现的当下,它仍然有很强的生命力和不可替代性,可以预见的是,H.264将在未来一段时间内继续统治视频编码领域。

VC-1:失败的挑战者

进入高清时代后,微软也顺应潮流,为WMV9进行了升级,加入了针对高清视频的新特性,让它能够胜任1080p级别的高清视频,新的编码即为VC-1。与H.264相比,VC-1总体的复杂程度要低一些,也因此在软解上对CPU更加友好。实际上VC-1也通过了国际组织SMPTE的标准化。

VC-1与HD DVD有一定的捆绑关系,在蓝光大战初期也通过这种方式得到了一定的推广。然而,随着HD DVD阵营的认输,VC-1也随之销声匿迹,很难再看到了。

UHD与流媒体时代,新的编码兴起

H.264很强大,但是它在超清时代有点不够用了。随着视频分辨率的跨越式提升,H.264表现出了疲态,它在应对4K视频时已经没有办法提供很好的压缩比了。很明显,人们需要新的编码来继承它的位置,而它的直接继承者——HEVC,在经过多年研究之后,终于在2013年被通过了。

HEVC/H.265/MPEG-H Part 2:视频编码王位继任者

HEVC,全称高效视频编码(High Efficiency Video Coding),同样的,它也是由MPEG和ITU-T联合制定的国际标准编码。被包含在MPEG-H规范中,是为第二部分(Part 2),在ITU-T那儿,它是H.26x家族的新成员,为H.265。

HEVC主要是针对高清及超清分辨率视频而开发的,相比起前代AVC,它在低码率时拥有更好的画质表现,同时在面对高分辨率视频时,也能提供超高的压缩比,帮助4K视频塞入蓝光光盘。

代替宏块的编码树单元

HEVC引入了新的编码树单元(Coding Tree Units)概念,取代掉了存在于视频编码中多年的宏块概念,它的单块面积大了许多,达到了64x64,但仍然保留了可变大小和可分割特性,最小单元为16x16。单个编码树中包含了小的编码单元,它们可以由四分树形式呈现,并很快地可以确定下其中的单元是否可被再分割,内部编码单元最小可以被分割为8x8大小,精细程度仍然是非常高的。

单个编码单元也可以继续被切割、分类,可以成为预测单元(Prediction Units),后者可以指示该单元的预测形式,是画面内预测还是画面间预测或者甚至是根本没有变化、可以被跳过的单元;也可以成为转换单元(Transform Units),它可以做DCT转换或是量化。

编码树单元的引入让HEVC既可以用大面积单元来提高编码效率,也可在需要的时候细化,保留更精细的细节。所谓该粗略的地方就粗略,该精细的地方就精细,HEVC在它的帮助下让码流的效率更高。

更高效的DCT

既然分块的最大面积大了,那么DCT算法也需要跟上才行,HEVC将DCT算法的最大尺寸扩大到了32x32的地步,对于图像中变化较为平坦的部分,它有着更高的压缩率。

33种帧内预测方向
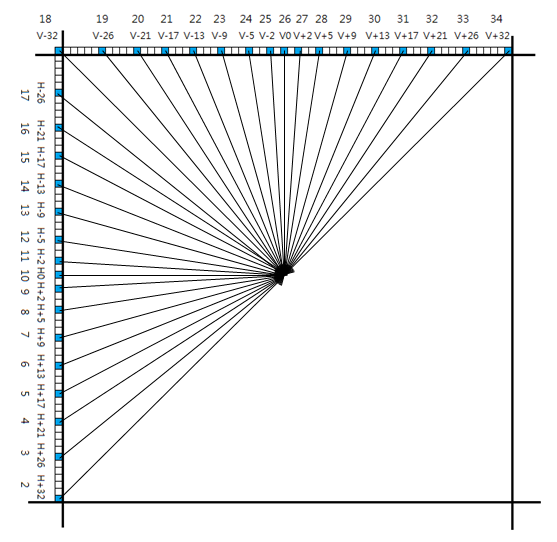
还记得上面写到H.264为4x4宏块引入了9种帧内预测方向吗?HEVC直接把这个数字提升到了33种,在静态图像的压制上不仅实现了更高的效率,也实现了更高的精度,这也是它成功杀入静态图像编码市场的一大利器。虽然编码难度变高了,但只要用硬件编码器就没有那么多问题。

小结:高效编码,但受困于高额专利费用

相较于AVC,HEVC在高分辨率下的编码效率又有非常大的提升,举个实例,同样一段4K视频,使用H.264编码的大小可能会比使用HEVC大出个一倍。这种巨大的进步幅度也使得Blu-ray直接用它作为标准编码,推出了UHD BD,而它在单帧图像压缩上面的改进也让它拥有胜过JPEG的能力,于是我们看到在移动端,越来越多的设备选择将其作为默认的视频、照片输出编码。

但是相比起AVC,HEVC的推广速度慢了很多,一个是它的编解码难度比H.264高了太多,但这点通过各路硬件编码器和软件优化逐渐化解掉了,目前常见的设备基本上支持HEVC的硬件编解码;第二个就是HEVC高昂的专利费用问题,它并不是一个免费的编码格式,虽然个人使用它完全没有问题,但对于想要兼容它的厂商来说,这笔高昂的专利费用足以让他们却步,尤其是崇尚自由开放的互联网市场。于是,我们看到众多厂商选择了免费开放的VPx系列编码,以及系列的后继者——AV1。

VPx系列与AV1:以免费为卖点

VPx系列编码实际上已经有很长的历史了。它的前身是On2 Technologies公司的TrueMotion系列视频编码,在开发TrueMotion VP8编码时,公司被Google收购了。在Google的介入下,VP8从原本的专有技术变成了开放技术,在BSD许可证下面进行开源。

从技术角度来说,VP8采用的技术是类似于H.264的。虽然在我们看到的宣传中,VP8拥有比H.264更佳的压缩效率,但在实际应用中,由于它在设计上有一定的瑕疵,表现并不如H.264,最终它虽然进入了Web标准,但也没见有人用它,反而是由它的帧内压缩技术提取而成的WebP受到了欢迎。

VP8的表现并不理想,Google很快就推出了它的继任者——VP9。这次,他们参考的是HEVC,设计目标同样是高分辨率下的高效编码。VP9中的一些设计是受到了HEVC的影响的,比如说同样最大为64x64的超级块(Super Block)。最终VP9达成的结果是提供了比VP8高达50%的效率提升。看起来它能够和HEVC比肩了,但是它也遇到了和VP8相似的问题,推广不开。VP9的应用范围实际也局限在Google自家的Youtube中,只能说是缺少实际应用场景。

但很快,一些厂商认识到HEVC高昂专利费用带来的弊端,他们决定创立一个开放联盟,推广开放、免费的媒体编码标准。这个联盟就是开放媒体联盟(Alliance for Open Media),创始成员有Amazon、Cisco、Google、Intel、Microsoft、Mozilla和Netflix这些我们熟悉的大公司,而后加入的还有苹果、ARM、三星、NVIDIA、AMD这些同样耳熟能详的公司。

Google将他们还在开发中的VP10贡献了出来作为联盟新编码的基础,很快,名为AV1的编码诞生了。在Facebook的测试中,它分别比VP9和H.264强上34%、46.2%,这次看上去是真的达到HEVC的级别了。

在这两年中,AV1也确实开始得到厂商们的重视,比如说最近Netflix已经确定了要使用AV1作为主力编码,而Intel也推出了开源免费的SVT-AV1编码器,充分利用自家的AVX-512指令集。但是这种联盟还是相当松散的,比如说联盟成员之一的苹果,目前对AV1根本是无动于衷,旗下设备中全部转向HEVC。

不过从Netflix决定使用AV1作为主力编码这种态度来看,AV1免费、开放的特性还是具有相当的吸引力的。但目前在硬件方面是缺乏对它的支持的,不仅是PC端没有针对AV1做硬件解码,数量更多的移动设备也没有适配,前不久刚有一款宣传是首个加入对AV1硬件解码的SoC才发布。对比起硬件支持较为齐全的HEVC,这将是AV1推广之路上的一道槛。

未来编码:VVC

目前MPEG和VCEG已经开始研究HEVC的继任者了,目前我们知道的信息是,它暂时被命名为Versatile Video Coding(多才多艺视频编码),并将会成为H.266。它是面向于未来视频的编码,将会支持从4K到16K分辨率的视频压缩,并且支持360°视频,它的目标是在HEVC的基础上将编码效能提升一倍。

未来它可能加入的新特性有:更为复杂的编码单元结构;更大、更细致的区块划分;全局帧参考;更多的帧内预测模式(目前已经有65种)……在复杂度上面,相比HEVC,VVC将会直接高出一个维度。但是国际标准目前面对着以AV1为代表的开放标准的挑战,很难说他们会不会取消掉部分特性,从而将它正式发布的时间给提前。

总结:与时俱进

显示器、电视的分辨率越来越高,网络带宽越来越大,设备对于多媒体内容的处理能力越来越强,视频编码也一直随着时代的变化而不断进步着,但是它的框架从H.261开始就未曾有过重大的变化,只不过每个新编码都在这个既定框架下利用半导体性能的成长而加入新的更为高效的算法。比起进步并不明显的音频编码,新视频编码在带宽与容量上面提供的节约效果要明显得多了,甚至更新的编码在画质表现上也更有优势。在不远的未来,10-bit色深和HDR将会普及,在根本上取代掉还是上世纪标准的SDR内容,为我们带来更为精彩的视觉体验。诸如HEVC这样的编码实际早已做好了准备,在未来,它们的应用场景甚至将突破视频领域,就以新的苹果设备为例,HEVC实际已经成为它的标准编码格式,通行于图像和视频领域中。

另外,根据最新的报告,当前互联网流量中占大头的就是视频流量,随着流媒体继续深入日常生活,用于视频传输的流量只会更大,而互联网的总体带宽并不是可以无限提升的,对于内容提供方来说,流量费用也是相当一部分开销,压缩效率更好的编码自然也会受到他们的青睐。实际上,编码不断升级这件事情是双赢的,用户和内容提供方都可以从中获利。

由于时间与作者个人能力限制,本篇文章也存在诸多的不足,但我仍然想通过对这些编码的概述让更多人了解到正确的编码知识,如果能够起到抛砖引玉的作用,让更多人对编码产生兴趣,开始自己的研究,那是最好不过的事情了。
从硬件编辑的角度解读Xbox Series X的规格

从硬件编辑的角度解读Xbox Series X的规格

在对外正式公开Xbox Series X这台主机74天之后,2月25日,Phil Spencer用一篇新的博文对外公布了这台次世代主机身上更多的细节,想必各位或多或少已经读过新闻了。不过普通玩家可能会对文章里面的很多名词感到陌生,什么Zen 2、RDNA 2、VRS……可能只看懂这台主机被吹上天了。本文就对这些名词简单进行一番介绍,顺便带出笔者作为一个硬件媒体编辑,对于这台主机的一些个人看法。让我们顺着Phil Spencer的文章脉络,一点一点来看。

硬件部分:Zen 2、RDNA 2、VRS、光追的简介

Phil Spencer首先介绍的是Xbox Series X使用的处理器——下一代定制处理器(Next Generation Custom Processor)。这枚处理器比今年CES展会上AMD发布的Ryzen 4000系列APU还要新,Phil Spencer其实早就已经剧透了这枚芯片的模样,在1月头上的时候,他把自己的Twitter头像给改成了这枚芯片的照片。

Xbox Series X上面使用的这枚“下一代定制处理器”中集成了CPU和GPU,CPU部分是这半年来PC市场上表现得非常好的Zen 2处理器,而GPU部分则是基于尚未公布技术细节的RDNA 2架构。那么这块芯片究竟有多强呢?

CPU:基于Zen 2,相对本世代主机有巨大提升

首先来看CPU部分,也就是Zen 2处理器。它是AMD近年来的最大翻身之作,在拥有相同核心数、相同频率的情况下它的综合性能已经可以比肩Intel最新一代的酷睿桌面版处理器(比如说,Ryzen 7 3700X的综合性能压了同为八核的i7-9700K一头,比i9-9900K稍弱),而它在玩家更看重的游戏性能方面也表现得相当优秀,基本上已经有对手90%的功力了。对比本世代主机上面那颗羸弱的Jaguar APU,那提升幅度只能用巨大来形容,原本CPU方面存在的严重短板将不复存在。

GPU:基于RDNA 2,性能可能约在RTX 2080与RTX 2080 SUPER之间

然后来看对于游戏更为重要的GPU。这里Phil Spencer给出了一个具体的数字——12 TFLOPS,这个数字代表的是GPU的单精度浮点运算能力,经常性被用来当作GPU的主要性能指标。但我们并不能单单看这个指标就说新主机的GPU性能会是Xbox One X的两倍,因为它只是一个理论值,实际性能还得看架构,而新主机的GPU架构恰恰就有着巨大的改变。RDNA架构是AMD完全重新打造的显卡架构,在游戏图形效能上面较沿用约八年的GCN架构有很大的提升。比如说,理论单精度性能比RX 580显卡(基于GCN 4.0架构,就是PS4 Pro和Xbox One X上的GPU架构)低1 TFLOPS的RX 5500 XT(基于RDNA架构),其实际游戏性能反而要比前者强。(对于RDNA与GCN架构的实际表现差异,Digital Foundry做过一期视频,有兴趣的可以去看一下:《Navi RDNA vs GCN 1.0: Last-Gen vs Next-Gen GPU Tech Head-To-Head!》)

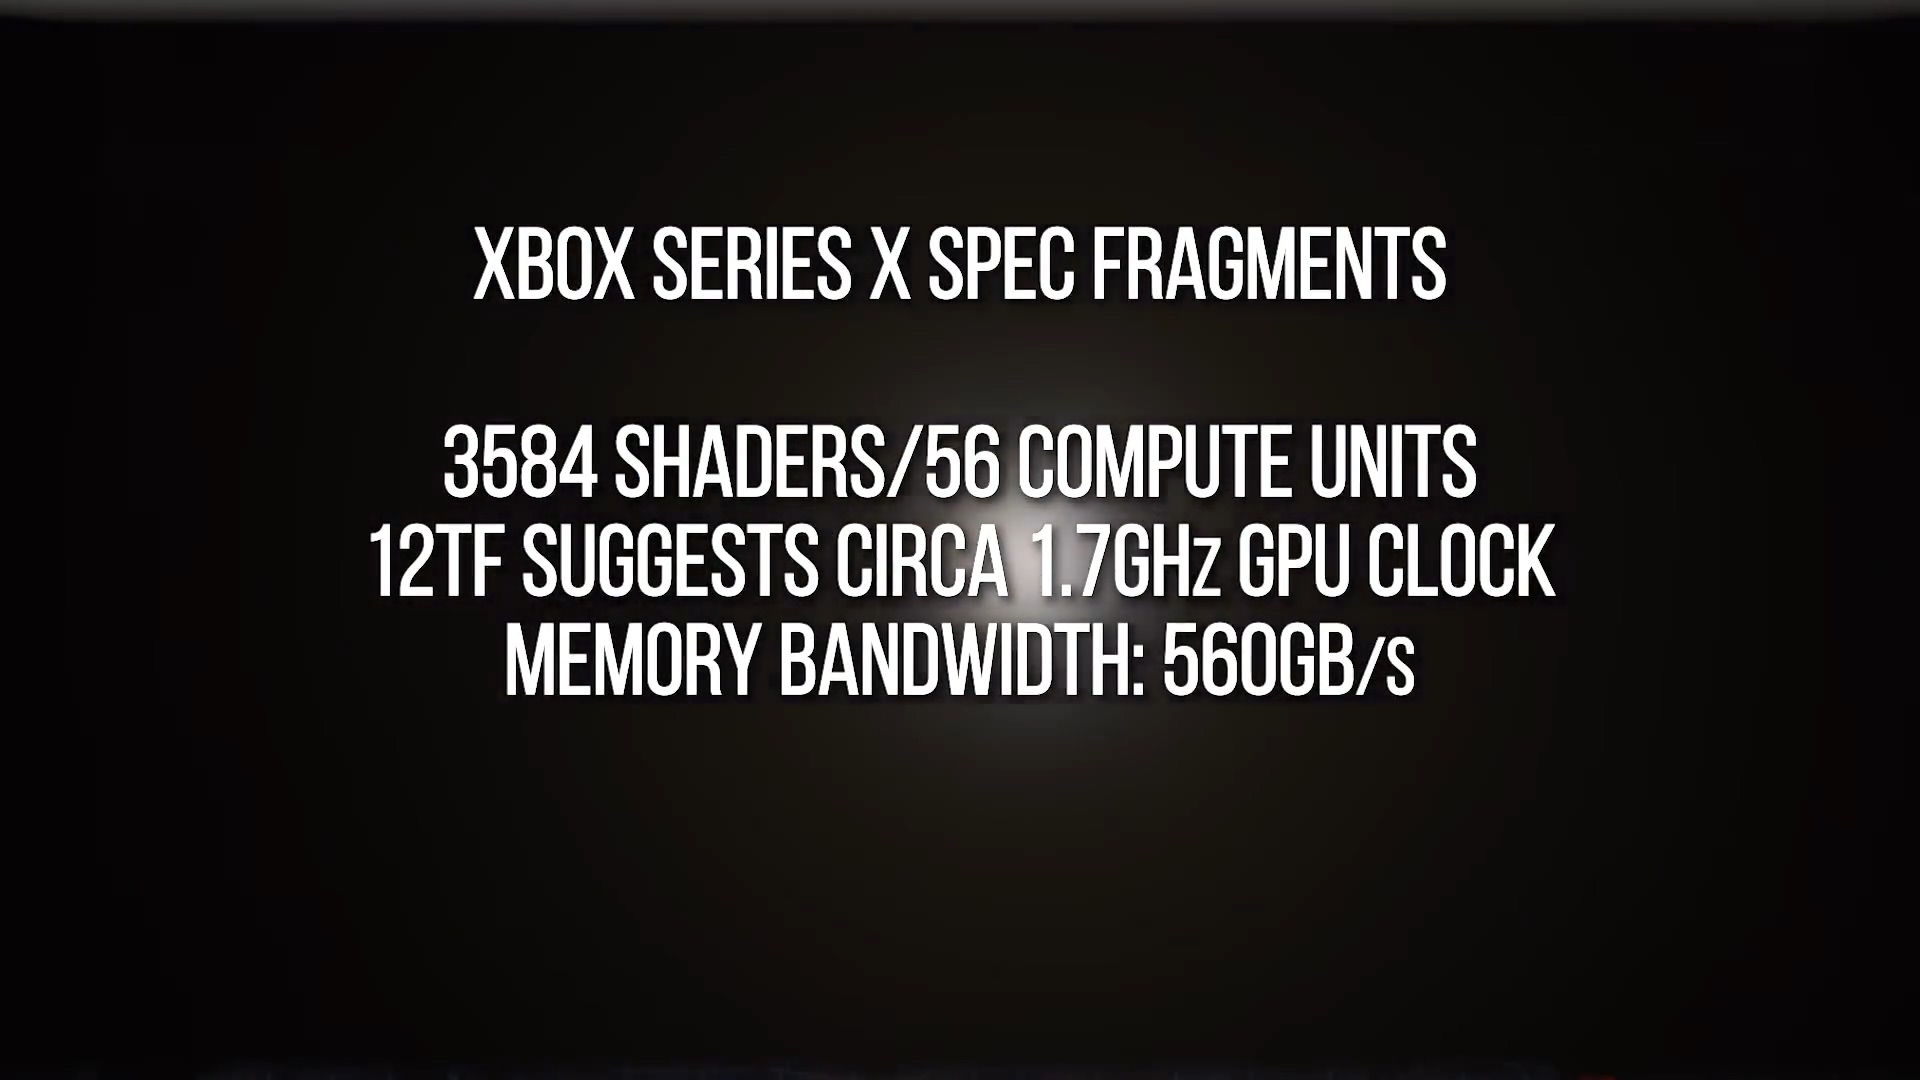
Digital Foundry推测中的Xbox Series X GPU规格
比较凑巧的是,此前的泄漏显示Xbox Series X的GPU将会集成56组计算单元(CU),Digital Foundry对这枚GPU的单精度浮点性能推算结果正好是12 TFLOPS,所以现在我们可以假设这枚GPU拥有56组CU,那么对比拥有40组CU的Radeon RX 5700 XT(目前RDNA架构的旗舰显卡),它的计算单元规模大了40%,这将会带来显著的性能提升。

因此我们有理由认为Xbox Series X上面的显卡将会比Radeon RX 5700 XT强上不止一个档次。如果放在PC市场来看,RX 5700 XT跟NVIDIA GeForce RTX 2070 SUPER差上半档左右,也就是说,如果不算上RDNA 2架构可能带来的效率提升,Xbox Series X的GPU性能可能会处于RTX 2080到RTX 2080 SUPER之间,这是笔者的保守估计。

RDNA 2带来的VRS和光线追踪支持

新的图形架构带来的不单单是性能方面的提升,在功能性上也终于追上了这个时代,加入了VRS(Variable Rate Shading,可变速率着色)和光线追踪的支持。对于后者,我们见到了它在游戏中的实际表现,而VRS是什么东西呢?

可变速率着色

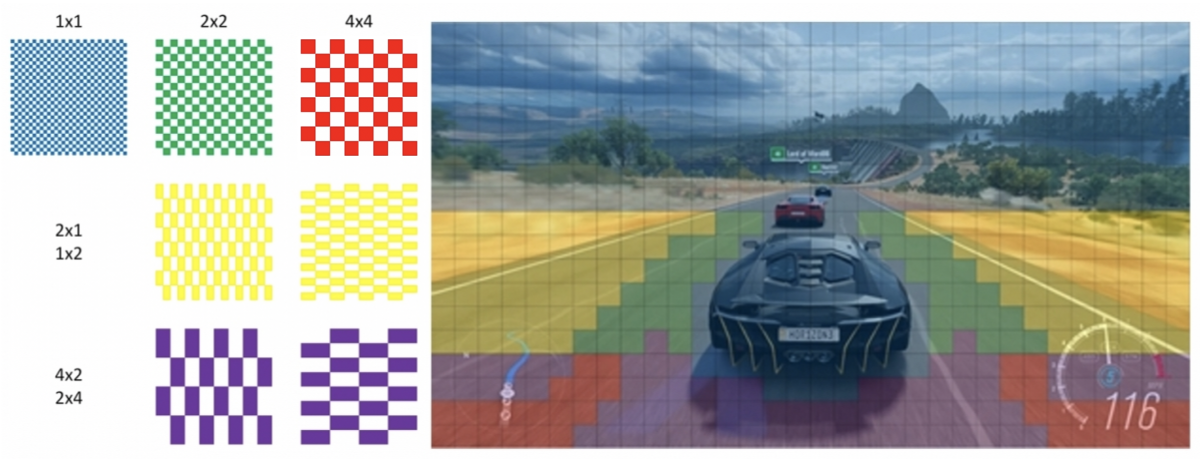
VRS的原理是通过改变单次像素着色器操作所处理的像素数量,来改变屏幕不同区域的着色质量。简单来说,它可以改变同个画面中不同部分的渲染精细度,它的用处是提高画面帧数。我们还是拿NVIDIA的那张示意图来举例:

在不开启VRS的情况,也就是正常情况下,一帧画面的所有像素都是独立着色的;而开启VRS之后,原本独立的像素被分成了一个个像素块,它们会共享着色结果,此时GPU会根据程序员设定的重要性分级为所有像素块分配不同的着色精细度。拿上面的图片为例,车辆和远景部分的像素仍然是独立着色的,但快速变动的道路和路边的像素块就是区块共同着色的,此时由于显卡的计算资源得到了节约,所以游戏的帧数会有所提高。

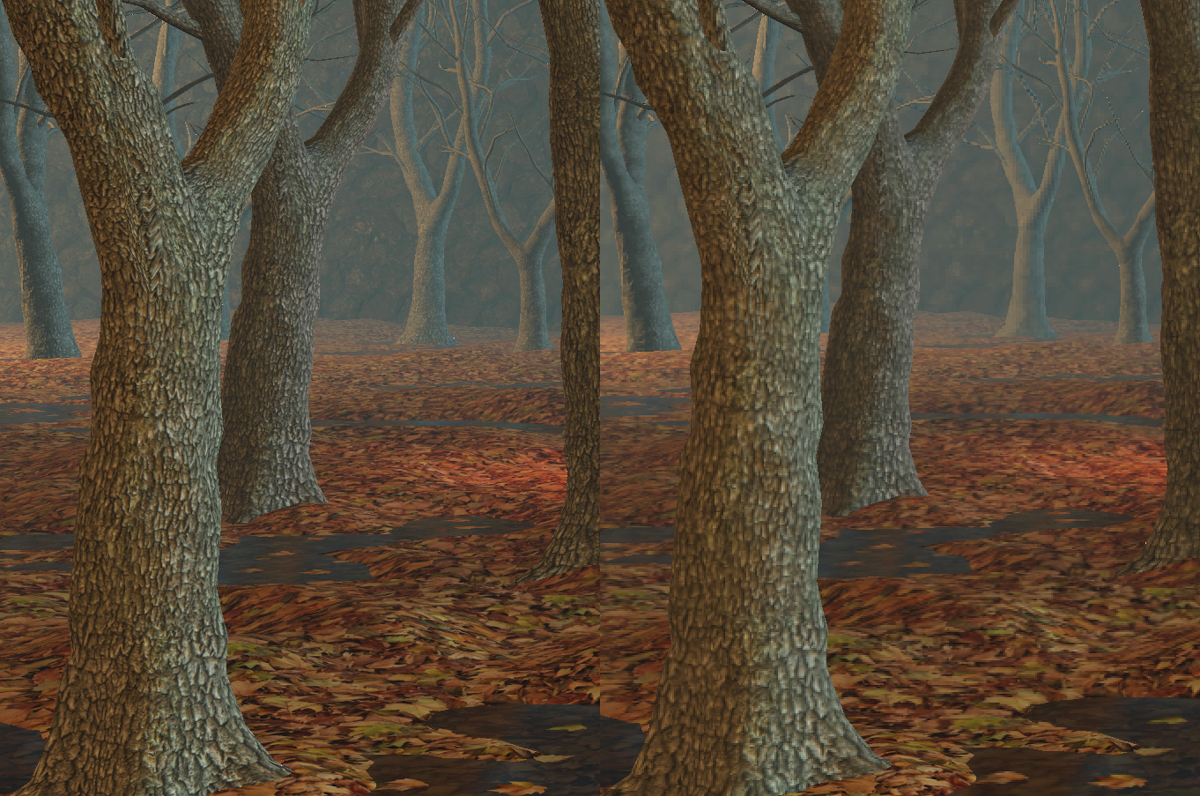
目前3DMark已经引入了VRS相关的测试,在该软件的测试中,VRS分为两级,在Tier 1测试中,你会发现画面整体的精细程度都变差了,这是因为整个画面的着色速率都被降低了。

左:VRS关;右:VRS开

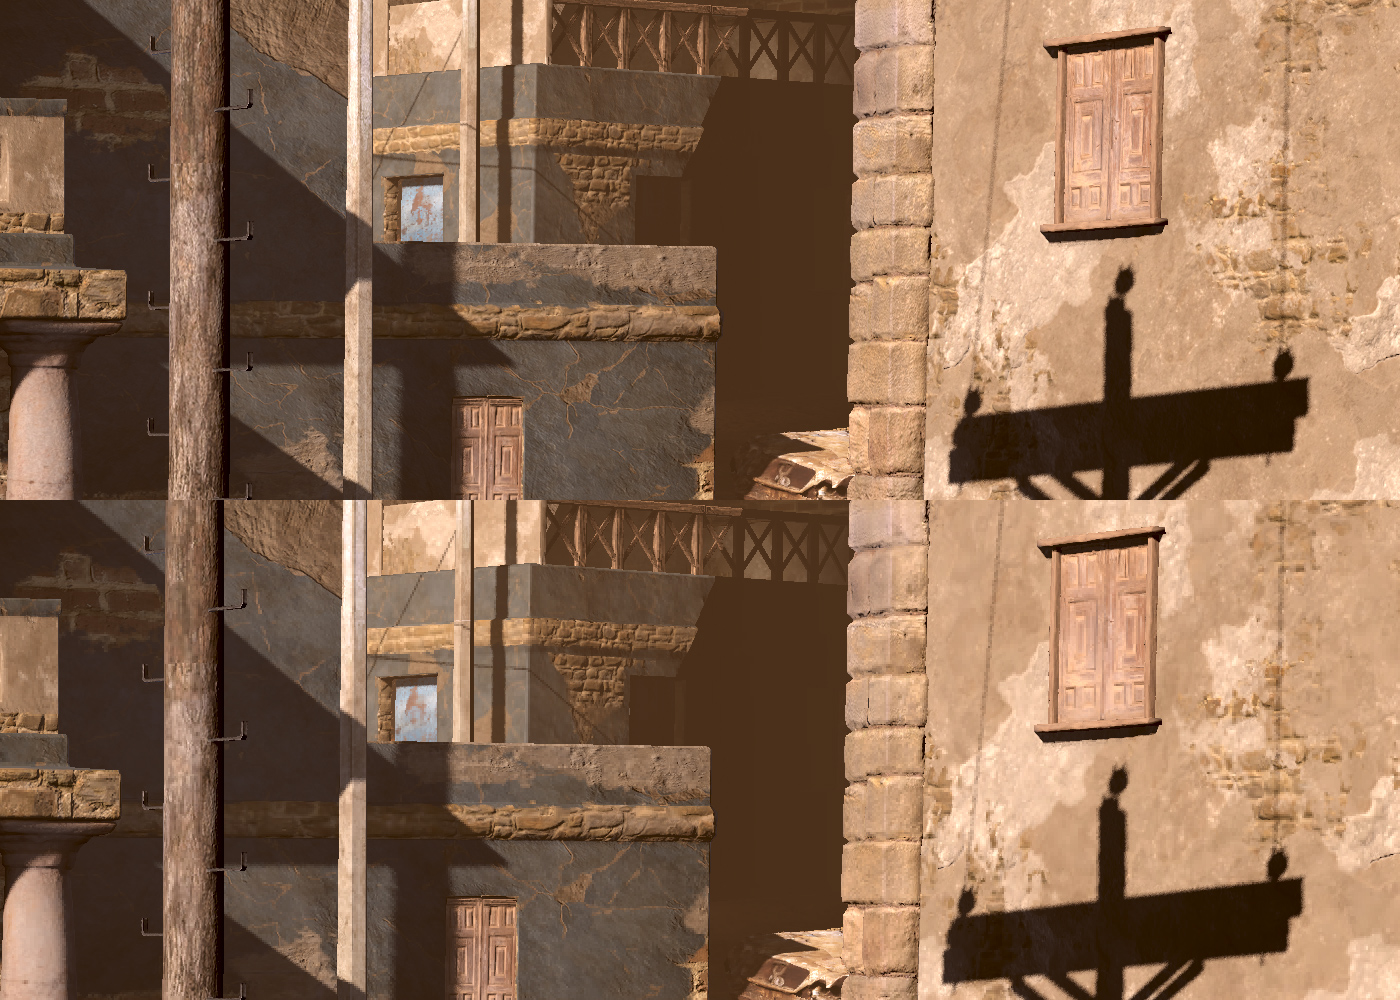
而在完整的Tier 2特性下,才会像上面所说的那样对整个画面进行分区,此时的效果就好了太多:

上:VRS关;下:VRS开。现在区别就小了很多。

这项技术最大的意义就是提高帧数,而且分辨率越高它的作用越明显。在3DMark的测试中,一张公版RTX 2070在1080p分辨率下的帧数提升为24.43%,而在4K分辨率下,提升幅度已经达到70.84%,在8K下面更是有116.62%的提升,直接从18帧幻灯片变成了40帧基本流畅的水平(数据来源:超能网)。

这项功能是由NVIDIA最先在Turing GPU上引入的,Intel也在他们的Gen 11核显上面加入了这项特性,我们也终于将在RDNA 2架构中看到AMD方面的支持。所以,这项技术是Xbox Series X实现8K游戏的一大技术利器,如果运用得当,我们将会在不牺牲过多画面质量的情况下得到更为流畅的画面,或是享受到更高分辨率的画面。

硬件光线追踪支持

微软家嘛,肯定会用自己的DXR API作为光追的入口啦。官方也明确说了这是基于硬件加速(Hardware-accelerated)的光线追踪支持,所以很明确的一点就是RDNA 2架构中将会加入新的针对光线追踪的处理单元,一如当年Turing架构中的RT Core,用专用处理单元的形式为光追提供更好的支持。

这方面因为没有太多的信息,所以也没什么可说的。但有一个趋势是很明显的,那就是在主机端的推动下,未来支持光追的游戏将大幅变多。目前的PC市场上面也就只有NVIDIA在大力推光追,但实际收效并不明显,Turing推出一年多了也就只有寥寥十数款已发售游戏支持光追,其中很多游戏也只是浅尝辄止,没有完全应用光追的所有效果。这方面还是需要占据游戏业界主流地位的主机来推动。

功能性:快速恢复、DLI、HDMI 2.1、120fps、四代同堂以及智能分发

在硬件部分之后,Phil Spencer介绍了由新硬件带来的新功能和新特性,主要有SSD存储、快速恢复、延迟动态输入、HDMI 2.1、120 fps支持和四代兼容性、智能分发,对于这部分内容,我们分成一个个小点来看,首先是SSD以及在它支持下的快速恢复功能。

高速SSD带来的超快加载以及快速恢复

新主机将会用SSD这个事情实际上在去年就已经公布了,但我们不清楚的是新主机会用什么规格的SSD,是中端的“够用型”SSD呢还是高端的性能级SSD。现在Phil Spencer似乎暗示了Xbox Series X将会使用高端性能级SSD,因为他使用了“next-generation”来形容SSD。

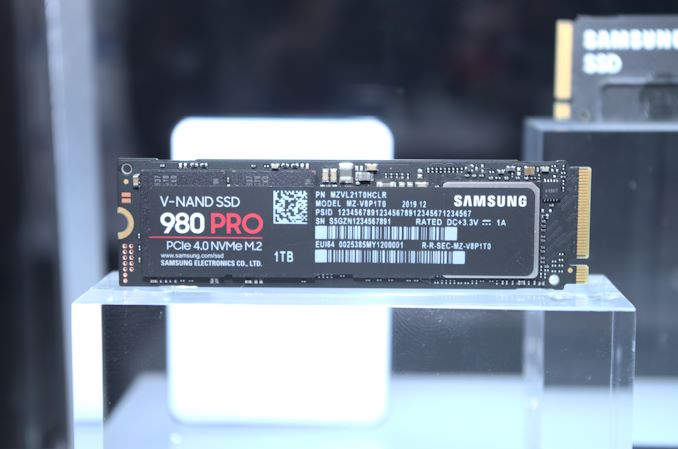
对于目前的SSD来说,什么是下一代呢?要么存储密度上有提升,要么是接口进入了下一代。恰好,新的Zen 2 CPU带来了新的PCIe 4.0总线,简单的说,它的速度是上代(PCIe 3.0)的两倍。而今年正好会有大量采用PCIe 4.0接口的SSD会上市,像三星就已经在CES 2020上面展出了他们的消费级PCIe 4.0 SSD——980 PRO。因此,完全有理由认为Xbox Series X上面的SSD将会使用PCIe 4.0接口来最大化读写性能。


三星980 PRO,支持PCIe 4.0,图片来自AnandTech

一个多月前,DigiTimes报道过一则群联打入Xbox供应链的新闻:

Phison has reportedly broken into the supply chain of Microsoft’s Xbox, while Silicon Motion has seen orders for home consoles with built-in SSDs surge.

我们可能会在Xbox Series X上面见到来自群联(Phison)的SSD,而现在的分析偏向于认为Sony将会在SSD上面和三星进行合作。

讨论完了SSD的可能性,我们来看由它提供支持的快速恢复功能,笔者个人猜测这项功能基于虚拟机快照技术。

常用虚拟机的朋友应该不会对快照这个常见功能感到陌生,它会把虚拟机目前的内存数据和运行状态保存成文件,在下次开启虚拟机/读取快照时就从保存好的文件里面读数据,直接恢复到快照保存时的状态。是不是听上去和官方描述的“几乎瞬间(almost instantly)”、“多个游戏(multiple games)”、“从冻结状态(from a suspended state)”很像?

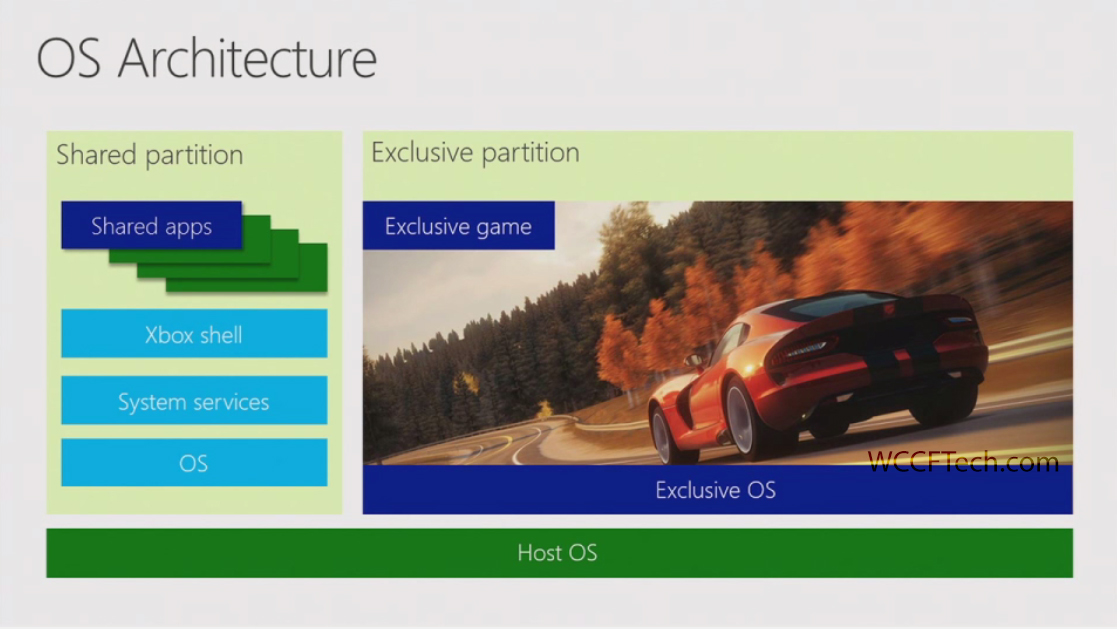
可能有些读者就有疑问了,虚拟机里面怎么打游戏?那就不用担心微软的技术力了,Xbox One的系统——Xbox OS已经应用了微软自家的虚拟机技术,游戏和系统是分别跑在两个虚拟机中的。Xbox Series X的系统基本上可以确定会沿用目前的Xbox OS,所以这套成熟的虚拟机体系也将会被沿用。而此前因为HDD的读写速度不够而没法启用的快照功能自然就可以用了。

动态延迟输入(DLI)

在使用无线游戏手柄的时候,有一点是无法忽视的,那就是延迟问题。我们这些普通玩家可能没什么感觉,但在高手眼中,这点延迟就已经会造成手眼不同步。原本微软用来连接手柄的就是他们自己开发的一种专有无线协议了,这次他们新引入了动态延迟输入特性,在寥寥一句话的介绍中也智能推测出这是一个用于同步用户输入与显示输出的特性,既然名为动态,那么可能就是根据输入端的连接延迟在输出上面做相应的补偿来保证手眼同步。

HDMI 2.1

HDMI是主机上面常见的用来输出画面的接口,其最新版本为HDMI 2.1,相对于HDMI 2.0,它不仅仅提高了最大支持的分辨率和帧率,更引入了多种新的特性,其中Phil Spencer重点提到了自动低延迟模式(Auto Low Latency Mode)和可变帧率(Variable Refresh Rate),其实这两种特性在目前已经得到了大范围运用了,只不过HDMI 2.1是将其标准化了。

8K@60fps、4K@120fps

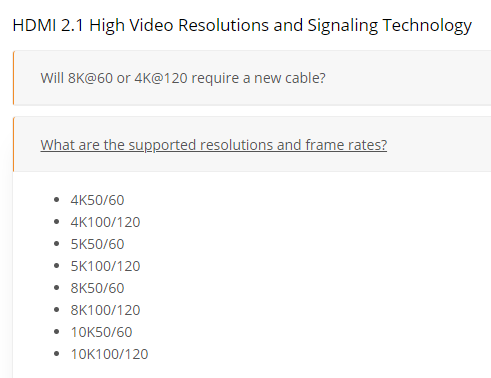
HDMI 2.1一举将接口的最大传输速率提升了2.67倍,从18Gbit/s直接提升到48Gbit/s,并且加入了在DisplayPort上面已经成功运用的DSC压缩技术,从而将最大可传输分辨率提升到了10K的高度。不管分辨率是4K、8K还是10K,HDMI 2.1都可以提供最高120Hz的传输帧率,为Xbox Series X的120fps提供了坚实的保障。

可变帧率(VRR)

说到可变帧率,PC玩家肯定是不陌生的,这项特性是用来让显示器的刷新率与显卡输出的画面帧数保持一致,减少画面撕裂现象出现的。目前PC上面有FreeSync和G-SYNC两种方案,前者是AMD主推,并且与DisplayPort接口中的Adaptive-Sync相兼容,目前相关的产品更多;而后者则是NVIDIA主推,但已经推出G-SYNC Compatible对FreeSync做了兼容。

早在2016年,FreeSync就已经可以跑在HDMI接口上了,而近来也有LG的一系列OLED电视机支持搭配N卡开启G-SYNC Compatible,用的也是HDMI接口,未来支持可变帧率技术的电视机将会越来越多,只要他们支持HDMI 2.1 VRR特性,Xbox Series X即可兼容并开启可变帧率模式,为玩家带来更加顺滑的画面,减少撕裂。

自动低延迟模式(ALLM)

实际上Xbox One就已经支持自动低延迟模式,听过AOC电视那期广告节目的应该会记得,电视机的延迟是远高于显示器的,但现在很多电视机厂家都在着重优化这一块,尽量降低内部延迟,为游戏玩家提供更好的体验。而ALLM特性就可以自动进行延迟优化。

根据HDMI官方的说法,ALLM可以简化玩家的操作。在需要时,主机会向电视机发送一个开启低延迟模式的信号,而在不需要时也能够自动关闭掉这个模式以恢复电视内置的画面优化。

其他

实际上HDMI 2.1还引入了很多增强游戏体验的特性,像快速媒体切换和快速帧传输都是崭新的面向游戏应用的特性。前者用来减少在内容之间切换的空白屏幕时间,后者则可以让图像帧更早的到达电视机进行处理,减少Lag情况。

120 fps支持

主机端锁60帧是很常见的事情,但我们应该有点更高的追求。近年来高刷新率显示器的流行让很多PC玩家都认识到原来60帧真的束缚住了我们的视觉体验。其实在手机业界也是一样的,更高刷新率的屏幕可以明显带来更好的观感。本世代的主机可能限于机能问题只能锁60帧,但是对于硬件规格上有巨大飞跃的新主机而言,真的可以抛弃掉锁60帧这个传统了,于是Phil Spencer也写明了,在Xbox Series X上面,帧数上限被拉高到了120帧。再加上强悍的硬件能力支持,以及各路保障视觉体验的特性,在下个世代,玩家的视觉体验提升将不局限于分辨率和画面质量,更是在帧数,画面顺滑度和体感延迟上都会有很大的提高。

四代同堂和智能分发

四代同堂就不用多说了,微软在Xbox的兼容性上面一向是非常良心的,它为新入坑的玩家提供了一个用来回顾老游戏的非常方便的入口,只要有兴趣就可以用一台主机玩前后接近二十年的游戏,甚至不用重复购买。

重点来看智能分发。

有印象的读者可能还记得,在一月中旬的时候Xbox游戏工作室的主管Matt Booty在接受采访的时候确认Xbox Series X将没有独占游戏。给这点带来保障的就是新的智能分发技术,买一次即可在两代主机上游玩,并且有相应的优化版本,还得到了CDPR这个第三方的响应。本身Xbox第一方15个工作室的作品都会采用这种分发模式,再加上第三方的支持,在未来两年中老玩家在老平台上面玩到新游戏应该不是什么困难的事情。

能怎么说呢?Xbox牛逼就完事了。

总结:用户体验至上,核心即为游戏

总的来说,目前官方透露出来的Xbox Series X是一台硬件配置强悍,功能特性着重为玩家服务的次世代游戏主机。还记得本世代初期,Xbox One的惨败吗?很明显,Xbox团队吸取了经验教训,他们不再想做一个有游戏功能的客厅机顶盒,而是专注于游戏,为玩家带来最好的游戏体验。而在本世代中期开始转变的营销思路也得以延续,Xbox现在卖的是服务,Xbox Game Pass得到大家的追捧是因为它很实在,游戏又多又新,而微软也很清楚,订阅制服务实际上是更赚钱的(看看Office 365就知道了)。想要吸引更多的玩家买他们的服务首先要把硬件基础给搞好,于是Xbox Series X就诞生了。